 JevCode
Búsqueda línea por línea
Construir búsqueda semántica para los Términos de Servicio de GitHub. En una sola solicitud, puntuar 218 line ids contra una consulta en lenguaje sencillo con una pregunta de tipo Choice, y usar una pregunta de tipo Noul para verificar si el documento contiene una respuesta.
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

Tienes los Términos de servicio de GitHub y una pregunta en lenguaje claro sobre ellos. Necesitas las líneas que respondan a la pregunta y una forma de detectar cuándo el documento no tiene respuesta. Las consultas incluidas clasifican las líneas con respuestas directas primero. Los umbrales exists clasifican los casos restantes como faltantes o parciales. Terminas con find(), que devuelve la probabilidad exists y una puntuación de relevancia por línea.
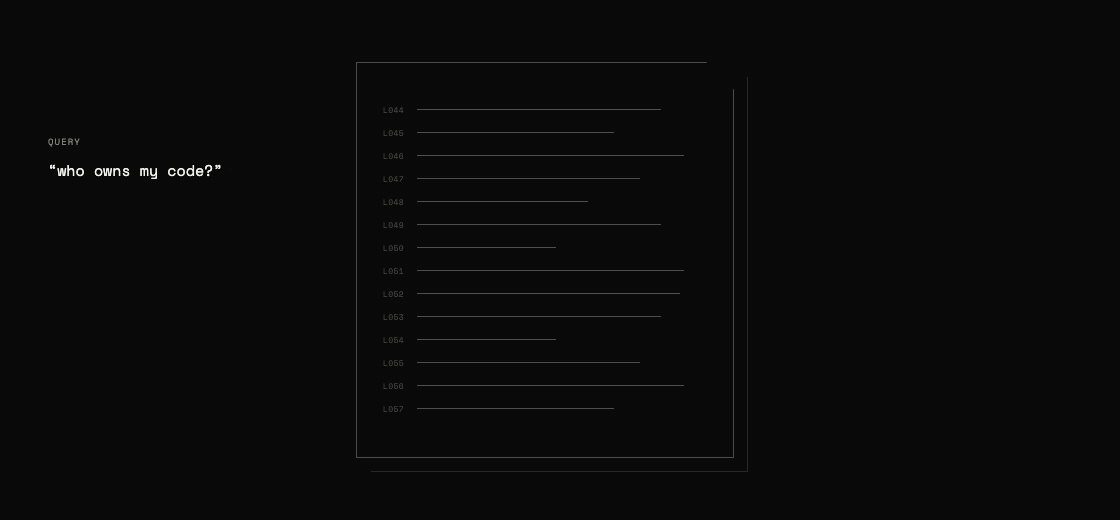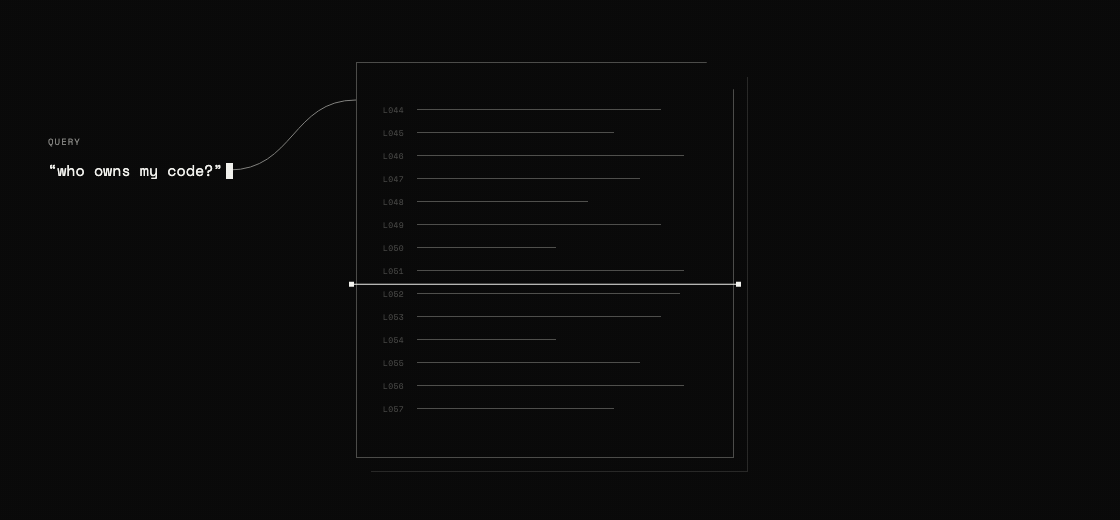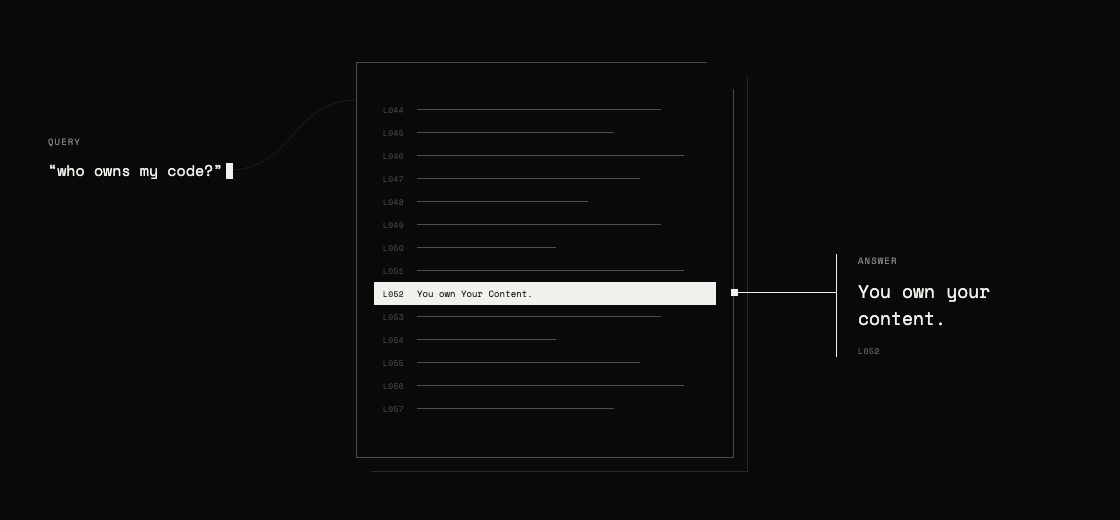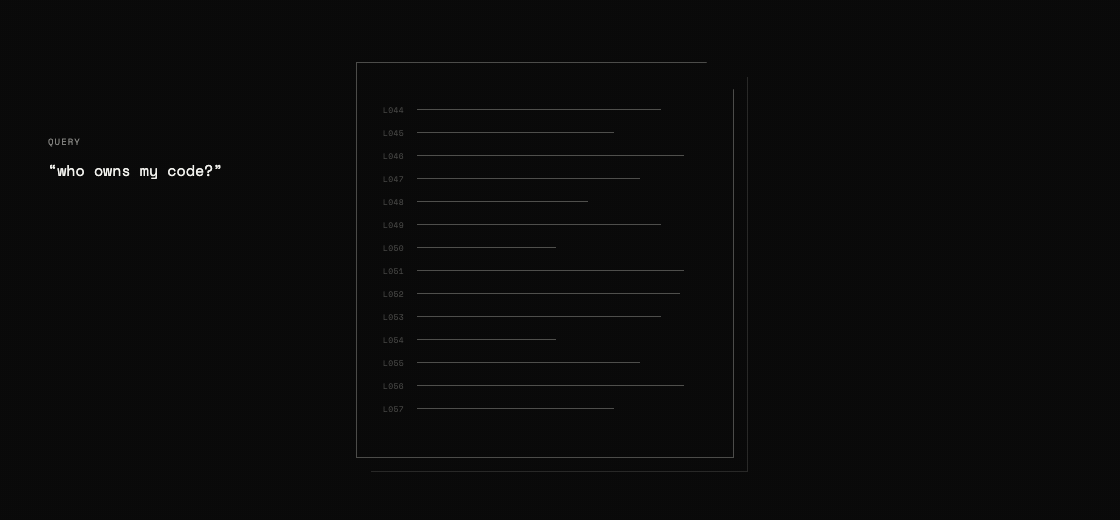
El backend de búsqueda se compone de tres partes:
- Etiqueta cada línea con un ID para que TypeSafe pueda señalarla.
- Usa una pregunta
Choicepara clasificar esos IDs de línea según qué tan bien responden a la consulta. Las probabilidades de las preguntas de opción múltiple siempre suman 1, por lo que una línea se clasifica primero incluso cuando ninguna responde a la consulta. - En la misma solicitud, usa una pregunta
Noulpara verificar si el documento contiene una respuesta.
Configuración
Obtén una clave de API TypeSafe
Crea una clave en la consola de TypeSafe y expórtala:
export TYPESAFE_API_KEY="your-key-here"Instalar las dependencias
pip install "typesafe-sdk>=0.5.7" cooksafe \
  --extra-index-url https://pypi.typesafe.ai/
JsonCache reproduce las respuestas de la API incluidas, por lo que los pasos siguientes se ejecutan sin clave de API
ni gasto alguno. Para que las solicitudes sean reales en lugar de simuladas, establece TYPESAFE_API_KEY y elimina
json_cache.json.
Crear el script
Comienza semantic_search.py con las importaciones y el cliente:
import os
import urllib.request
from pathlib import Path

from cooksafe import JsonCache
from typesafe_sdk import Choice, Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"

client = TypeSafeClient(
    api_key=os.environ.get("TYPESAFE_API_KEY", "cache-only"), timeout=120.0
)
json_cache = JsonCache(Path("json_cache.json"))
Paso 1: etiqueta cada línea con un ID
El documento de prueba es los Términos de servicio de GitHub, divididos en 218 cláusulas, por lo que cada resultado de búsqueda apunta a una línea citable.
Añade a semantic_search.py:
GIST = (
    "https://gist.githubusercontent.com/eugene-shvarts/900632789a24983d5678ffd508dd01f6"
    "/raw/cf9c2ab422d568deade949ef0a06bed6896964b9/github-tos.txt"
)


@json_cache
def fetch_document(url: str) -> str:
    request = urllib.request.Request(
        url, headers={"User-Agent": "typesafe-cookbook/1.0"}
    )
    with urllib.request.urlopen(request) as response:
        return response.read().decode()


LINES = fetch_document(GIST).splitlines()
La caché evita descargas repetidas, y splitlines() deja una lista de 218 cadenas.
Ahora, anteponga a cada línea un identificador corto y vuelva a unir las líneas en un único documento. El modelo utiliza estos identificadores para señalar su respuesta.
def line_id(i: int) -> str:
    return f"L{i:03d}"


DOCUMENT = "\n".join(f"{line_id(i)}| {line}" for i, line in enumerate(LINES))
DOCUMENT ahora se ve así:
L052| You own Your Content. If you post Content you did not create, you are responsible for...
L053| You grant us and other Users the licenses in Sections D.4–D.8. These licenses apply...
L054| 4. License Grant to Us
Paso 2: pregunta dónde está la respuesta
Una pregunta Choice devuelve una probabilidad para cada opción. Usa los IDs de línea como las opciones, y “elegir una opción” se convierte en “señalar una línea.”
def where_question(query: str) -> Choice:
    return Choice(
        instructions=f'Which line of the document contains the answer to: "{query}"?',
        criteria={line_id(i): None for i in range(len(LINES))},
    )
Las descripciones de las opciones son None porque el documento ya contiene el texto para cada ID. La consulta va en instructions; el estado permanece sin cambios entre las búsquedas.
Nota — Una pregunta
Choiceacepta hasta 255 opciones, por lo que esta receta busca documentos de hasta 255 líneas en una sola solicitud. Más allá de eso, busca en dos fases: una pregunta Choice selecciona un rango de líneas, y una segunda clasifica las líneas dentro de ese rango.
Paso 3: verificar si existe una respuesta
Las probabilidades de elección siempre suman 1, por lo que algunas líneas se clasifican primero incluso cuando el documento no responde a la pregunta. La clasificación por sí sola no puede distinguir una respuesta real de la línea irrelevante más cercana.
Entonces haz una segunda pregunta, en la misma solicitud:
def exists_question(query: str) -> Noul:
    return Noul(
        instructions=f'Does any line of the document address or answer: "{query}"?',
        criteria=NoulCriteria(
            true="At least one line of the document states or directly implies the answer",
            false="No line of the document addresses this",
        ),
    )
A diferencia de las probabilidades de Choice, la probabilidad de Noul no depende de las otras opciones, por lo que puede caer cerca de cero cuando el documento no tiene respuesta.
Paso 4: enviar ambas preguntas en una sola solicitud
El método system_one responde ambas preguntas en un solo pase. El estado se envía una vez, por lo que añadir la comprobación de existencia requiere solo una pequeña cantidad de salida adicional.
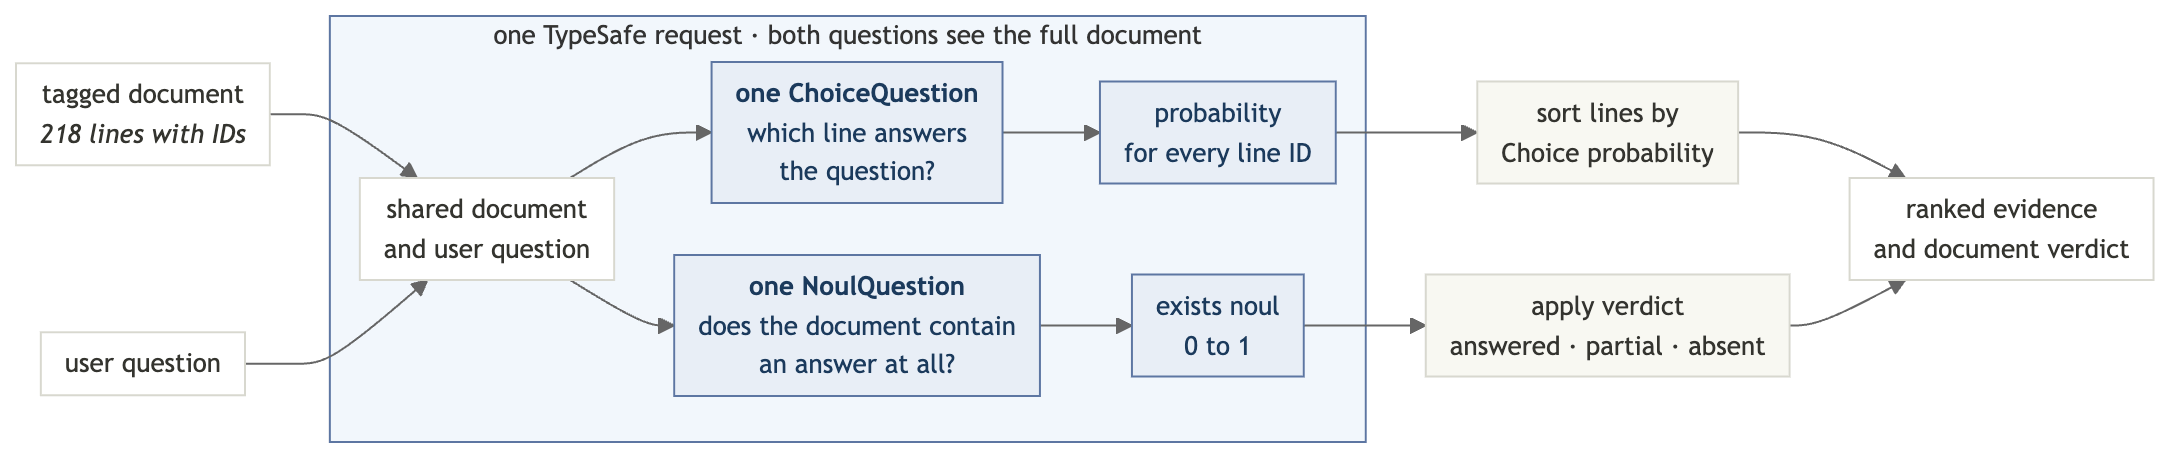
@json_cache
def _find(
    model: str,
    state: str,
    where: Choice,
    exists: Noul,
) -> dict:
    response = client.system_one(
        state=state,
        questions={"where": where, "exists": exists},
        model=model,
    )
    probabilities = response.answers["where"].probabilities
    return {
        "exists": response.answers["exists"].noul,
        "relevance": [probabilities.get(line_id(i), 0.0) for i in range(len(LINES))],
    }


def find(query: str) -> dict:
    return _find(
        TYPESAFE_MODEL,
        DOCUMENT,
        where_question(query),
        exists_question(query),
    )
La lista relevance mantiene una puntuación por línea, en orden del documento.
Paso 5: leer el resultado
Dos fragmentos de código local completan la tarea: verdict() convierte la probabilidad bruta de exists en tres estados, con uno intermedio para respuestas parciales, y show() renderiza relevance como un gráfico de barras para que el ranking sea legible en una terminal.
FOUND, ABSENT = 0.7, 0.35  # present answers typically read >=0.9, absent <=0.05


def verdict(exists: float) -> str:
    if exists >= FOUND:
        return "answered in this document"
    return "not in this document" if exists < ABSENT else "partially addressed"


def show(query: str, top: int = 4) -> dict:
    result = find(query)
    print(f'"{query}"')
    print(f"  exists {result['exists']:.2f} -> {verdict(result['exists'])}")
    ranked = sorted(
        range(len(LINES)), key=lambda i: result["relevance"][i], reverse=True
    )
    for i in ranked[:top]:
        bar = "#" * max(1, round(result["relevance"][i] * 12))
        preview = LINES[i][:58].rstrip()
        print(f"  {line_id(i)}  {result['relevance'][i]:.2f}  {bar:<12}  {preview}")
    return result
Estos umbrales separan los ejemplos siguientes, pero ajústalos en función de tus propios documentos antes de utilizarlos en producción.
Paso 6: ejecutar la búsqueda
Haz dos preguntas que tengan respuestas directas, una que no tenga respuesta y una que tenga una respuesta parcial, cuatro en total.
print(f"{len(LINES)} lines, {len(DOCUMENT):,} characters\n")
show("who owns the code I upload?")
print()
show("can GitHub kick me off the platform without warning?")
print()
show("do I have to take disputes to arbitration?", top=2)
print()
show("can minors use GitHub with parental permission?", top=2)
218 lines, 43,980 characters
"who owns the code I upload?"
exists 0.98 -> answered in this document
L052 0.95 ########### You own Your Content. If you post Content you did not crea
L046 0.02 # Short version: You own content you create, but you allow u
L051 0.02 # 3. Ownership and License Grants
L217 0.01 # Questions about the Terms of Service? Contact us through t
"can GitHub kick me off the platform without warning?"
exists 0.97 -> answered in this document
L168 0.97 ############ GitHub has the right to suspend or terminate your access t
L167 0.03 # 3. GitHub May Terminate
L000 0.00 # Effective date: April 27, 2026 · A. Definitions
L001 0.00 # Short version: We use these basic terms throughout the agr
"do I have to take disputes to arbitration?"
exists 0.14 -> not in this document
L205 0.86 ########## Except to the extent applicable law provides otherwise, th
L168 0.02 # GitHub has the right to suspend or terminate your access t
"can minors use GitHub with parental permission?"
exists 0.46 -> partially addressed
L029 0.90 ########### You must be age 13 or older. While we are thrilled to see
L012 0.07 # “User,” “You,” and “Your” refer to the individual person,Qué significan las puntuaciones
Las dos primeras consultas devuelven respuestas directas y las líneas de origen necesarias para verificarlas.
Los otros dos muestran por qué la comprobación de existencia es importante:
- Arbitraje: La clasificación otorga una puntuación de 0.86 a la línea más cercana, pero
existses solo 0.14. La respuesta no se encuentra en el documento. - Permiso de los padres: La regla de edad ocupa el primer puesto, pero no responde si el permiso de los padres modifica la regla. El resultado está parcialmente abordado.
El ranking te indica dónde buscar; la puntuación exists te dice si el resultado responde a la pregunta.
Pruébalo en tu propio documento
Abre el contrato etiquetado en el playground de TypeSafe para editar las preguntas contra el mismo texto. Para buscar el tuyo propio, intercambia la URL en fetch_document(); cada otra línea del script funciona con LINES.