 JevCode
Cascada SDE
Utiliza una cascada de extracción de datos estructurados en dos etapas (mini → verificar → razonamiento) para obtener la mayor parte de la calidad de un modelo de razonamiento grande a una fracción del costo.
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

- Resumen
- los modelos de razonamiento grandes extraen datos estructurados bien, pero son lentos y costosos
- los modelos pequeños son baratos, pero cometen errores
- una cascada obtiene la mayor parte de la calidad a una fracción del costo
- los modelos que usamos, y su precio ($ por 1M de tokens, entrada / salida; tarifas estándar verificadas el 15 de septiembre de 2026):
- escalón 0 (mini):
gpt-5.4-minia $0.75 / $4.50 - escalón 1 (razonamiento):
gpt-5.5a $5.00 / $30.00 (aproximadamente 7 veces el mini) - verificador: TypeSafe
jev-1.12a $0.042 / $0.00 (los tokens de salida son gratuitos; precios publicados de Jev) - Algoritmo
- Extraer con un modelo pequeño/barato.
- Verificar con primitivas de TypeSafe: una pregunta sí/no por campo (“pregunta Noul”)
- (por ejemplo, “¿este valor está ausente en la fuente?”, “¿fue extraído de texto no relacionado?”), cada una devuelve P(algo está mal).
- Escalar a un modelo de razonamiento costoso si se activa una señal del verificador; de lo contrario, mantener la respuesta barata.
- Este Cookbook
- recorre un ejemplo real de principio a fin, y luego muestra el compromiso a través de 100 prompts
- nota: los dos escalones de extracción usan el modo de texto de OpenAI
- no usamos salidas estructuradas, llamadas a herramientas, ni modo json, porque:
- un error de seguimiento de esquema no es el error que esperamos que cometa un LLM (es fácil crear datos sintéticos para esto)
- si un LLM falla al seguir el esquema, casi siempre está muy confundido, por lo que la decodificación restringida no soluciona el problema subyacente
- ¡te animamos a probarlos!
Configuración
- instala las dependencias (el cliente verificador de TypeSafe se sirve desde el índice de paquetes de TypeSafe):
pip install openai datasets jsonschema ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/- luego establece
OPENAI_API_KEYyTYPESAFE_API_KEYen tu entorno
import json
import os
from pathlib import Path

import jsonschema
from cooksafe import JsonCache, make_playground_link
from datasets import load_dataset
from IPython.display import Markdown, display
from openai import OpenAI
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

MINI = "gpt-5.4-mini"  # rung 0: cheap + fast
REASONING = "gpt-5.5"  # rung 1: strong, run with reasoning_effort="high"
TS_MODEL = "jev-1.12"  # the TypeSafe verifier model
FIRE_T = 0.7  # escalate if any per-field P(wrong) exceeds this; also the "<== FIRES" display marker

oai = OpenAI()

ts = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"], timeout=30.0)
Paso 1: los datos
Elegimos un conjunto de datos de Hugging Face llamado scrapegraphai
SCRAPEGRAPHAI_REVISION = "4bb9fba1dff9181c5acdb60a5a26fea62fa54fe9"
row = load_dataset(
    "scrapegraphai/scrapegraphai-100k",
    revision=SCRAPEGRAPHAI_REVISION,
    split="train",
)[516]
schema = json.loads(row["schema"])
prompt = row["prompt"]
content = row["content"]

print(
    f"""
PROMPT
===========
{prompt}

SCHEMA
===========
{json.dumps(schema, indent=2)}

CONTENT
===========
{content}
""".strip()
)
PROMPT
===========
Find registration open date fall semester for New York University in New York, NY for the 2024-2025 school year.
SCHEMA
===========
{
"properties": {
"registration_open_date": {
"description": "The date that registration opens for the fall semester. MUST be in the format mm/dd/yyyy. For example, for a college in the 2024-2025 school year, it might be something like 09/05/2024. Return a blank string if you are unsure.",
"title": "Registration Open Date",
"type": "string"
},
"description": {
"description": "A brief description of the registration open date. For example, 'Registration opens for the fall semester'.",
"title": "Description",
"type": "string"
}
},
"required": [
"registration_open_date",
"description"
],
"title": "RegistrationOpen",
"type": "object"
}
CONTENT
===========
Skip to content Skip to current page navigation
[ ](https://www.nyu.edu/)
Search Site
[ ](https://www.nyu.edu/)
* [ Academics](https://www.nyu.edu/academics.html)
* [ Admissions](https://www.nyu.edu/admissions.html)
* [ Research](https://www.nyu.edu/research.html)
* [ University Life](https://www.nyu.edu/life.html)
* [ About](https://www.nyu.edu/about.html)
All NYU
# Mobile Navigation
[ ](https://www.nyu.edu/)
Search Site
* [Academics](https://www.nyu.edu/academics.html)
* [Admissions](https://www.nyu.edu/admissions.html)
* [Research](https://www.nyu.edu/research.html)
* [University Life](https://www.nyu.edu/life.html)
* [About](https://www.nyu.edu/about.html)
All NYU
Info for
* Back to main menu
* Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](http://home.nyu.edu/)
Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](https://home.nyu.edu/)
Search Site Search
# Events Calendar
Search Events
Apply Reset
* [About the Events Calendar ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar.html)
* [Events Calendar Tutorial ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar/tutorials.html)
* [Report issue or provide feedback ](https://nyu.service-now.com/sp?id=sc_cat_item&sys_id=7698dd2a98bcf4004c8c03063d84e274)
Search Filters Calendar
New York University
Equal Opportunity and Non-Discrimination at NYU - New York University is committed to maintaining an environment that encourages and fosters respect for individual values and appropriate conduct among all persons. In all University spaces--physical and digital--programming, activities, and events are carried out in accordance with applicable law as well as University policy, which includes but is not limited to its Non-Discrimination and Anti-Harassment Policy.
Unless otherwise noted, all content copyright New York University. All rights reserved.
* [Search](https://search.nyu.edu/)
* [Campus Map](https://www.nyu.edu/map.html)
* [Events](https://events.nyu.edu/)
* [Contact Us](https://www.nyu.edu/contact-us.html)
* [Give](https://www.nyu.edu/about/giving.html)
* [Copyright & Fair Use](https://www.nyu.edu/copyright-and-fair-use.html)
* [Privacy](https://www.nyu.edu/privacy.html)
* [Accessibility](https://www.nyu.edu/accessibility.html)
* [Feedback](https://www.nyu.edu/#feedback.html)
* [New York Campus](https://www.nyu.edu/)
* [Abu Dhabi Campus](https://nyuad.nyu.edu/)
* [Shanghai Campus](https://shanghai.nyu.edu/)
* [](https://facebook.com/)
* [](https://linkedin.com/)
* [](https://x.com/)
* [](https://instagram.com/)
* [](https://youtube.com/)- Esta fila es una página del calendario de eventos de NYU (“Fecha de censo de otoño 2024”):
- el esquema solo pide dos campos:
registration_open_dateydescription - el raspado de la solicitud capturó solo la navegación del calendario y el texto estándar: no hay fecha de registro, ni descripción
- ten en cuenta que el campo
descriptiondel esquema incluso incluye un valor de ejemplo (“La inscripción se abre para el semestre de otoño”) en su propia descripción de campo - por lo tanto, un extractor bien comportado debería rechazar inventar los campos que la página no contiene
- veamos si el modelo pequeño hace lo correcto!
Paso 2: extraer con el modelo mini (modo texto)
- nota:
gpt-5.4-minies muy estocástico con esta entrada – incluso entemperature=0inventa undescriptiondiferente en casi cada ejecución. Para un recorrido reproducible, codificamos la única fabricación canónica que el resto de este cuaderno explica (y que el verificador marca con P(error) > 0.8). Un pipeline real simplemente tomaríaextract(MINI, prompt, schema, content, temperature=0)directamente.
EXTRACT_SYSTEM = (
    "You extract structured data from documents. Return only values supported by the text. "
    "Follow any value format specified by the schema or its field descriptions."
)


# LLM and TypeSafe calls are cached to ``json_cache.json``, which ships with the cookbook, so
# re-rendering reproduces the published results with no API spend; delete the file to re-run live.
json_cache = JsonCache(Path("json_cache.json"))


@json_cache
def extract(
    model: str,
    prompt: str,
    schema: dict,
    content: str,
    *,
    reasoning_effort: str | None = None,
    temperature: float | None = None,
) -> dict:
    user = (
        f"{prompt}\n\nReturn ONLY a JSON object matching this JSON Schema:\n"
        f"{json.dumps(schema, indent=2)}\n\nDocument:\n{content}"
    )
    kwargs = {
        "model": model,
        "messages": [
            {"role": "system", "content": EXTRACT_SYSTEM},
            {"role": "user", "content": user},
        ],
    }
    if reasoning_effort:
        kwargs["reasoning_effort"] = reasoning_effort
    if temperature is not None:
        kwargs["temperature"] = temperature
    text = oai.chat.completions.create(**kwargs).choices[0].message.content
    # The prompt asks for ONLY a JSON object, so parse the reply as-is -- no regex fishing a
    # substring out of a malformed reply. If ``json.loads`` fails, treat it as an empty extraction
    # (the record-level analog of NaN): every field reads as absent, which the verifier flags and the
    # gate escalates -- the safe direction. Schema-following errors are rare here (see the overview).
    try:
        return json.loads(text)
    except (ValueError, json.JSONDecodeError):
        return {}


# Hard-coded canonical fabrication (see note above); a real pipeline would use extract(MINI, prompt, schema, content, temperature=0).
mini_record = {
    "registration_open_date": "",
    "description": "Registration opens for the fall semester",
}
print("mini extraction:\n", json.dumps(mini_record, indent=2))

# The record is a perfect fit for the JSON Schema -- and still wrong. Schema validation is necessary
# but not sufficient: it catches structural errors, never semantic ones. That gap is the whole point.
print("\nschema-valid:", jsonschema.Draft202012Validator(schema).is_valid(mini_record))
mini extraction:
{
"registration_open_date": "",
"description": "Registration opens for the fall semester"
}
schema-valid: True- El registro es válido según el esquema (la línea anterior imprime
True), pero es incorrecto: registration_open_datequeda en blanco, lo cual coincide con la página: indica que no hay fecha- pero
descriptiones fabricado: la página nunca describe una fecha de registro, por lo que mini inventa una plausible. Puede repetir el propio ejemplo del esquema, “El registro se abre para el semestre de otoño”, o narrar “…no se encontró en el documento” - una verificación con JSON-Schema no puede detectar esto. Un modelo económico produce fabricaciones seguras que satisfacen el esquema de este tipo, y detectarlas es tarea de un verificador semántico
Paso 3: verificar con TypeSafe
- el verificador es TypeSafe; para cada campo construimos una
Noulpregunta: - un sí/no estricto, enmarcado de modo que
true= algo está mal (escalar) - TypeSafe devuelve una
noulcalibrada =P(true)por pregunta, en una única llamada a system_one - el conjunto de preguntas:
- una cabeza holística
__overall__::judgeprincipal (“¿debería escalarse este registro?”). La calculamos y mostramos para contrastar un juicio global del registro con las cabezas por campo, pero el filtro en el Paso 4 no la utiliza – la escalación la impulsan las baterías por campo. - una batería por campo
- los campos no vacíos reciben el conjunto completo de cabezas
- los campos vacíos (null / “” / []) reciben únicamente la cabeza
absence_wrong - (la pipeline completa también tiene una cabeza
spuriouspara contenedores completos y una puntuacióndifficultyglobal; no se muestran aquí para mantener este recorrido en las dos cabezas de filtrado) - El Método TypeSafe: Descomposición
- Observa cómo todo se descompone programáticamente, esa es la forma de TypeSafe.
- La descomposición maximiza la inteligencia de cada prompt y hace que el algoritmo sea ajustable e interpretable.
-
# metric -> (question, NoulCriteria)
MAIN_QUESTIONS = {
    "name_desc_mismatch": (
        "Does the `extracted_field` fail to match the field at `path` or the `description` in the "
        "`field_spec`? If the `description` is empty, judge against the `path` alone.",
        NoulCriteria(
            true="the `extracted_field` does not match the field name or its `description`",
            false="the `extracted_field` matches the field name and `description`",
        ),
    ),
    "type_mismatch": (
        "Does the `extracted_field` violate the `type` declared in the `field_spec`?",
        NoulCriteria(
            true="the `extracted_field` violates the declared `type`",
            false="the `extracted_field` conforms to the declared `type`",
        ),
    ),
    "unreasonable": (
        "Is the `extracted_field` one that a reasonable person would not have extracted for this "
        "`field_spec`?",
        NoulCriteria(
            true="a reasonable person would not have extracted this value",
            false="the extraction is reasonable",
        ),
    ),
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    "off_target": (
        "Does the source text fail to genuinely report the thing the `field_spec` describes, so the "
        "value was pulled from incidental text?",
        NoulCriteria(
            true="the source does not genuinely provide this field -- the value was pulled "
            "from incidental text",
            false="the source genuinely reports this field",
        ),
    ),
    "incomplete": (
        "Does the `extracted_field` fail to capture a value the source supports (note whether the "
        "`field_spec` is `required`)?",
        NoulCriteria(
            true="the field is wrongly empty, null, or missing a value the source supports",
            false="the field captures the value the source supports",
        ),
    ),
    "format_violation": (
        "Does the `extracted_field` violate the format or constraints implied by the `description`, "
        "the schema `type`, and the extraction instructions (e.g. date format, units, enum membership)?",
        NoulCriteria(
            true="the `extracted_field` violates the implied format or constraints",
            false="the `extracted_field` satisfies the format and constraints",
        ),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text contain the "
    "information the `field_spec` describes, making the empty result wrong?"
)
ABSENCE_CRITERIA = NoulCriteria(
    true="a value was wrongly omitted", false="returning nothing is correct"
)

# The pipeline also asks one holistic, whole-record head: "should this be escalated?"
OVERALL_JUDGE = (
    "Is this extracted record an incorrect extraction -- some value unsupported by the source or "
    "not conforming to the schema, required information missing or wrong, or some field hallucinated -- "
    "so it should be escalated to a smarter model?"
)
OVERALL_JUDGE_CRITERIA = NoulCriteria(
    true="the record is an incorrect extraction",
    false="the record is a correct extraction",
)


def is_empty(v) -> bool:
    return v is None or (isinstance(v, (str, list, dict)) and len(v) == 0)


def field_spec(name: str) -> dict:
    """Minimal spec pulled from the schema (unwrapping anyOf/null for optional fields)."""
    p = schema["properties"][name]
    branches = p.get("anyOf") or []
    typ = p.get("type") or next(
        (b["type"] for b in branches if b.get("type") != "null"), "unknown"
    )
    return {
        "path": name,
        "type": typ,
        "description": p.get("description", ""),
        "required": name in schema.get("required", []),
    }


def build_questions(record: dict) -> dict[str, Noul]:
    """The verify question set: one holistic ``__overall__::judge`` head plus a per-field battery,
    keyed ``field::metric`` (mirrors build_verify_prompts)."""
    questions: dict[str, Noul] = {
        "__overall__::judge": Noul(
            instructions=OVERALL_JUDGE, criteria=OVERALL_JUDGE_CRITERIA
        ),
    }
    for name, value in record.items():
        spec = field_spec(name)
        if is_empty(value):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": ABSENCE_QUESTION,
                },
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            if metric == "type_mismatch" and spec["type"] == "unknown":
                continue
            questions[f"{name}::{metric}"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": question,
                },
                criteria=criteria,
            )
    return questions


@json_cache
def verify(record: dict) -> dict[str, float | str]:
    """Run the whole Noul battery over a record in one TypeSafe call; return ``{field::metric: P(true)}``."""
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": "Extract the structured record from this document",
        "source_text": row["content"],
        "schema": schema,
        "extraction": record,
    }
    questions = build_questions(record)
    answers = ts.system_one(state=state, questions=questions, model=TS_MODEL).answers
    return {qid: ans.noul for qid, ans in answers.items()} | {
        "playground_link": make_playground_link(state, questions)
    }
Ejecuta toda la batería sobre la extracción mínima
checks = verify(mini_record)
playground_link = checks.pop("playground_link")
display(
    Markdown(
        f"🔗 [Open this verification in the TypeSafe playground]({playground_link})"
    )
)

print(f"{'qid':<40}{'P(wrong)':>9}")
print("-" * 50)
for fld, p in sorted(checks.items(), key=lambda c: -c[-1]):
    flag = "  <== FIRES" if p > FIRE_T else ""
    print(f"{fld:<40}{p:>9.2f}{flag}")
qid P(wrong)
--------------------------------------------------
description::hallucinated 0.95 <== FIRES
description::off_target 0.85 <== FIRES
description::unreasonable 0.58
__overall__::judge 0.56
description::incomplete 0.16
registration_open_date::absence_wrong 0.14
description::format_violation 0.10
description::name_desc_mismatch 0.08
description::type_mismatch 0.02Abre esta verificación en el playground de TypeSafe →
- TypeSafe concentra la señal en los campos que realmente están incorrectos.
- Nuestros resultados están calibrados: altos en el campo que está mal, bajos en el campo que es correcto, medios en un campo que parece fuera de lugar sin ser claramente incorrecto
- Esto es lo que te ofrece un verificador typesafe frente a un juez brusco que pregunta “¿es buena toda esta parte?”
Paso 4: la puerta de escalación
- ahora nos condicionamos a
any_flag: escalar si cualquier indicador de campo superaFIRE_T(0.7, establecido arriba y compartido con el marcador<== FIRESen el Paso 3) - este es un condicionamiento de estilo
max(escalar si cualquier campo se activa), no una media, por lo que un único indicador rojo confiable es suficiente en lugar de ser diluido en el silencio
# any_flag is a per-field gate: the holistic __overall__ head is shown above but not part of it
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > FIRE_T
}
escalate = bool(fired)

print(
    f"any_flag gate (threshold {FIRE_T}): {'ESCALATE' if escalate else 'ACCEPT cheap result'}"
)
for qid, p in sorted(fired.items(), key=lambda c: -c[1]):
    print(f"  fired: {qid}  (P={p:.2f})")
any_flag gate (threshold 0.7): ESCALATE
fired: description::hallucinated (P=0.95)
fired: description::off_target (P=0.85)Paso 5: escalar al modelo de razonamiento
Dado que se disparó una señal, pagamos por el modelo fuerte (gpt-5.5, reasoning_effort="high")
final_record = (
    extract(REASONING, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)

print("mini      :", json.dumps(mini_record))
print("reasoning :", json.dumps(final_record))
print("\nfield-level diff (mini -> final):")
for name in mini_record:
    if mini_record[name] != final_record.get(name):
        print(f"  {name}: {mini_record[name]!r}  ->  {final_record.get(name)!r}")
mini : {"registration_open_date": "", "description": "Registration opens for the fall semester"}
reasoning : {"description": "", "registration_open_date": ""}
field-level diff (mini -> final):
description: 'Registration opens for the fall semester' -> ''- La mejora
- El modelo de razonamiento elimina la fabricación
description, devolviendo"" - Reconoció que la página nunca describe una fecha de registro, y se negó a inventar una
- La cascada convirtió una fabricación confiada y válida según el esquema en un campo vacío honesto
- Y solo gastó dólares del modelo de razonamiento en este único elemento porque el verificador se lo indicó
Paso 6: cómo se ve esto en 100 solicitudes
- Estos son resultados internos de TypeSafe, producidos con el método general anterior:
- el mismo bucle
extract → verify → escalate,gpt-5.4-mini → gpt-5.5-reasoning, puertaany_flagsobre los cabezales por campo, ejecutado sobre 100 prompts de scrapegraphai - la extracción de bajo costo de cada elemento se puntúa por TypeSafe; el umbral de la puerta (“corte”) se barre de 0→1, y cada configuración resultante se traza en el espacio (costo, calidad)
- el gráfico es una instantánea histórica; sus costos no se han recalculado a la tasa actual de Jev mencionada arriba
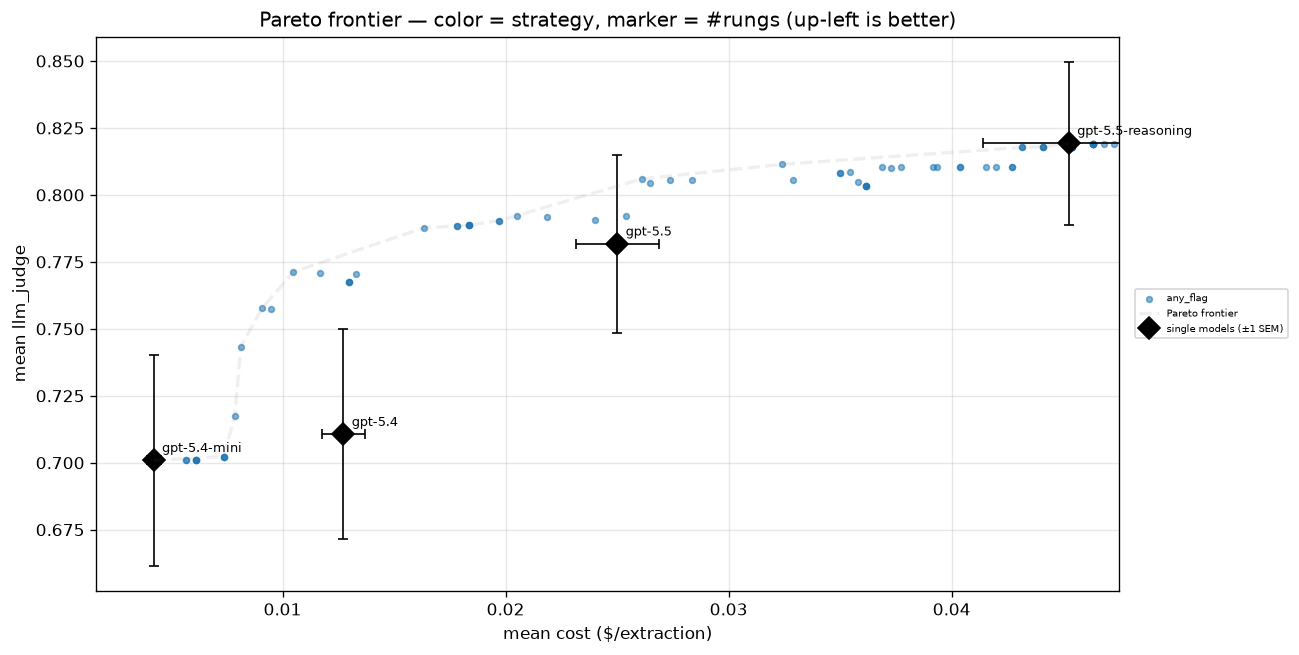
- cómo leerlo:
- diamantes negros = los cuatro modelos se ejecutan por separado (el coste aumenta con la capacidad; el más potente,
gpt-5.5-reasoning, se sitúa en la esquina superior derecha con ≈0.81 de calidad por ≈$0.10 de extracción) - puntos azules = la cascada en muchos umbrales de filtro; la línea discontinua es la frontera de Pareto
- la frontera de la cascada se sitúa arriba y a la izquierda de cada modelo individual: ajustar el filtro te compra la mayor parte de la calidad del modelo principal a una fracción de su coste
- el escalón más económico gestiona los elementos sencillos por un coste casi nulo, y solo los elementos marcados pagan por el modelo de razonamiento
Apéndice A: qué hace una buena señal de verificación
- la cascada es tan buena como su verificador; lo que separa una señal útil de una inútil:
- Estricta y fundamentada.
- una verificación sí/no comprobable sobre un único campo frente a la fuente (p. ej., “¿está este valor ausente en la fuente?”), no una vaga “¿es buena esta extracción?”
- las preguntas vagas dan puntuaciones borrosas y no calibradas
- Mal = TRUE, con criterios explícitos.
- formula cada pregunta de modo que el caso de escalar sea el
true, y establece qué significantrue/false - Por campo, luego agrega con
max. - una bandera por campo localiza el error y se mantiene escasa y contundente
max(“se activa cualquier bandera”) asegura que una sola bandera roja confiable escale, en lugar de diluirse en silencio al promediarse- Independiente y económica.
- un verificador dedicado (aquí, TypeSafe) que juzga la salida detecta los propios puntos ciegos del extractor
- tiene que ser económica, o no quedan ahorros que capturar
- Separada / calibrada.
- una buena señal es alta en errores reales y baja en aciertos, por lo que un único umbral separa claramente aceptar vs. escalar
- esa separación es lo que empuja la curva de Pareto hacia arriba y a la izquierda