 JevCode
Clasificación mediante confianza
Clasificar los informes anuales de la SEC en 75 grupos industriales con una única opción, y luego leer la confianza de la respuesta para decidir si se reporta ese grupo o la división superior más amplia.
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

Cada empresa que presenta un informe anual a la SEC describe su propia actividad en él.
Clasificamos esas descripciones bajo la Clasificación Industrial Estándar: 75 grupos
industriales, una Choice pregunta por documento.
La mayoría de los registros son sencillos. Un banco regional es un banco regional. Algunos no lo son: una empresa que acaba de vender uno de sus dos segmentos, o una startup que describe un negocio en el que planea entrar en lugar de uno que gestiona. El modelo tiene que elegir un grupo de todos modos, y la respuesta para un caso difícil no se parece en nada a la respuesta para uno sencillo. Distinguir los casos difíciles de los sencillos es normalmente donde se incurre en el coste: un segundo modelo, llamadas adicionales, revisión humana.
Una Choice ya te lo indica. Junto a la opción ganadora, devuelve confidence, alto cuando casi toda la probabilidad recaía en una sola opción y bajo cuando se repartía entre varias. Ese único número separa las respuestas en las que puedes confiar de las que no.
Lo que hacer con una respuesta no confiable depende de tus etiquetas. Las etiquetas SIC forman una jerarquía: los grupos industriales se agrupan en divisiones más amplias. Esto hace que una respuesta sea casi gratuita. Cuando el modelo no está seguro del grupo, informa la división a la que pertenece. La etiqueta amplia se deriva de la estrecha, por lo que no hay una segunda llamada.
En 60 expedientes, un umbral de confianza de 0.9 los divide por igual. La mitad confiada tiene razón el 90 % de las veces; la otra mitad, el 40 %. Informado un nivel más arriba, ese 40 % se convierte en 70 %. Terminamos con una función classify() que devuelve una etiqueta junto con su nivel de especificidad, a razón de una solicitud por documento.
Dirección del flujo: LR
| Nodo | Descripción | Grupo |
|---|---|---|
doc |
Elemento 1 ‘Negocios’ / de un 10-K | — |
request |
una solicitud | una solicitud |
q |
Choice / 75 grupos industriales | una solicitud |
sure |
confianza / ≥ 0,9? | — |
grp |
informar el grupo industrial / p. ej. 28 | — |
div |
informar su división / p. ej. manufactura | — |
| De | Condición | A |
|---|---|---|
doc |
— | request |
sure |
sí | grp |
sure |
no | div |
Configuración
pip install ipython matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/entonces establece TYPESAFE_API_KEY. Cada llamada a la API se almacena en caché en json_cache.json, que se incluye con el libro de recetas, por lo que volver a renderizar reproduce los números publicados sin llamar a la API.
Elimina ese archivo para volver a ejecutar todo en tiempo real.
Los números de abajo provienen de jev-1.12 el 2026-08-12.
import json
from collections import defaultdict
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, TypeSafeClient

matplotlib.use("Agg")  # headless render

import os  # noqa: E402

TYPESAFE_MODEL = "jev-1.12"
CONFIDENT = 0.9  # above this the group is reported; below it, the division

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Construye los dos niveles de la taxonomía
sic_codes.tsv es la lista sectorial que la SEC publica para que los presentadores elijan su propio código, obtenida el 2026-08-10: 444 códigos de cuatro dígitos, cada uno con un título de industria. Los dígitos forman una jerarquía. Los dos primeros son el grupo mayor (75 de ellos aquí, desde 01 producción agrícola hasta 99 no clasificable), y los rangos fijos de grupos mayores conforman las diez divisiones, la división más amplia del SIC.
Ambos niveles provienen de ese único archivo sin intervención de ningún modelo: agrupa los códigos por sus dos primeros dígitos y luego mapea esos dígitos a una división.
DIVISIONS = [
    (1, 9, "agriculture, forestry and fishing"),
    (10, 14, "mining"),
    (15, 17, "construction"),
    (20, 39, "manufacturing"),
    (40, 49, "transportation, communications and utilities"),
    (50, 51, "wholesale trade"),
    (52, 59, "retail trade"),
    (60, 67, "finance, insurance and real estate"),
    (70, 89, "services"),
    (91, 99, "public administration"),
]

INDUSTRIES: dict[str, str] = {}
for line in Path("sic_codes.tsv").read_text().splitlines()[1:]:
    code, _office, title = line.split("\t")
    INDUSTRIES[code] = title.lower()

GROUPS: dict[str, list[str]] = defaultdict(list)
for code in sorted(INDUSTRIES):
    GROUPS[code[:2]].append(code)


def division(group: str) -> str:
    number = int(group)
    return next(name for low, high, name in DIVISIONS if low <= number <= high)


print(
    f"{len(INDUSTRIES)} industries -> {len(GROUPS)} major groups -> {len(DIVISIONS)} divisions"
)
print(
    f"  group 35 = {division('35')} / {', '.join(INDUSTRIES[c] for c in GROUPS['35'][:3])} ..."
)
444 industries -> 75 major groups -> 10 divisions
group 35 = manufacturing / engines & turbines, farm machinery & equipment, lawn & garden tractors & home lawn & gardens equip ...Una pregunta de Choice necesita algo para describir cada opción, y el nombre propio de un grupo no siempre está presente: 42 de los 75 llevan un título genérico en la lista de la SEC, y el resto no lleva ninguno. Por lo tanto, cada grupo se describe mediante las industrias que contiene, que es precisamente lo que alguien que lee el informe compararía de todos modos.
MAX_NAMED = (
    8  # industries listed per group; enough to characterise it without a wall of text
)


def describe(group: str) -> str:
    umbrella = INDUSTRIES.get(f"{group}00")
    inside = [INDUSTRIES[c] for c in GROUPS[group] if c != f"{group}00"][:MAX_NAMED]
    listed = "; ".join(inside)
    return (
        f"{umbrella} — includes: {listed}"
        if umbrella and listed
        else (umbrella or listed)
    )


print(f"group 20: {describe('20')[:150]}")
print(f"\ngroup 65: {describe('65')[:150]}")
group 20: food and kindred products — includes: meat packing plants; sausages & other prepared meat products; poultry slaughtering and processing; dairy product
group 65: real estate — includes: real estate operators (no developers) & lessors; operators of nonresidential buildings; operators of apartment buildings; lessLos expedientes
filings.jsonl contiene 60 informes anuales (10-K), cada uno recortado al Ítem 1 “Negocio”, la sección donde una empresa describe lo que hace, que es la única parte que interesa a un código de la industria. Cubren el período 1993–2024 y varían entre 700 y 2.200 palabras. Cada uno incluye el código SIC elegido por el presentador, así como el número de acceso para consultarlo en EDGAR.
De dónde proviene esa etiqueta importa antes que cualquier número de precisión. Es autodeclarada: quien preparó el informe la eligió una vez, y se vuelve obsoleta cuando una empresa vende el negocio con los nombres en código y conserva el código. Estos 60 se filtraron hasta obtener informes cuyos texto propio respalda el código que llevan, por lo que los números aquí miden la receta más que el estado de los metadatos de EDGAR.
FILINGS = [json.loads(line) for line in Path("filings.jsonl").read_text().splitlines()]
example = FILINGS[7]
print(
    f"{len(FILINGS)} filings, {sum(f['words'] for f in FILINGS) // len(FILINGS)} words on average"
)
print(f"\n{example['id']} (filed {example['year']}, accession {example['accession']}):")
print(f"  {example['text'][:230]}...")
print(f"  filer's code: {example['sic']} {INDUSTRIES[example['sic']]}")
60 filings, 1438 words on average
1389870_2008 (filed 2008, accession 0001079974-09-000155):
Item 1. DESCRIPTION OF BUSINESS. NARRATIVE DESCRIPTION OF THE BUSINESS Across America Financial Services, Inc. is a corporation which was formed under the laws of the State of Colorado on December 1, 2005. Until March 23, 2007, we...
filer's code: 6163 loan brokersHaz una pregunta de Choice y lee la confianza
Una Choice pregunta cuyas opciones son los 75 grupos. Toda la taxonomía cabe en una
solicitud: un Choice funciona de forma fiable hasta aproximadamente 240 opciones, y 75 está muy por debajo de ese límite.
La respuesta vuelve con choice, el grupo ganador; probabilities, el peso en cada uno de los 75; y confidence, que indica cuán concentrada estaba esa distribución. La receta lee confidence en lugar de la propia probabilidad del ganador. Un ganador con 0.45 y un segundo clasificado con 0.44, y un ganador con 0.45 mientras el resto del peso se dispersa tenuemente, son situaciones distintas, y confidence es lo que las separa.
QUESTION = (
    "Which broad industry does this company operate in? Judge the company's own operations "
    "as this filing describes them."
)


def questions() -> dict:
    return {
        "group": Choice(
            instructions=QUESTION,
            criteria={group: describe(group) for group in sorted(GROUPS)},
        )
    }


@json_cache
def ask(filing_id: str, text: str) -> dict:
    response = client.system_one(
        state=text, questions=questions(), model=TYPESAFE_MODEL
    )
    answer = response.answers["group"]
    return {
        "group": answer.choice,
        "confidence": answer.confidence,
        "probabilities": dict(answer.probabilities),
    }
Devuelve el grupo cuando estés seguro, su división cuando no
Las cuatro líneas siguientes son la receta completa. Con una confianza de 0,9 o superior, la respuesta se informa como un grupo de la industria; por debajo de ese umbral, la misma respuesta se informa como la división en la que se encuentra ese grupo.
Cada registro sigue devolviendo una etiqueta utilizable. Uno que el modelo no pudo clasificar con confianza vuelve a subir un nivel en lugar de ser descartado o enviado más allá. Si una división es demasiado gruesa para que tu aplicación pueda actuar sobre ella, esta rama es donde la entregas a una persona.
def classify(filing: dict) -> dict:
    answer = ask(filing["id"], filing["text"])
    sure = answer["confidence"] >= CONFIDENT
    return {
        "level": "group" if sure else "division",
        "label": answer["group"] if sure else division(answer["group"]),
        "confidence": answer["confidence"],
        "group": answer["group"],
    }


def show(filing: dict) -> None:
    result = classify(filing)
    named = describe(result["group"]).split(" — ")[0][:46]
    print(
        f"  {filing['id']:>13}  conf {result['confidence']:.2f}  -> {result['level']:<8} "
        f"{result['label']:<14} (group {result['group']}: {named})"
    )


print("three filings the model was sure about:")
for f in sorted(FILINGS, key=lambda f: -ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
print("\nthree it was not:")
for f in sorted(FILINGS, key=lambda f: ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
three filings the model was sure about:
310158_1996 conf 1.00 -> group 28 (group 28: chemicals & allied products)
33416_1998 conf 1.00 -> group 63 (group 63: life insurance; accident & health insurance; h)
352541_1996 conf 1.00 -> group 49 (group 49: electric, gas & sanitary services)
three it was not:
1372167_2013 conf 0.22 -> division manufacturing (group 38: search, detection, navagation, guidance, aeron)
1398633_2009 conf 0.23 -> division wholesale trade (group 50: wholesale-durable goods)
46653_1999 conf 0.29 -> division services (group 87: services-engineering, accounting, research, ma)Las líneas de confianza coinciden con la dificultad de clasificación de cada presentación. Las tres con 1.00 son una empresa farmacéutica, una aseguradora de vida y una empresa de servicios públicos; las tres son sociedades holding en el papel, pero cada una tiene un negocio dominante que la presentación nombra abiertamente. Las tres en la parte inferior son más difíciles por razones que puedes leer en el texto. Dos son empresas en etapa de desarrollo que describen un negocio que pretenden iniciar (Nevaeh “pretende operar como desarrolladora de software”), Barricode fue “organizada para entrar en la industria del software de seguridad informática”), y la tercera tenía dos segmentos y vendió uno de ellos semanas antes de la presentación. Esas tres aparecen como una división en lugar de un grupo.
classify() es la receta completa. Apunta ask() a tus propios documentos y reescribe describe() para tu propia taxonomía, y el resto se traslada.
Lo que aporta la respuesta más amplia
Las 60 presentaciones, puntuadas frente al código que eligió cada presentador, bajo ambas políticas: nombra un grupo cada vez, o informa de la división siempre que la confianza caiga por debajo de 0.9.
def correct(filing: dict, result: dict) -> bool:
    gold_group = filing["sic"][:2]
    if result["level"] == "group":
        return result["label"] == gold_group
    return result["label"] == division(gold_group)


results = [(f, classify(f)) for f in FILINGS]
sure = [(f, r) for f, r in results if r["level"] == "group"]
unsure = [(f, r) for f, r in results if r["level"] == "division"]

forced = sum(r["group"] == f["sic"][:2] for f, r in results)
broadened = sum(correct(f, r) for f, r in results)

print(f"forced to name a group every time      {forced}/{len(results)} right")
print(
    f"  of those, the {len(sure)} it was sure about  "
    f"{sum(r['group'] == f['sic'][:2] for f, r in sure)}/{len(sure)} right"
)
print(
    f"  and the {len(unsure)} it was not           "
    f"{sum(r['group'] == f['sic'][:2] for f, r in unsure)}/{len(unsure)} right"
)
print(
    f"\nletting it answer coarsely when unsure  {broadened}/{len(results)} useful answers"
)
forced to name a group every time 39/60 right
of those, the 30 it was sure about 27/30 right
and the 30 it was not 12/30 right
letting it answer coarsely when unsure 48/60 useful answersCuando el modelo estaba seguro, el grupo que nombraba era correcto nueve de cada diez veces. Cuando no lo estaba, nombrar un grupo era incorrecto más a menudo que correcto, en un 40%. Informar esas mismas respuestas como una división las eleva al 70%.
El gráfico pone las dos políticas lado a lado, dividido por si el modelo estaba seguro.
labels = ["sure\n(group reported)", "unsure\n(division reported)"]
forced_split = [
    sum(r["group"] == f["sic"][:2] for f, r in sure) / len(sure),
    sum(r["group"] == f["sic"][:2] for f, r in unsure) / len(unsure),
]
broad_split = [
    sum(correct(f, r) for f, r in sure) / len(sure),
    sum(correct(f, r) for f, r in unsure) / len(unsure),
]

fig, ax = plt.subplots(figsize=(7, 3.6))
x = range(len(labels))
ax.bar(
    [i - 0.19 for i in x],
    forced_split,
    0.38,
    label="always name a group",
    color="#c8ccd4",
)
ax.bar(
    [i + 0.19 for i in x],
    broad_split,
    0.38,
    label="answer broadly when unsure",
    color="#3b6ea5",
)
for i, (a, b) in enumerate(zip(forced_split, broad_split)):
    ax.text(i - 0.19, a + 0.02, f"{a:.0%}", ha="center", fontsize=9)
    ax.text(i + 0.19, b + 0.02, f"{b:.0%}", ha="center", fontsize=9)
ax.set_xticks(list(x))
ax.set_xticklabels(
    [f"{lab}\nn={n}" for lab, n in zip(labels, [len(sure), len(unsure)])]
)
ax.set_ylabel("labels that are right")
ax.set_ylim(0, 1.12)
ax.set_title("Where the broader answer helps: the filings it was unsure about")
ax.legend(frameon=False, loc="upper right")
ax.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
display(fig)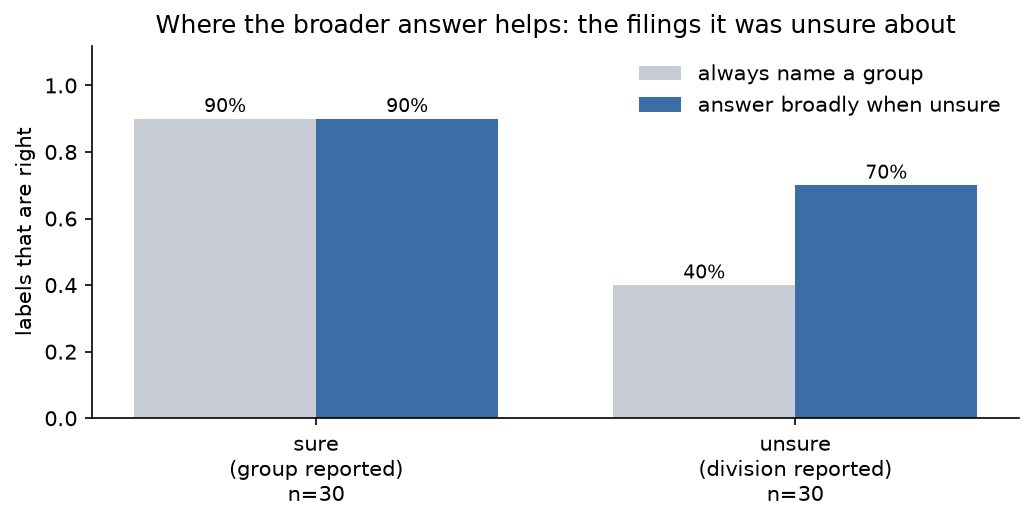
Ábrelo en el playground
Este enlace de compartición contiene un único expediente y la pregunta de 75 opciones, por lo que puedes ver la distribución y la confianza que produce sin escribir ningún código.
playground_link = make_playground_link(
    example["text"], questions(), models=[TYPESAFE_MODEL]
)
display(
    Markdown(
        f"🔗 [Open the filing + question in the TypeSafe playground]({playground_link})"
    )
)
Abrir el expediente + pregunta en el playground de TypeSafe →