 JevCode
Classification par niveau de confiance
Classifier les rapports annuels de la SEC en 75 groupes sectoriels avec un choix unique, puis lire le niveau de confiance du modèle pour décider s'il faut attribuer ce groupe spécifique ou la division supérieure plus large.
Traduit automatiquement depuis le en, non relu. À utiliser comme référence rapide uniquement.

Chaque entreprise qui dépose un rapport annuel auprès de la SEC décrit son propre secteur d’activité dans ce document. Nous classons ces descriptions sous la Classification Industrielle Standard : 75 groupes sectoriels, une Choice question par document.
La plupart des déclarations sont simples. Une banque régionale est une banque régionale. Certaines ne le sont pas : une entreprise qui vient de céder l’un de ses deux segments, ou une startup qui décrit une activité qu’elle prévoit d’intégrer plutôt qu’une qu’elle gère déjà. Le modèle doit choisir un groupe de toute façon, et la réponse à un cas difficile ne ressemble en rien à celle d’un cas facile. Distinguer les cas difficiles des cas faciles est normalement là que réside le coût : un deuxième modèle, des appels supplémentaires, un examen humain.
Un Choice vous le dit déjà. Aux côtés de l’option gagnante, il renvoie confidence, élevé lorsque presque toute la probabilité s’est concentrée sur une seule option et faible lorsqu’elle est répartie entre plusieurs. Ce seul chiffre permet de distinguer les réponses que vous pouvez faire confiance de celles que vous ne pouvez pas.
Ce qu’il faut faire avec une réponse non fiable dépend de vos étiquettes. Les étiquettes SIC forment une hiérarchie : les groupes sectoriels s’agrègent en divisions plus larges. Cela rend une réponse presque gratuite. Lorsque le modèle n’est pas sûr du groupe, signalez la division à laquelle il appartient. L’étiquette large découle de l’étiquette étroite, donc il n’y a pas d’appel supplémentaire.
Sur 60 dossiers, un seuil de confiance de 0,9 les divise en deux. La moitié confiante a raison 90 % du temps ; l’autre moitié, 40 %. Signalé à un niveau supérieur, ce 40 % devient 70 %. Nous terminons avec une fonction classify() qui renvoie une étiquette ainsi que son degré de spécificité, à une demande par document.
Direction du flux : LR
| Nœud | Description | Groupe |
|---|---|---|
doc |
Élément 1 « Business » / issu d’un 10-K | — |
request |
une requête | une requête |
q |
Choice / 75 groupes sectoriels | une requête |
sure |
confiance / ≥ 0,9 ? | — |
grp |
signaler le groupe sectoriel / ex. 28 | — |
div |
signaler sa division / ex. fabrication | — |
| De | Condition | À |
|---|---|---|
doc |
— | request |
sure |
oui | grp |
sure |
non | div |
Installation
pip install ipython matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/puis définis TYPESAFE_API_KEY. Chaque appel API est mis en cache dans json_cache.json, qui est livré avec le cookbook, donc le re-rendu rejoue les nombres publiés sans appeler l’API.
Supprime ce fichier pour tout relancer en direct.
Les chiffres ci-dessous proviennent de jev-1.12 le 2026-08-12.
import json
from collections import defaultdict
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, TypeSafeClient

matplotlib.use("Agg")  # headless render

import os  # noqa: E402

TYPESAFE_MODEL = "jev-1.12"
CONFIDENT = 0.9  # above this the group is reported; below it, the division

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Construire les deux niveaux de la taxonomie
sic_codes.tsv est la liste sectorielle publiée par la SEC pour que les déclarants puissent choisir leur propre code, consultée le 2026-08-10 : 444 codes à quatre chiffres, chacun accompagné d’un titre de secteur. Les chiffres forment une hiérarchie. Les deux premiers constituent le groupe majeur (75 ici, allant de 01 production agricole à 99 non classifiable), et des plages fixes de groupes majeurs composent les dix divisions, la classification la plus large du SIC.
Les deux niveaux proviennent de ce même fichier, sans modèle impliqué : regroupez les codes par leurs deux premiers chiffres, puis mappez ces chiffres à une division.
DIVISIONS = [
    (1, 9, "agriculture, forestry and fishing"),
    (10, 14, "mining"),
    (15, 17, "construction"),
    (20, 39, "manufacturing"),
    (40, 49, "transportation, communications and utilities"),
    (50, 51, "wholesale trade"),
    (52, 59, "retail trade"),
    (60, 67, "finance, insurance and real estate"),
    (70, 89, "services"),
    (91, 99, "public administration"),
]

INDUSTRIES: dict[str, str] = {}
for line in Path("sic_codes.tsv").read_text().splitlines()[1:]:
    code, _office, title = line.split("\t")
    INDUSTRIES[code] = title.lower()

GROUPS: dict[str, list[str]] = defaultdict(list)
for code in sorted(INDUSTRIES):
    GROUPS[code[:2]].append(code)


def division(group: str) -> str:
    number = int(group)
    return next(name for low, high, name in DIVISIONS if low <= number <= high)


print(
    f"{len(INDUSTRIES)} industries -> {len(GROUPS)} major groups -> {len(DIVISIONS)} divisions"
)
print(
    f"  group 35 = {division('35')} / {', '.join(INDUSTRIES[c] for c in GROUPS['35'][:3])} ..."
)
444 industries -> 75 major groups -> 10 divisions
group 35 = manufacturing / engines & turbines, farm machinery & equipment, lawn & garden tractors & home lawn & gardens equip ...Une question Choice a besoin de quelque chose pour décrire chaque option, et le nom propre d’un groupe n’est pas toujours présent : 42 des 75 portent un titre générique dans la liste de la SEC, et les autres n’en portent aucun. Ainsi, chaque groupe est décrit par les industries qu’il contient, ce qui est ce qu’un lecteur du dépôt ferait correspondre de toute façon.
MAX_NAMED = (
    8  # industries listed per group; enough to characterise it without a wall of text
)


def describe(group: str) -> str:
    umbrella = INDUSTRIES.get(f"{group}00")
    inside = [INDUSTRIES[c] for c in GROUPS[group] if c != f"{group}00"][:MAX_NAMED]
    listed = "; ".join(inside)
    return (
        f"{umbrella} — includes: {listed}"
        if umbrella and listed
        else (umbrella or listed)
    )


print(f"group 20: {describe('20')[:150]}")
print(f"\ngroup 65: {describe('65')[:150]}")
group 20: food and kindred products — includes: meat packing plants; sausages & other prepared meat products; poultry slaughtering and processing; dairy product
group 65: real estate — includes: real estate operators (no developers) & lessors; operators of nonresidential buildings; operators of apartment buildings; lessLes déclarations
filings.jsonl contient 60 rapports annuels (10-K), chacun réduit à l’Item 1 « Activité »,
la section où une entreprise décrit ce qu’elle fait, qui est la seule partie qui
intéresse un code sectoriel. Ils couvrent la période 1993–2024 et font entre 700 et 2 200 mots. Chacun porte le code SIC
choisi par son déclarant, ainsi que le numéro d’accès pour le consulter sur EDGAR.
L’origine de cette étiquette importe avant tout chiffre de précision. Elle est déclarée par l’intéressé : celui qui a préparé le dépôt l’a choisie une seule fois, et elle devient obsolète lorsqu’une entreprise vend l’affaire portant les noms de code tout en conservant les codes. Ces 60 cas ont été filtrés pour ne retenir que les dépôts dont le texte même étaye le code qu’ils portent, de sorte que les chiffres ici mesurent la recette plutôt que l’état des métadonnées d’EDGAR.
FILINGS = [json.loads(line) for line in Path("filings.jsonl").read_text().splitlines()]
example = FILINGS[7]
print(
    f"{len(FILINGS)} filings, {sum(f['words'] for f in FILINGS) // len(FILINGS)} words on average"
)
print(f"\n{example['id']} (filed {example['year']}, accession {example['accession']}):")
print(f"  {example['text'][:230]}...")
print(f"  filer's code: {example['sic']} {INDUSTRIES[example['sic']]}")
60 filings, 1438 words on average
1389870_2008 (filed 2008, accession 0001079974-09-000155):
Item 1. DESCRIPTION OF BUSINESS. NARRATIVE DESCRIPTION OF THE BUSINESS Across America Financial Services, Inc. is a corporation which was formed under the laws of the State of Colorado on December 1, 2005. Until March 23, 2007, we...
filer's code: 6163 loan brokersPosez une seule question Choice, et lisez la confiance
Une Choice question dont les options sont les 75 groupes. Toute la taxonomie tient dans une seule requête : un Choice fonctionne de manière fiable jusqu’à environ 240 options, et 75 est largement en deçà de cette limite.
La réponse revient avec choice, le groupe gagnant ; probabilities, le poids sur chacun des 75 ; et confidence, qui indique à quel point cette répartition était concentrée. La recette lit confidence plutôt que la probabilité propre du gagnant. Un gagnant à 0,45 avec un dauphin à 0,44, et un gagnant à 0,45 avec le reste du poids dispersé finement, sont des situations différentes, et confidence est ce qui les sépare.
QUESTION = (
    "Which broad industry does this company operate in? Judge the company's own operations "
    "as this filing describes them."
)


def questions() -> dict:
    return {
        "group": Choice(
            instructions=QUESTION,
            criteria={group: describe(group) for group in sorted(GROUPS)},
        )
    }


@json_cache
def ask(filing_id: str, text: str) -> dict:
    response = client.system_one(
        state=text, questions=questions(), model=TYPESAFE_MODEL
    )
    answer = response.answers["group"]
    return {
        "group": answer.choice,
        "confidence": answer.confidence,
        "probabilities": dict(answer.probabilities),
    }
Retourner le groupe quand sûr, sa division quand non
Les quatre lignes ci-dessous constituent la recette complète. À une confiance de 0,9 ou plus, la réponse est indiquée comme un groupe sectoriel ; en dessous de ce seuil, la même réponse est indiquée comme le secteur dans lequel ce groupe s’inscrit.
Chaque dépôt revient avec une étiquette exploitable. Celui que le modèle n’a pas pu classer avec confiance revient un niveau au-dessus au lieu d’être supprimé ou transmis. Si une division est trop grossière pour que votre application puisse agir, c’est dans cette branche que vous la confiez à une personne.
def classify(filing: dict) -> dict:
    answer = ask(filing["id"], filing["text"])
    sure = answer["confidence"] >= CONFIDENT
    return {
        "level": "group" if sure else "division",
        "label": answer["group"] if sure else division(answer["group"]),
        "confidence": answer["confidence"],
        "group": answer["group"],
    }


def show(filing: dict) -> None:
    result = classify(filing)
    named = describe(result["group"]).split(" — ")[0][:46]
    print(
        f"  {filing['id']:>13}  conf {result['confidence']:.2f}  -> {result['level']:<8} "
        f"{result['label']:<14} (group {result['group']}: {named})"
    )


print("three filings the model was sure about:")
for f in sorted(FILINGS, key=lambda f: -ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
print("\nthree it was not:")
for f in sorted(FILINGS, key=lambda f: ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
three filings the model was sure about:
310158_1996 conf 1.00 -> group 28 (group 28: chemicals & allied products)
33416_1998 conf 1.00 -> group 63 (group 63: life insurance; accident & health insurance; h)
352541_1996 conf 1.00 -> group 49 (group 49: electric, gas & sanitary services)
three it was not:
1372167_2013 conf 0.22 -> division manufacturing (group 38: search, detection, navagation, guidance, aeron)
1398633_2009 conf 0.23 -> division wholesale trade (group 50: wholesale-durable goods)
46653_1999 conf 0.29 -> division services (group 87: services-engineering, accounting, research, ma)Les niveaux de confiance correspondent à la difficulté de classification de chaque déclaration. Les trois à 1,00 sont un fabricant de produits pharmaceutiques, une assureur-vie et un fournisseur de services publics ; tous trois sont des sociétés holding sur le papier, mais chacune possède une activité dominante que la déclaration nomme explicitement. Les trois au bas du tableau sont plus difficiles pour des raisons que vous pouvez lire dans le texte. Deux sont des sociétés en phase de développement décrivant une activité qu’elles ont l’intention de lancer (Nevaeh « a l’intention d’exercer en tant que développeur de logiciels », Barricode a été « constituée pour entrer dans l’industrie des logiciels de sécurité informatique »), et la troisième avait deux segments et en a vendu un quelques semaines avant la déclaration. Ces trois ressortent comme une division plutôt que comme un groupe.
classify() est la recette complète. Pointez ask() vers vos propres documents et réécrivez
describe() pour votre propre taxonomie, et le reste s’applique automatiquement.
Ce que l’explication plus large permet d’obtenir
Les 60 dépôts, notés par rapport au code choisi par chaque déposant, dans le cadre des deux politiques : nommer un groupe à chaque fois, ou signaler la division chaque fois que la confiance est inférieure à 0,9.
def correct(filing: dict, result: dict) -> bool:
    gold_group = filing["sic"][:2]
    if result["level"] == "group":
        return result["label"] == gold_group
    return result["label"] == division(gold_group)


results = [(f, classify(f)) for f in FILINGS]
sure = [(f, r) for f, r in results if r["level"] == "group"]
unsure = [(f, r) for f, r in results if r["level"] == "division"]

forced = sum(r["group"] == f["sic"][:2] for f, r in results)
broadened = sum(correct(f, r) for f, r in results)

print(f"forced to name a group every time      {forced}/{len(results)} right")
print(
    f"  of those, the {len(sure)} it was sure about  "
    f"{sum(r['group'] == f['sic'][:2] for f, r in sure)}/{len(sure)} right"
)
print(
    f"  and the {len(unsure)} it was not           "
    f"{sum(r['group'] == f['sic'][:2] for f, r in unsure)}/{len(unsure)} right"
)
print(
    f"\nletting it answer coarsely when unsure  {broadened}/{len(results)} useful answers"
)
forced to name a group every time 39/60 right
of those, the 30 it was sure about 27/30 right
and the 30 it was not 12/30 right
letting it answer coarsely when unsure 48/60 useful answersLorsque le modèle était sûr, le groupe qu’il a nommé est correct neuf fois sur dix. Lorsqu’il ne l’était pas, nommer un groupe était plus souvent incorrect que correct, à 40 %. Signaler ces mêmes réponses comme une division les porte à 70 %.
Le graphique met en regard les deux politiques, séparées selon que le modèle était sûr ou non.
labels = ["sure\n(group reported)", "unsure\n(division reported)"]
forced_split = [
    sum(r["group"] == f["sic"][:2] for f, r in sure) / len(sure),
    sum(r["group"] == f["sic"][:2] for f, r in unsure) / len(unsure),
]
broad_split = [
    sum(correct(f, r) for f, r in sure) / len(sure),
    sum(correct(f, r) for f, r in unsure) / len(unsure),
]

fig, ax = plt.subplots(figsize=(7, 3.6))
x = range(len(labels))
ax.bar(
    [i - 0.19 for i in x],
    forced_split,
    0.38,
    label="always name a group",
    color="#c8ccd4",
)
ax.bar(
    [i + 0.19 for i in x],
    broad_split,
    0.38,
    label="answer broadly when unsure",
    color="#3b6ea5",
)
for i, (a, b) in enumerate(zip(forced_split, broad_split)):
    ax.text(i - 0.19, a + 0.02, f"{a:.0%}", ha="center", fontsize=9)
    ax.text(i + 0.19, b + 0.02, f"{b:.0%}", ha="center", fontsize=9)
ax.set_xticks(list(x))
ax.set_xticklabels(
    [f"{lab}\nn={n}" for lab, n in zip(labels, [len(sure), len(unsure)])]
)
ax.set_ylabel("labels that are right")
ax.set_ylim(0, 1.12)
ax.set_title("Where the broader answer helps: the filings it was unsure about")
ax.legend(frameon=False, loc="upper right")
ax.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
display(fig)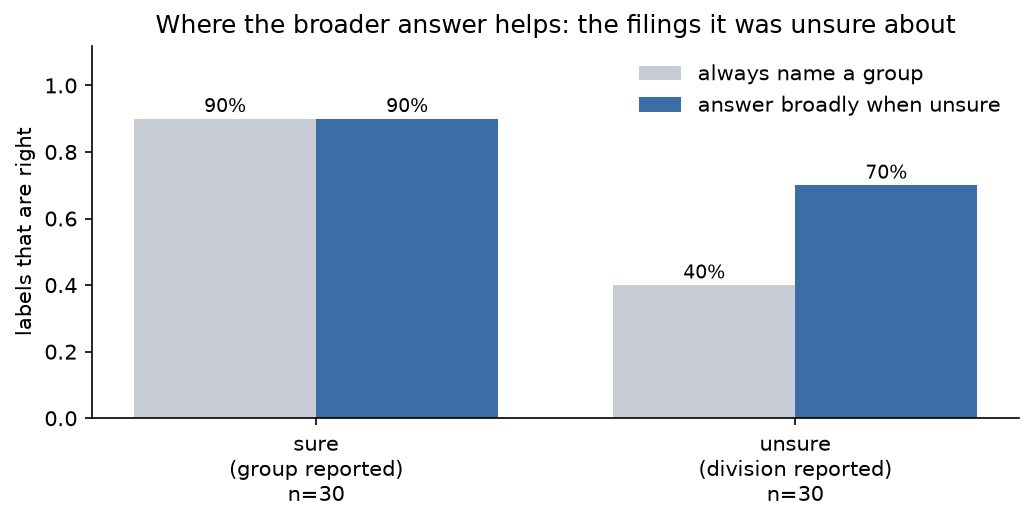
Ouvrez-le dans le terrain de jeu
Ce lien de partage contient une seule déclaration et la question à 75 options, afin que vous puissiez voir la distribution et la confiance qu’elle génère sans écrire de code.
playground_link = make_playground_link(
    example["text"], questions(), models=[TYPESAFE_MODEL]
)
display(
    Markdown(
        f"🔗 [Open the filing + question in the TypeSafe playground]({playground_link})"
    )
)
Ouvrir le dossier + la question dans le playground TypeSafe →