 JevCode
Suggestion de compétence
Sélectionne au plus une compétence pour un tour d'agent parmi les 182 du catalogue Hermes de Nous Research : une requête TypeSafe classe chaque compétence et demande si le tour en nécessite une, une seconde lit correctement les trois premières et peut rejeter toutes. Le nom du gagnant est inscrit sur une seule ligne de l'agent's sy
Traduit automatiquement depuis le en, non relu. À utiliser comme référence rapide uniquement.

Les agents choisissent les compétences en les tronquant et en les chargeant toutes dans le message système, ce qui augmente les coûts, détériore la performance de sélection des compétences et induit une dégradation du contexte pour le reste de la session. Nous remédions à cela en utilisant deux requêtes TypeSafe par tour, une pour classer les compétences et une pour vérifier le choix, et réduisons les chargements incorrects de compétences de plus de moitié.
Un agent disposant d’une large gamme de compétences fait son choix sur presque aucune information. Cette liste lui parvient sous forme d’index : une ligne par compétence, avec la description tronquée afin que le texte complet n’envahisse pas la conversation. Hermes, le framework d’agent utilisé ici, la réduit à 60 caractères par défaut. Par exemple, à cette largeur, la compétence qui modifie .pptx fichiers se lit presque de la même manière que celle qui les rédige. Si l’on demande un dossier de présentation, l’agent peut charger le mauvais. Lors d’un tour où aucune compétence ne convient, il peut tout de même en charger une, car une liste de noms invite à deviner.
Ce livre de recettes laisse les descriptions telles quelles et utilise une divulgation progressive, en lisant toutes les 182 compétences à moindre coût, puis en lisant trois d’entre elles en détail. Deux requêtes TypeSafe sont placées avant la décision de quelle compétence charger, le cas échéant. La première classe chaque compétence du roster par rapport au tour de l’utilisateur et répond à la question de savoir si le tour nécessite une compétence ou non. La seconde relit uniquement les trois premières, maintenant avec la description complète de chaque compétence et l’ ouverture de ses instructions, et est libre de rejeter toutes.
Le nom du gagnant est inscrit dans une ligne supplémentaire du prompt système de l’agent pour ce tour :
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user
actually asked for.
</skill_relevance>
L’agent conserve son index complet et son propre jugement, et cette seule ligne lui indique uniquement quelle entrée examiner en premier. La liste elle-même ne change jamais, de sorte que tout cache de préfixe sur celle-ci reste valide. Sur 488 requêtes contre claude-haiku-4-5-20251001, en utilisant les compétences du roster Hermes :
| charge une compétence erronée | charge une compétence alors qu’aucune ne correspond | |
|---|---|---|
| agent seul, avec seulement son répertoire | 16,8 % | 9,8 % |
| agent avec une suggestion TypeSafe | 7,3 % | 4,0 % |
| agent auquel on donne la bonne réponse | 2,5 % | 1,2 % |
La troisième ligne indique que le plancher pour faire des erreurs n’est pas zéro, car un agent doté de la bonne compétence ne la charge pas toujours, et aucune méthode de sélection, aussi bonne soit-elle, ne parvient à franchir ce seuil.
Vous obtenez une fonction suggest() qui retourne au plus un nom de compétence, un suggestion_block() qui l’entoure pour la invite système, et le harnais qui a produit le tableau ci-dessus, prêt à pointer vers votre propre liste.
Direction du flux : LR
| Nœud | Description | Groupe |
|---|---|---|
C1 |
Appel 1 - parcourir les 182 compétences | Appel 1 - parcourir les 182 compétences |
Q1 |
Choice : quelle compétence convient ? / les 182, une ligne chacune | Appel 1 - parcourir les 182 compétences |
N1 |
Nouls : faut-il une compétence ? / · agir sur leurs éléments ? / · suivre les étapes écrites ? / · ou simplement discuter ? | Appel 1 - parcourir les 182 compétences |
C2 |
Appel 2 - lire correctement ces 3 | Appel 2 - lire correctement ces 3 |
Q2 |
Choice : laquelle des 3 ? / avec des détails concrets maintenant | Appel 2 - lire correctement ces 3 |
N2 |
Nouls : chacune le fait-elle / vraiment ? | Appel 2 - lire correctement ces 3 |
| De | Condition | À |
|---|---|---|
Q1 |
— | N1 |
Q2 |
— | N2 |
C1 |
top 3 | C2 |
C1 |
rien / s’applique | STOP |
C2 |
aucun ne correspond | STOP |
C2 |
un gagnant | OUT |
Configuration
- Installez le client TypeSafe, le client Anthropic et les utilitaires partagés du cookbook.
- Définissez une clé d’API TypeSafe, ainsi qu’une clé Anthropic pour l’agent à évaluer.
pip install anthropic matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/
export TYPESAFE_API_KEY=your-key-here
export ANTHROPIC_API_KEY=your-key-here
Remarque : les blocs de code ci-dessous constituent un seul script, dans l’ordre. Pour suivre le tutoriel, placez-les dans un seul fichier dans l’ordre indiqué.
Mise en cache des résultats
JsonCache enregistre le résultat de chaque appel, indexé par ses entrées, de sorte que relancer rejoue les
chiffres ci-dessous au lieu d’appeler l’une ou l’autre API. Supprimez json_cache.json pour exécuter en direct. La
publication a utilisé jev-1.12 et claude-haiku-4-5-20251001, rendus le 2026-07-31.
import json
import os
from collections import defaultdict
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
from time import perf_counter

import anthropic
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.ticker import PercentFormatter
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
AGENT_MODEL = (
    "claude-haiku-4-5-20251001"  # the agent under test, pinned so scores are stable
)

SHORTLIST = 3  # candidates carried from the first request into the second
EXCERPT_CHARS = (
    700  # SKILL.md characters each candidate brings; the roster file stores 1600
)
GATE_THRESHOLD = (
    0.30  # mean of the three request nouls, below which nothing is suggested
)
FITS_THRESHOLD = (
    0.30  # a shortlist whose best "does this fit" noul is under this is dropped
)
WORKERS = 8  # small pool: enough to keep a live run to minutes, gentle on rate limits

assert EXCERPT_CHARS <= 1600, (
    "the shipped roster file stores 1600 body characters per skill"
)

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
agent = anthropic.Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY", "cache-only"))
json_cache = JsonCache(Path("json_cache.json"))
Étape 1 : charger le roster
hermes_roster.json contient les 182 compétences de
NousResearch/hermes-agent (MIT) à un
commit épinglé. Chaque enregistrement contient le nom et la catégorie d’une compétence, la description telle qu’elle apparaît dans l’index, la description complète, et l’ouverture de son SKILL.md.
L’index ci-dessous, ainsi que les instructions qui le précèdent dans la demande, sont copiés depuis Hermes.
ROSTER = json.loads(Path("hermes_roster.json").read_text(encoding="utf-8"))
BY_NAME = {skill["name"]: skill for skill in ROSTER}

# Verbatim from hermes-agent agent/prompt_builder.py:build_skills_system_prompt.
PREAMBLE = (
    "## Skills (mandatory)\n"
    "Before replying, scan the skills below. If a skill matches or is even partially relevant "
    "to your task, you MUST load it with skill_view(name) and follow its instructions. "
    "Err on the side of loading — it is always better to have context you don't need "
    "than to miss critical steps, pitfalls, or established workflows. "
    "Skills contain specialized knowledge — API endpoints, tool-specific commands, "
    "and proven workflows that outperform general-purpose approaches. Load the skill "
    "even if you think you could handle the task with basic tools like web_search or terminal. "
    "Skills also encode the user's preferred approach, conventions, and quality standards "
    "for tasks like code review, planning, and testing — load them even for tasks you "
    "already know how to do, because the skill defines how it should be done here.\n"
    "Whenever the user asks you to configure, set up, install, enable, disable, modify, "
    "or troubleshoot Hermes Agent itself — its CLI, config, models, providers, tools, "
    "skills, voice, gateway, plugins, or any feature — load the `hermes-agent` skill "
    "first. It has the actual commands (e.g. `hermes config set …`, `hermes tools`, "
    "`hermes setup`) so you don't have to guess or invent workarounds.\n"
    "If a skill has issues, fix it with skill_manage(action='patch').\n"
    "After difficult/iterative tasks, offer to save as a skill. "
    "If a skill you loaded was missing steps, had wrong commands, or needed "
    "pitfalls you discovered, update it before finishing.\n"
    "\n"
)
FOOTER = "\n\nOnly proceed without loading a skill if genuinely none are relevant to the task."
IDENTITY = (
    "You are Hermes, a capable AI assistant with access to tools and a library "
    "of skills. You help the user with coding, research, and everyday tasks.\n\n"
)


def render_index() -> str:
    """The body of <available_skills>: skills grouped by category, both sorted by name."""
    by_category = defaultdict(list)
    for skill in ROSTER:
        by_category[skill["category"]].append(skill)
    lines = []
    for category in sorted(by_category):
        lines.append(f"  {category}:")
        for skill in sorted(by_category[category], key=lambda s: s["name"]):
            lines.append(f"    - {skill['name']}: {skill['description']}")
    return "\n".join(lines)


CATALOG_PROMPT = (
    IDENTITY
    + PREAMBLE
    + "<available_skills>\n"
    + render_index()
    + "\n</available_skills>"
    + FOOTER
)

widths = [len(skill["description"]) for skill in ROSTER]
print(f"{len(ROSTER)} skills in {len({s['category'] for s in ROSTER})} categories")
print(f"roster prompt: {len(CATALOG_PROMPT):,} characters")
print(
    f"index description: {sum(widths) / len(widths):.0f} characters on average, "
    f"{max(widths)} at most"
)
print("\none category, as the agent reads it:")
index_lines = render_index().splitlines()
start = index_lines.index("  apple:")
end = next(
    i
    for i in range(start + 1, len(index_lines))
    if not index_lines[i].startswith("    ")
)
print("\n".join(index_lines[start:end]))
182 skills in 33 categories
roster prompt: 16,089 characters
index description: 54 characters on average, 60 at most
one category, as the agent reads it:
apple:
- apple-notes: Manage Apple Notes via memo CLI: create, search, edit.
- apple-reminders: Apple Reminders via remindctl: add, list, complete.
- findmy: Track Apple devices/AirTags via FindMy.app on macOS.
- imessage: Send and receive iMessages/SMS via the imsg CLI on macOS.Étape 2 : évaluer l’agent selon ses propres critères
requests.json contient 488 requêtes en un seul tour, dont 315 sont couvertes par exactement une compétence
et les 173 autres ne sont couvertes par aucune.
Les demandes couvertes ont été rédigées par Claude Sonnet 5 à partir de SKILL.md propre à chaque compétence, de sorte que les étiquettes sont fiables et que les demandes sont plus simples que celles envoyées par les utilisateurs.
Les 173 autres ont toutes été rédigées pour punir les suppositions : 85 demandes quotidiennes, 42 questions techniques qu’aucune compétence ne couvre (expliquer ce qu’est une monade), et 46 qui demandent quelque chose de spécifique pour lequel la liste de compétences n’a aucune capacité, comme poster ceci sur Mastodon sur une liste qui couvre X et rien d’autre.
Le scoring ne lit que la première réponse de l’agent. Les deux chiffres sont des taux d’erreur, donc plus ils sont bas, mieux c’est :
- charge incorrecte : parmi les requêtes couvertes, la part où le premier
skill_viewappel n’était pas la compétence couvrante. Un tour qui ne chargeait rien du tout compte comme un échec. - charge inutile : parmi les requêtes non couvertes, la part où l’agent a appelé
skill_view.
REQUESTS = json.loads(Path("requests.json").read_text(encoding="utf-8"))
POSITIVES = [p for p in REQUESTS if p["gold"]]
NEGATIVES = [p for p in REQUESTS if not p["gold"]]

print(
    f"{len(REQUESTS)} requests: {len(POSITIVES)} covered by a skill "
    f"({len({p['gold'] for p in POSITIVES})} distinct skills), {len(NEGATIVES)} covered by none"
)
print(f"\ncovered   [{POSITIVES[0]['gold']}]  {POSITIVES[0]['text']}")
print(f"uncovered  {NEGATIVES[0]['text']}")
488 requests: 315 covered by a skill (171 distinct skills), 173 covered by none
covered [1password] I've got a config.yaml with `{{ op://app-prod/db/password }}` placeholders in it — can you set up my project to pull the real values in at runtime instead of hardcoding them?
uncovered Add these three cards to our Trello backlog.La suggestion se trouve dans son propre bloc du prompt système, après la liste plutôt que à l’intérieur, afin que le texte de la liste soit identique à chaque tour pour maintenir la mise en cache des préfixes.
L’agent dispose d’un ensemble minimal d’outils, incluant skill_view pour charger une compétence en utilisant un nom en texte libre. Le nom doit correspondre exactement à la compétence pour un chargement correct.
# Verbatim from hermes-agent tools/skills_tool.py:SKILL_VIEW_SCHEMA.
SKILL_VIEW_DESCRIPTION = (
    "Skills allow for loading information about specific tasks and workflows, as "
    "well as scripts and templates. Load a skill's full content or access its "
    "linked files (references, templates, scripts). First call returns SKILL.md "
    "content plus a 'linked_files' dict showing available references/templates/"
    "scripts. To access those, call again with file_path parameter."
)
TOOLS = [
    {
        "name": "skill_view",
        "description": SKILL_VIEW_DESCRIPTION,
        "input_schema": {
            "type": "object",
            "properties": {
                "name": {"type": "string", "description": "The skill name."}
            },
            "required": ["name"],
        },
    },
    {
        "name": "terminal",
        "description": "Run a shell command on the user's machine and return its output.",
        "input_schema": {
            "type": "object",
            "properties": {"command": {"type": "string"}},
            "required": ["command"],
        },
    },
    {
        "name": "read_file",
        "description": "Read a file from the user's filesystem.",
        "input_schema": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
    {
        "name": "web_search",
        "description": "Search the web and return result snippets.",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    },
]


@json_cache
def run_turn(model: str, arm: str, request: str, suggestion: str) -> dict:
    """One measured turn. ``arm`` is in the key so each arm samples independently."""
    system = [
        {"type": "text", "text": CATALOG_PROMPT, "cache_control": {"type": "ephemeral"}}
    ]
    if suggestion:
        system.append({"type": "text", "text": suggestion})  # after the breakpoint
    response = agent.messages.create(
        model=model,
        max_tokens=1024,
        system=system,
        tools=TOOLS,
        messages=[{"role": "user", "content": request}],
    )
    usage = response.usage
    return {
        "loaded": [
            str(block.input.get("name", ""))
            for block in response.content
            if block.type == "tool_use" and block.name == "skill_view"
        ],
        "input_tokens": usage.input_tokens or 0,
        "output_tokens": usage.output_tokens or 0,
    }


def summarise(turns: dict[str, dict]) -> dict[str, float]:
    """Two failure rates: wrong loads on covered requests, needless ones on uncovered."""
    hits = [turns[p["text"]]["loaded"][:1] == [p["gold"]] for p in POSITIVES]
    over = [bool(turns[p["text"]]["loaded"]) for p in NEGATIVES]
    return {
        # both metrics are errors, so the two columns read the same direction
        "wrong_load": 1 - sum(hits) / len(hits),
        "needless_load": sum(over) / len(over),
    }


def run_arm(arm: str, suggestions: dict[str, str]) -> dict[str, dict]:
    """One measured turn per request, in a small pool. 488 calls."""
    texts = [request["text"] for request in REQUESTS]
    with ThreadPoolExecutor(max_workers=WORKERS) as pool:
        turns = pool.map(
            lambda t: run_turn(AGENT_MODEL, arm, t, suggestions.get(t, "")), texts
        )
        return dict(zip(texts, turns))
L’agent s’exécute en premier avec uniquement son effectif, tel qu’il fonctionne aujourd’hui. Ses deux taux d’erreur constituent la référence que le reste du livre de recettes mesure.
baseline = run_arm("baseline", {})
base_scores = summarise(baseline)
print(
    f"wrong loads    {base_scores['wrong_load']:.1%}   ({len(POSITIVES)} covered requests)"
)
print(
    f"needless loads {base_scores['needless_load']:.1%}   ({len(NEGATIVES)} uncovered requests)"
)

# where the wrong loads land: a neighbour of the right skill, or somewhere unrelated?
misses = [
    (p["gold"], baseline[p["text"]]["loaded"][0])
    for p in POSITIVES
    if baseline[p["text"]]["loaded"] and baseline[p["text"]]["loaded"][0] != p["gold"]
]
same_category = sum(
    1
    for gold, got in misses
    if got in BY_NAME and BY_NAME[got]["category"] == BY_NAME[gold]["category"]
)
print(
    f"\nof {len(misses)} wrong first picks, {same_category} came from the right skill's own "
    f"category"
)
wrong loads 16.8% (315 covered requests)
needless loads 9.8% (173 uncovered requests)
of 36 wrong first picks, 10 came from the right skill's own categoryLes charges erronées atterrissent dans la catégorie propre de la bonne compétence bien plus souvent que le hasard ne le laisserait supposer, de sorte que la partie difficile consiste à distinguer quelques ressemblants. L’agent regarde déjà à peu près au bon endroit.
Étape 3 : classer l’ensemble de la liste
Une demande porte deux types de question :
whichest une questionChoiceportant sur les 182 noms de compétences, la description de l’index servant de critère pour chaque option (le même texte que celui reçu par l’agent). Leurs probabilités constituent le classement.- trois questions
Noulconcernant la demande, imprimées ci-dessous, chacune interrogeant différemment si elle souhaite qu’une action soit effectuée plutôt qu’une explication fournie.prose_sufficescompte dans l’autre sens. Leur moyenne décide s’il faut ou non faire une suggestion, et en dessous de 0,30 aucune suggestion n’est faite.
Les deux partent dans une seule requête, donc le classement et la vérification coûtent un aller-retour.
Rédigez ces trois éléments pour demander si une action est souhaitée. Une question sur le fond ne séparera pas expliquer ce qu’est une monade d’une demande nécessitant une compétence, puisque les deux relèvent du logiciel.
Une seule Choice question gère confortablement une liste de cette taille. Si elle était quelques fois plus grande, vous la diviserez en chunks et vous classerez chacun d’eux, puis vous appliquerez cette même étape de shortlist sur les vainqueurs.
CHOICE_INSTRUCTIONS = (
    "Which of these skills, if any, is the right one to load to help with the "
    "user's latest request?"
)
GATE_QUESTIONS = {
    "acts_on_user_system": (
        "Is the assistant being asked to act on the user's files, accounts, devices, "
        "or online services, rather than only to explain or advise?"
    ),
    "would_follow_documented_procedure": (
        "Would a careful expert answering this consult a specific documented procedure "
        "or set of commands, rather than answering from general understanding?"
    ),
    "prose_suffices": (
        "Could a knowledgeable generalist fully satisfy this request in prose, with "
        "no tools, no documentation, and no access to the user's files or accounts?"
    ),
}
INVERTED = {"prose_suffices"}  # a yes here points away from needing a skill


def build_state(request: str) -> dict:
    return {"request": request, "recent_context": ""}


@json_cache
def rank_wide(request: str) -> dict:
    """Request 1: rank all 182 skills, and score the request for whether a skill applies."""
    questions = {
        "which": Choice(
            instructions=CHOICE_INSTRUCTIONS,
            criteria={skill["name"]: skill["description"] for skill in ROSTER},
        )
    }
    for key, text in GATE_QUESTIONS.items():
        questions[f"gate::{key}"] = Noul(instructions=text)
    started = perf_counter()
    response = client.system_one(
        state=build_state(request), questions=questions, model=TYPESAFE_MODEL
    )
    ranked = sorted(
        response.answers["which"].probabilities.items(), key=lambda kv: -kv[1]
    )
    values = {
        key.removeprefix("gate::"): answer.noul
        for key, answer in response.answers.items()
        if key.startswith("gate::")
    }
    oriented = [(1.0 - v) if k in INVERTED else v for k, v in values.items()]
    return {
        "ranked": ranked[
            :12
        ],  # more than any shortlist needs, and keeps the cache small
        "gate": sum(oriented) / len(oriented),
        "values": values,
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


DEMO = [
    "Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so it syncs"
    " to my phone? Just write it up in whatever editor pops up.",
    "Can you put together a pitch deck skeleton (cover, situation overview, comps, precedent"
    " transactions, DCF, LBO) as a .pptx, using our firm-template.pptx for branding and"
    " footnoting each valuation number back to the cell it came from in the model?",
    "Post this announcement to my Mastodon account.",
]
for request in DEMO:
    wide = rank_wide(request)
    verdict = "suggest" if wide["gate"] >= GATE_THRESHOLD else "stay quiet"
    print(f'"{request[:78]}"')
    print(f"  needs a skill {wide['gate']:.2f} -> {verdict}   ({wide['seconds']}s)")
    for name, probability in wide["ranked"][:SHORTLIST]:
        print(f"    {probability:.3f}  {name:<38}{BY_NAME[name]['description']}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
needs a skill 0.75 -> suggest (0.31s)
0.990 apple-notes Manage Apple Notes via memo CLI: create, search, edit.
0.010 computer-use Drive the user's desktop in the background — clicking, ty...
0.000 concept-diagrams Generate flat, minimal educational SVG visuals as HTML.
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
needs a skill 0.76 -> suggest (0.16s)
0.700 powerpoint Create, read, edit .pptx decks, slides, notes, templates.
0.300 pptx-author Build PowerPoint decks headless with python-pptx.
0.000 chroma Embedding database for RAG and semantic search.
"Post this announcement to my Mastodon account."
needs a skill 0.78 -> suggest (0.16s)
0.550 xurl X/Twitter via xurl CLI: raw post search, posting, DM, media.
0.140 computer-use Drive the user's desktop in the background — clicking, ty...
0.080 openhands Delegate coding to OpenHands CLI (model-agnostic, LiteLLM).La demande de l’application Notes.app est sans équivoque, et son option principale est la bonne. Rien ce qu’un classement peut faire ne sauvera celle de Mastodon : les trois questions indiquent qu’une compétence est souhaitée, car publier sur un compte est une action, et avec une compétence pour publier sur X et rien pour Mastodon, la compétence la plus proche l’emporte de toute façon.
Cela laisse le deck. Les deux leaders ont .pptx compétences, et sur 60 caractères, la question Choice large place la compétence d’édition devant celle d’écriture, pour une demande concernant l’écriture d’un deck.
Étape 4 : reranker les trois premiers
Trois options laissent de la place pour la description complète ainsi que l’ouverture de chaque compétence propre à
SKILL.md, de sorte que la deuxième demande pose la même question à des preuves plus solides :
whichest une question deChoicesur la liste restreinte, le texte plus long servant de critères pour chaque option.fits::{name}correspond à une question deNoulpar candidat : cette compétence réalise-t-elle la tâche spécifique demandée ? Chaque réponse est donnée séparément, de sorte qu’elles puissent toutes obtenir un score faible, et une liste restreinte dont le score le plus élevé est inférieur à 0,30 est entièrement exclue.
RERANK_INSTRUCTIONS = (
    "Exactly one of these skills is the right one to load for the user's latest "
    "request. Which one? Read what each actually does, not just its name."
)


def rerank_criteria(names: tuple[str, ...], excerpt: int) -> dict[str, str]:
    return {
        name: f"{BY_NAME[name]['description_full']} — {BY_NAME[name]['body'][:excerpt]}"
        for name in names
    }


def rerank_questions(names: tuple[str, ...], excerpt: int) -> dict:
    questions = {
        "which": Choice(
            instructions=RERANK_INSTRUCTIONS, criteria=rerank_criteria(names, excerpt)
        )
    }
    for name in names:
        questions[f"fits::{name}"] = Noul(
            instructions=(
                f"Does the skill '{name}' do the specific thing the user's request asks "
                f"for? It is described as: {BY_NAME[name]['description_full']}"
            )
        )
    return questions


@json_cache
def rerank(request: str, names: tuple[str, ...], excerpt: int) -> dict:
    """Request 2: the same Choice over a shortlist, plus one absolute noul per candidate."""
    started = perf_counter()
    response = client.system_one(
        state=build_state(request),
        questions=rerank_questions(names, excerpt),
        model=TYPESAFE_MODEL,
    )
    return {
        "winner": response.answers["which"].choice,
        "fits": {
            key.removeprefix("fits::"): answer.noul
            for key, answer in response.answers.items()
            if key.startswith("fits::")
        },
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


for request in DEMO:
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        print(f'"{request[:78]}"\n  scored too low, nothing suggested\n')
        continue
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    best = max(result["fits"].values())
    verdict = result["winner"] if best >= FITS_THRESHOLD else "nothing fits"
    print(f'"{request[:78]}"')
    print(f"  was {shortlist[0]} -> {verdict}   ({result['seconds']}s)")
    for name in shortlist:
        print(f"    fits {result['fits'][name]:.2f}  {name}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
was apple-notes -> apple-notes (0.12s)
fits 0.60 apple-notes
fits 0.54 computer-use
fits 0.01 concept-diagrams
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
was powerpoint -> pptx-author (0.09s)
fits 0.73 powerpoint
fits 0.38 pptx-author
fits 0.02 chroma
"Post this announcement to my Mastodon account."
was xurl -> xurl (0.09s)
fits 0.56 xurl
fits 0.38 computer-use
fits 0.05 openhandsLes deux .pptx compétences se séparent une fois chacune apporte son propre texte : la demande de jeu bascule
vers la compétence d’authoring.
Les fits nouls et le Choice sont en désaccord là-dessus : les nouls attribuent un score plus élevé à la compétence d’édition, tandis que le Choice privilégie celle de création. Ils tranchent des aspects différents. Le Choice établit quelle compétence, et les nouls décident s’il faut dire quoi que ce soit.
La requête Mastodon survit aux deux vérifications : son meilleur fits noul est supérieur à 0,30, donc la recette suggère la compétence X pour une requête concernant Mastodon. La plupart des requêtes similaires sont interceptées.
Le deuxième passage ne peut rejeter que ce que le classement large lui fournit, et dans ce cas, il s’agissait de trois cas limites.
La fonction ci-dessous est la recette complète : deux requêtes et deux seuils, avec au plus un nom de compétence en retour.
Pour le pointer vers votre propre liste, remplacez hermes_roster.json. Chaque question ci-dessus lit
name, description, description_full, et body depuis ce fichier, et rien d’autre
ne connaît Hermes.
def suggest(request: str) -> tuple[str, ...]:
    """At most one skill name for a request, or () for "nothing here applies"."""
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        return ()
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    if max(result["fits"].values()) < FITS_THRESHOLD:
        return ()
    return (result["winner"],)


def suggestion_block(names: tuple[str, ...]) -> str:
    """What gets appended after the roster, in the suggestion.

    This string is a measured input rather than prose: it goes to the agent, so it is part
    of every graded turn's cache key. Editing a word here silently invalidates the shipped
    results and costs a live re-run to restore them.
    """
    body = (
        f"Relevant to the current request: {', '.join(names)}. Ignore this if it does not "
        "fit what the user actually asked for."
        if names
        else "No skill in the roster appears relevant to this request."
    )
    return f"\n\n<skill_relevance>\n{body}\n</skill_relevance>"


print(suggestion_block(suggest(DEMO[1])))
print(suggestion_block(suggest(DEMO[2])))
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>


<skill_relevance>
Relevant to the current request: xurl. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>
Étape 5 : mesurer la suggestion
Chacune des 488 requêtes est adressée à l’agent trois fois, une tour mesurée à la fois. Les exécutions ne diffèrent que par ce qui est dit à l’agent :
| ce qui va dans le prompt système | |
|---|---|
| agent seul | rien |
| agent avec une suggestion | ce que suggest() a retourné |
| agent recevant la réponse | le nom de la compétence de couverture, ou “rien ne s’applique” quand il n’y en a pas |
Le troisième n’est pas réalisable ; il s’agit du plafond contre lequel les deux autres sont mesurés.
La formulation de cette suggestion accomplit deux fonctions. Elle indique que la suggestion peut être ignorée, car insister davantage permet d’obtenir la conformité même sur des suggestions erronées, et une suggestion fausse est pire qu’aucune suggestion. Et un tour sans aucune suggestion envoie toujours une phrase l’indiquant ; ne rien envoyer laisserait sans opposition l’instruction propre au roster « pencher du côté du chargement ».
texts = [request["text"] for request in REQUESTS]
with ThreadPoolExecutor(max_workers=WORKERS) as pool:  # up to 488 x 2 TypeSafe requests
    suggested = dict(zip(texts, pool.map(suggest, texts)))
WIDE = {text: rank_wide(text) for text in texts}  # all cache hits now; reused below

arms = {
    "baseline": {},
    "TypeSafe": {
        request["text"]: suggestion_block(suggested[request["text"]])
        for request in REQUESTS
    },
    "oracle": {
        request["text"]: suggestion_block((request["gold"],) if request["gold"] else ())
        for request in REQUESTS
    },
}
scores = {
    arm: summarise(run_arm(arm, suggestions)) for arm, suggestions in arms.items()
}

print(f"{'run':<10}{'wrong loads':>13}{'needless loads':>16}")
for arm, row in scores.items():
    print(f"{arm:<10}{row['wrong_load']:>13.1%}{row['needless_load']:>16.1%}")


def fewer(metric: str) -> str:
    """The plain ratio between the two arms' error rates."""
    return f"{scores['baseline'][metric] / scores['TypeSafe'][metric]:.1f}x fewer"


print(
    f"\nbaseline -> TypeSafe:  {fewer('wrong_load')} wrong loads, "
    f"{fewer('needless_load')} needless ones"
)
run wrong loads needless loads
baseline 16.8% 9.8%
TypeSafe 7.3% 4.0%
oracle 2.5% 1.2%
baseline -> TypeSafe: 2.3x fewer wrong loads, 2.4x fewer needless onesmoved = [
(
baseline[p["text"]]["loaded"][:1] == [p["gold"]],
run_turn(AGENT_MODEL, "TypeSafe", p["text"], arms["TypeSafe"][p["text"]])[
"loaded"
][:1]
== [p["gold"]],
)
for p in POSITIVES
]
print(
f"of {len(POSITIVES)} covered requests: {sum(not b and a for b, a in moved)} the suggestion "
f"fixed, {sum(b and not a for b, a in moved)} it broke"
)of 315 covered requests: 37 the suggestion fixed, 7 it brokeLa suggestion corrige beaucoup plus de requêtes qu’elle n’en casse, mais elle en casse tout de même certaines que l’agent avait correctement traitées seul. Une suggestion fausse mais assurée est plus persuasive qu’aucune suggestion du tout, ce qui est le prix à payer pour la placer devant le tour.
SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

ARM_COLOR = {"baseline": BLUE, "TypeSafe": ORANGE, "oracle": MUTED}


def style(ax):
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)


panels = [
    ("wrong_load", f"wrong loads\n{len(POSITIVES)} covered requests"),
    ("needless_load", f"needless loads\n{len(NEGATIVES)} uncovered requests"),
]
names = list(scores)
fig, axes = plt.subplots(1, 2, figsize=(8.4, 3.6), facecolor=SURFACE)
for ax, (metric, title) in zip(axes, panels):
    style(ax)
    ax.grid(axis="y", color=GRID, linewidth=0.8)
    values = [scores[arm][metric] for arm in names]
    bars = ax.bar(
        names,
        values,
        0.58,
        color=[ARM_COLOR[arm] for arm in names],
        # the oracle is a ceiling, not a competitor: gray, and hatched so it never depends
        # on colour alone
        hatch=["", "", "///"],
        edgecolor=SURFACE,
        linewidth=1.2,
    )
    ax.bar_label(
        bars,
        labels=[f"{v:.1%}" for v in values],
        padding=3,
        color=INK2,
        fontsize=9,
    )
    ax.set_title(title, loc="left", color=INK2, fontsize=9.5)
    ax.set_ylim(0, max(values) * 1.28)
    ax.yaxis.set_major_formatter(PercentFormatter(xmax=1, decimals=0))
    ax.set_ylabel("% of those requests - lower is better", color=INK2, fontsize=9)
fig.suptitle(
    f"Hermes' {len(ROSTER)}-skill roster, {len(REQUESTS)} requests, {AGENT_MODEL}",
    x=0.02,
    ha="left",
    color=INK,
    fontsize=11,
)
fig.tight_layout()
display(fig)
plt.close(fig)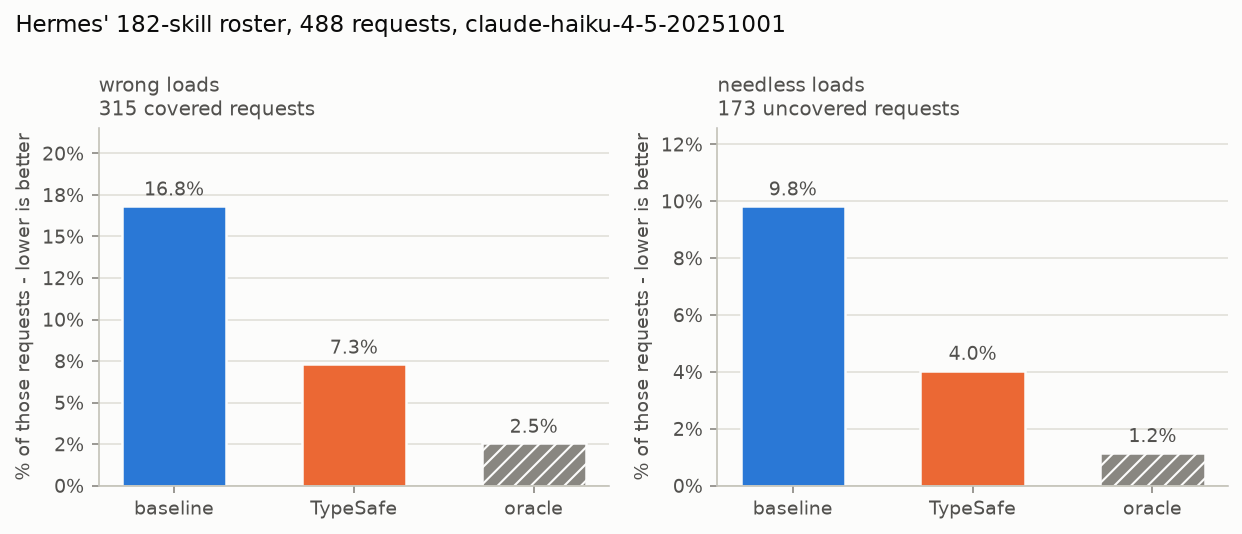
Ce que montrent les résultats
- Les chargements erronés sont passés de 16,8 % à 7,3 % et les chargements inutiles de 9,8 % à 4,0 %, ce qui explique la majeure partie de l’écart entre le fait de deviner à partir d’un index tronqué et celui de se voir fournir la réponse.
- Certaines requêtes que l’agent traitait correctement par lui-même deviennent incorrectes dès qu’une suggestion est ajoutée. Les effectifs sont indiqués ci-dessus.
Copiez cette forme lorsqu’un agent de votre côté gère un large effectif : un classement rapide de tout, puis un examen approfondi de deux ou trois éléments. Chaque étape peut revenir les mains vides.
Ouvrez-le dans le playground
Générer un lien de terrain de jeu pour la demande de jeu de cartes issue de l’étape 4, en utilisant la description complète et l’extrait du corps de chaque candidat comme critères.
demo_shortlist = tuple(name for name, _ in rank_wide(DEMO[1])["ranked"][:SHORTLIST])
playground_link = make_playground_link(
    build_state(DEMO[1]),
    rerank_questions(demo_shortlist, EXCERPT_CHARS),
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open the shortlist + questions in the TypeSafe playground]({playground_link})"
    )
)
Ouvrir la shortlist + les questions dans le playground TypeSafe →
Quoi de neuf
La même forme apparaît ailleurs : Routage d’intention pour acheminer vers un gestionnaire plutôt qu’une compétence, Confiance pour choisir les deux seuils, et Diffusion spéculative pour placer chaque question dans une seule requête.