 JevCode
Vorschlag für Fähigkeiten
Es wählt höchstens eine Fähigkeit für einen Agentenzug aus den 182 im Hermes-Katalog von Nous Research aus: Ein TypeSafe-Anfrage bewertet jede Fähigkeit und fragt, ob der Zug überhaupt eine benötigt; eine zweite liest die drei besten richtig und kann alle ablehnen. Der Name des Gewinners wird in eine einzige Zeile der Agenten-sy
Maschinell aus en übersetzt, nicht lektoriert. Nur als Kurzreferenz geeignet.

Agenten wählen Fähigkeiten aus, indem sie sie kürzen und alle in die Systemnachricht laden, was die Kosten erhöht, die Leistung der Fähigkeitsauswahl verschlechtert und für den Rest der Sitzung einen Kontextverfall verursacht. Wir lösen dies, indem wir pro Zug zwei TypeSafe-Anfragen verwenden, eine zur Rangordnung der Fähigkeiten und eine zur Überprüfung der Wahl, und reduzieren falsche Fähigkeitsladungen um mehr als die Hälfte.
Ein Agent mit einer großen Liste an Fähigkeiten trifft seine Wahl auf Basis fast keiner Informationen. Die Liste erreicht ihn als Index: eine Zeile pro Fähigkeit, wobei die Beschreibung abgeschnitten wird, damit der volle Text den Konversationsverlauf nicht überlagert. Hermes, die hier verwendete Agent-Plattform, kürzt standardmäßig auf 60 Zeichen. Bei dieser Breite liest sich die Fähigkeit, .pptx-Dateien zu bearbeiten, fast identisch mit derjenigen, die sie verfasst. Fordert man eine Pitch-Präsentation an, kann der Agent die falsche laden. In einem Schritt, in dem keine Fähigkeit überhaupt passt, lädt er dennoch eine, weil eine bloße Namensliste zu einer Vermutung einlädt.
Dieses Kochbuch lässt die Beschreibungen unverändert und verwendet stattdessen progressive Enthüllung, liest alle 182 Fähigkeiten kostengünstig durch und liest dann drei davon im Detail durch. Zwei TypeSafe Anfragen gehen der Entscheidung voraus, welche Fähigkeit geladen werden soll, falls überhaupt. Die erste bewertet jede Fähigkeit im Roster gegen den Zug des Benutzers und beantwortet, ob der Zug überhaupt eine Fähigkeit benötigt. Die zweite liest nur die drei besten erneut, nun mit der vollständigen Beschreibung jeder Fähigkeit und dem Beginn ihrer Anweisungen, und kann frei alle von ihnen ablehnen.
Der Name des Siegers wird in eine zusätzliche Zeile des System-Prompts des Agenten für diesen Durchlauf eingefügt:
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user
actually asked for.
</skill_relevance>
Der Agent behält seinen vollständigen Index und sein eigenes Urteil, und diese eine Zeile teilt ihm lediglich mit, welchen Eintrag er zuerst prüfen soll. Das Verzeichnis selbst ändert sich niemals, sodass jegliche Präfix-Caching-Strategien dafür weiterhin gültig bleiben. Über 488 Anfragen gegenüber claude-haiku-4-5-20251001 unter Verwendung der Fähigkeiten aus dem Hermes-Verzeichnis:
| lädt die falsche Fähigkeit | lädt eine, wenn keine passt | |
|---|---|---|
| Agent allein, nur mit seinem Katalog | 16,8 % | 9,8 % |
| Agent mit einem TypeSafe-Vorschlag | 7,3 % | 4,0 % |
| Agent erhält die richtige Antwort | 2,5 % | 1,2 % |
Die dritte Reihe zeigt, dass die Fehlerquote nicht null ist, denn ein Agent, dem die richtige Fähigkeit zur Verfügung steht, lädt sie nicht immer, und keine Auswahlmethode, sei sie noch so gut, kommt daran vorbei.
Du erhältst eine suggest()-Funktion, die höchstens einen Skill-Namen zurückgibt, eine
suggestion_block(), die sie für den System-Prompt einpackt, sowie das Harness, das die obige
Tabelle erzeugt hat und bereit ist, auf deine eigene Liste zu verweisen.
Richtung des Flusses: LR
| Knoten | Beschreibung | Gruppe |
|---|---|---|
C1 |
Anruf 1 - überfliege alle 182 Fähigkeiten | Anruf 1 - überfliege alle 182 Fähigkeiten |
Q1 |
Wahl: welche Fähigkeit passt? / alle 182, je eine Zeile | Anruf 1 - überfliege alle 182 Fähigkeiten |
N1 |
Nouls: überhaupt eine Fähigkeit nötig? / · auf deren Inhalte handeln? / · geschriebene Schritte befolgen? / · oder einfach nur reden? | Anruf 1 - überfliege alle 182 Fähigkeiten |
C2 |
Anruf 2 - lies diese 3 sorgfältig durch | Anruf 2 - lies diese 3 sorgfältig durch |
Q2 |
Wahl: welche der 3? / mit echten Details jetzt | Anruf 2 - lies diese 3 sorgfältig durch |
N2 |
Nouls: erfüllt jede einzelne / das wirklich? | Anruf 2 - lies diese 3 sorgfältig durch |
| Von | Bedingung | Zu |
|---|---|---|
Q1 |
— | N1 |
Q2 |
— | N2 |
C1 |
Top 3 | C2 |
C1 |
nichts / gilt | STOP |
C2 |
keine passt | STOP |
C2 |
ein Gewinner | OUT |
Einrichtung
- Installieren Sie den TypeSafe-Client, den Anthropic-Client und die gemeinsamen Cookbook-Helfer.
- Legen Sie einen TypeSafe-API-Schlüssel und einen Anthropic-Schlüssel für den zu messenden Agenten fest.
pip install anthropic matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/
export TYPESAFE_API_KEY=your-key-here
export ANTHROPIC_API_KEY=your-key-here
Hinweis: Die nachfolgenden Codeblöcke bilden ein einzelnes Skript, in der richtigen Reihenfolge. Um Schritt für Schritt vorzugehen, fügen Sie sie in der gezeigten Reihenfolge in eine einzige Datei ein.
Zwischengespeicherte Ergebnisse
JsonCache speichert das Ergebnis jedes Aufrufs, indiziert nach seinen Eingaben, sodass beim erneuten Ausführen die untenstehenden Zahlen wiederholt werden, anstatt eine der APIs aufzurufen. Lösche json_cache.json, um live auszuführen. Der veröffentlichte Lauf verwendete jev-1.12 und claude-haiku-4-5-20251001, erstellt am 2026-07-31.
import json
import os
from collections import defaultdict
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
from time import perf_counter

import anthropic
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.ticker import PercentFormatter
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
AGENT_MODEL = (
    "claude-haiku-4-5-20251001"  # the agent under test, pinned so scores are stable
)

SHORTLIST = 3  # candidates carried from the first request into the second
EXCERPT_CHARS = (
    700  # SKILL.md characters each candidate brings; the roster file stores 1600
)
GATE_THRESHOLD = (
    0.30  # mean of the three request nouls, below which nothing is suggested
)
FITS_THRESHOLD = (
    0.30  # a shortlist whose best "does this fit" noul is under this is dropped
)
WORKERS = 8  # small pool: enough to keep a live run to minutes, gentle on rate limits

assert EXCERPT_CHARS <= 1600, (
    "the shipped roster file stores 1600 body characters per skill"
)

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
agent = anthropic.Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY", "cache-only"))
json_cache = JsonCache(Path("json_cache.json"))
Schritt 1: Das Roster laden
hermes_roster.json enthält die 182 Fähigkeiten von
NousResearch/hermes-agent (MIT) an einem
festen Commit. Jeder Eintrag enthält den Namen und die Kategorie einer Fähigkeit, die Beschreibung, wie sie der Index
zeigt, die vollständige Beschreibung und den Anfang ihrer SKILL.md.
Der untenstehende Index sowie die Anweisungen darüber im Prompt wurden von Hermes kopiert.
ROSTER = json.loads(Path("hermes_roster.json").read_text(encoding="utf-8"))
BY_NAME = {skill["name"]: skill for skill in ROSTER}

# Verbatim from hermes-agent agent/prompt_builder.py:build_skills_system_prompt.
PREAMBLE = (
    "## Skills (mandatory)\n"
    "Before replying, scan the skills below. If a skill matches or is even partially relevant "
    "to your task, you MUST load it with skill_view(name) and follow its instructions. "
    "Err on the side of loading — it is always better to have context you don't need "
    "than to miss critical steps, pitfalls, or established workflows. "
    "Skills contain specialized knowledge — API endpoints, tool-specific commands, "
    "and proven workflows that outperform general-purpose approaches. Load the skill "
    "even if you think you could handle the task with basic tools like web_search or terminal. "
    "Skills also encode the user's preferred approach, conventions, and quality standards "
    "for tasks like code review, planning, and testing — load them even for tasks you "
    "already know how to do, because the skill defines how it should be done here.\n"
    "Whenever the user asks you to configure, set up, install, enable, disable, modify, "
    "or troubleshoot Hermes Agent itself — its CLI, config, models, providers, tools, "
    "skills, voice, gateway, plugins, or any feature — load the `hermes-agent` skill "
    "first. It has the actual commands (e.g. `hermes config set …`, `hermes tools`, "
    "`hermes setup`) so you don't have to guess or invent workarounds.\n"
    "If a skill has issues, fix it with skill_manage(action='patch').\n"
    "After difficult/iterative tasks, offer to save as a skill. "
    "If a skill you loaded was missing steps, had wrong commands, or needed "
    "pitfalls you discovered, update it before finishing.\n"
    "\n"
)
FOOTER = "\n\nOnly proceed without loading a skill if genuinely none are relevant to the task."
IDENTITY = (
    "You are Hermes, a capable AI assistant with access to tools and a library "
    "of skills. You help the user with coding, research, and everyday tasks.\n\n"
)


def render_index() -> str:
    """The body of <available_skills>: skills grouped by category, both sorted by name."""
    by_category = defaultdict(list)
    for skill in ROSTER:
        by_category[skill["category"]].append(skill)
    lines = []
    for category in sorted(by_category):
        lines.append(f"  {category}:")
        for skill in sorted(by_category[category], key=lambda s: s["name"]):
            lines.append(f"    - {skill['name']}: {skill['description']}")
    return "\n".join(lines)


CATALOG_PROMPT = (
    IDENTITY
    + PREAMBLE
    + "<available_skills>\n"
    + render_index()
    + "\n</available_skills>"
    + FOOTER
)

widths = [len(skill["description"]) for skill in ROSTER]
print(f"{len(ROSTER)} skills in {len({s['category'] for s in ROSTER})} categories")
print(f"roster prompt: {len(CATALOG_PROMPT):,} characters")
print(
    f"index description: {sum(widths) / len(widths):.0f} characters on average, "
    f"{max(widths)} at most"
)
print("\none category, as the agent reads it:")
index_lines = render_index().splitlines()
start = index_lines.index("  apple:")
end = next(
    i
    for i in range(start + 1, len(index_lines))
    if not index_lines[i].startswith("    ")
)
print("\n".join(index_lines[start:end]))
182 skills in 33 categories
roster prompt: 16,089 characters
index description: 54 characters on average, 60 at most
one category, as the agent reads it:
apple:
- apple-notes: Manage Apple Notes via memo CLI: create, search, edit.
- apple-reminders: Apple Reminders via remindctl: add, list, complete.
- findmy: Track Apple devices/AirTags via FindMy.app on macOS.
- imessage: Send and receive iMessages/SMS via the imsg CLI on macOS.Schritt 2: Bewerten Sie den Agenten anhand seiner eigenen
requests.json enthält 488 Single-Turn-Anfragen, wovon 315 von genau einer Fähigkeit abgedeckt sind und die anderen 173 von keiner.
Die abgedeckten Anfragen wurden von Claude Sonnet 5 aus jeder Fähigkeit eigener SKILL.md verfasst, sodass die Labels vertrauenswürdig sind und die Anfragen einfacher sind als die, die Nutzer senden.
Die 173 aufgedeckten Fälle wurden alle geschrieben, um Raten zu bestrafen: 85 alltägliche Anfragen, 42 technische Fragen, für die keine Kompetenz vorliegt (erklären Sie, was ein Monad ist), und 46, die nach etwas Spezifischem fragen, für das das Roster keine Kompetenz hat, wie posten Sie dies auf Mastodon bei einem Roster, das X und nichts anderes abdeckt.
Die Bewertung wertet nur die erste Antwort des Agenten aus. Beide Zahlen sind Fehlerquoten, daher ist ein niedrigerer Wert bei beiden besser:
- falsche Last: Unter den abgedeckten Anfragen der Anteil, bei dem der erste
skill_view-Aufruf nicht die abdeckende Fähigkeit war. Ein Zug, der gar nichts geladen hat, zählt als Fehlschlag. - unnötige Last: Unter den nicht abgedeckten Anfragen der Anteil, bei dem der Agent überhaupt
skill_viewaufgerufen hat.
REQUESTS = json.loads(Path("requests.json").read_text(encoding="utf-8"))
POSITIVES = [p for p in REQUESTS if p["gold"]]
NEGATIVES = [p for p in REQUESTS if not p["gold"]]

print(
    f"{len(REQUESTS)} requests: {len(POSITIVES)} covered by a skill "
    f"({len({p['gold'] for p in POSITIVES})} distinct skills), {len(NEGATIVES)} covered by none"
)
print(f"\ncovered   [{POSITIVES[0]['gold']}]  {POSITIVES[0]['text']}")
print(f"uncovered  {NEGATIVES[0]['text']}")
488 requests: 315 covered by a skill (171 distinct skills), 173 covered by none
covered [1password] I've got a config.yaml with `{{ op://app-prod/db/password }}` placeholders in it — can you set up my project to pull the real values in at runtime instead of hardcoding them?
uncovered Add these three cards to our Trello backlog.Der Vorschlag kommt in einen eigenen Block des System-Prompts, nach der Liste, statt darin, damit der Listentext in jeder Runde identisch bleibt, um Prefix-Caching zu ermöglichen.
Der Agent verfügt über einen minimalen Satz an Tools, einschließlich skill_view, um eine Fähigkeit mit einem Freitextnamen zu laden. Der Name muss exakt mit der Fähigkeit übereinstimmen, damit der Ladevorgang korrekt ist.
# Verbatim from hermes-agent tools/skills_tool.py:SKILL_VIEW_SCHEMA.
SKILL_VIEW_DESCRIPTION = (
    "Skills allow for loading information about specific tasks and workflows, as "
    "well as scripts and templates. Load a skill's full content or access its "
    "linked files (references, templates, scripts). First call returns SKILL.md "
    "content plus a 'linked_files' dict showing available references/templates/"
    "scripts. To access those, call again with file_path parameter."
)
TOOLS = [
    {
        "name": "skill_view",
        "description": SKILL_VIEW_DESCRIPTION,
        "input_schema": {
            "type": "object",
            "properties": {
                "name": {"type": "string", "description": "The skill name."}
            },
            "required": ["name"],
        },
    },
    {
        "name": "terminal",
        "description": "Run a shell command on the user's machine and return its output.",
        "input_schema": {
            "type": "object",
            "properties": {"command": {"type": "string"}},
            "required": ["command"],
        },
    },
    {
        "name": "read_file",
        "description": "Read a file from the user's filesystem.",
        "input_schema": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
    {
        "name": "web_search",
        "description": "Search the web and return result snippets.",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    },
]


@json_cache
def run_turn(model: str, arm: str, request: str, suggestion: str) -> dict:
    """One measured turn. ``arm`` is in the key so each arm samples independently."""
    system = [
        {"type": "text", "text": CATALOG_PROMPT, "cache_control": {"type": "ephemeral"}}
    ]
    if suggestion:
        system.append({"type": "text", "text": suggestion})  # after the breakpoint
    response = agent.messages.create(
        model=model,
        max_tokens=1024,
        system=system,
        tools=TOOLS,
        messages=[{"role": "user", "content": request}],
    )
    usage = response.usage
    return {
        "loaded": [
            str(block.input.get("name", ""))
            for block in response.content
            if block.type == "tool_use" and block.name == "skill_view"
        ],
        "input_tokens": usage.input_tokens or 0,
        "output_tokens": usage.output_tokens or 0,
    }


def summarise(turns: dict[str, dict]) -> dict[str, float]:
    """Two failure rates: wrong loads on covered requests, needless ones on uncovered."""
    hits = [turns[p["text"]]["loaded"][:1] == [p["gold"]] for p in POSITIVES]
    over = [bool(turns[p["text"]]["loaded"]) for p in NEGATIVES]
    return {
        # both metrics are errors, so the two columns read the same direction
        "wrong_load": 1 - sum(hits) / len(hits),
        "needless_load": sum(over) / len(over),
    }


def run_arm(arm: str, suggestions: dict[str, str]) -> dict[str, dict]:
    """One measured turn per request, in a small pool. 488 calls."""
    texts = [request["text"] for request in REQUESTS]
    with ThreadPoolExecutor(max_workers=WORKERS) as pool:
        turns = pool.map(
            lambda t: run_turn(AGENT_MODEL, arm, t, suggestions.get(t, "")), texts
        )
        return dict(zip(texts, turns))
Der Agent läuft zunächst nur mit seinem Personalplan, so wie er heute funktioniert. Seine zwei Fehlerquoten sind die Basislinie, gegen die der Rest des Kochbuchs misst.
baseline = run_arm("baseline", {})
base_scores = summarise(baseline)
print(
    f"wrong loads    {base_scores['wrong_load']:.1%}   ({len(POSITIVES)} covered requests)"
)
print(
    f"needless loads {base_scores['needless_load']:.1%}   ({len(NEGATIVES)} uncovered requests)"
)

# where the wrong loads land: a neighbour of the right skill, or somewhere unrelated?
misses = [
    (p["gold"], baseline[p["text"]]["loaded"][0])
    for p in POSITIVES
    if baseline[p["text"]]["loaded"] and baseline[p["text"]]["loaded"][0] != p["gold"]
]
same_category = sum(
    1
    for gold, got in misses
    if got in BY_NAME and BY_NAME[got]["category"] == BY_NAME[gold]["category"]
)
print(
    f"\nof {len(misses)} wrong first picks, {same_category} came from the right skill's own "
    f"category"
)
wrong loads 16.8% (315 covered requests)
needless loads 9.8% (173 uncovered requests)
of 36 wrong first picks, 10 came from the right skill's own categoryFalsche Lasten landen viel häufiger in der eigenen Kategorie der richtigen Fähigkeit, als es der Zufall erwarten ließe, daher besteht die eigentliche Herausforderung darin, einige täuschend ähnliche Fälle voneinander zu unterscheiden. Der Agent sucht bereits ungefähr am richtigen Ort.
Schritt 3: das gesamte Aufstellen rangieren
Eine Anfrage stellt zwei Arten von Fragen:
whichist eineChoice-Frage zu allen 182 Fähigkeitsnamen, wobei die Indexbeschreibung als Kriterium für jede Option dient (derselbe Text, den auch der Agent erhält). Ihre Wahrscheinlichkeiten bilden die Rangfolge.- drei
Noul-Fragen zur Anfrage, unten abgedruckt, die jeweils auf unterschiedliche Weise abfragen, ob eine Handlung statt einer Erklärung gewünscht wird.prose_sufficeszählt in die entgegengesetzte Richtung. Ihr Mittelwert entscheidet, ob überhaupt ein Vorschlag gemacht wird, und unter 0,30 wird nichts vorgeschlagen.
Beide werden in einer Anfrage gesendet, sodass das Ranking und die Prüfung einen Roundtrip kosten.
Schreibe diese drei, um zu fragen, ob eine Aktion gewünscht ist. Eine Frage zur Materie wird erklären, was eine Monad ist nicht von einer Anfrage trennen, die eine Fähigkeit benötigt, da beide zur Software gehören.
Eine Choice Frage passt bei dieser Größe gut in die Übersicht. Ein paar Mal größer und Sie würden sie in Blöcke aufteilen und jeden einzeln bewerten, dann diesen gleichen Kurzlisten-Schritt über die Gewinner laufen lassen.
CHOICE_INSTRUCTIONS = (
    "Which of these skills, if any, is the right one to load to help with the "
    "user's latest request?"
)
GATE_QUESTIONS = {
    "acts_on_user_system": (
        "Is the assistant being asked to act on the user's files, accounts, devices, "
        "or online services, rather than only to explain or advise?"
    ),
    "would_follow_documented_procedure": (
        "Would a careful expert answering this consult a specific documented procedure "
        "or set of commands, rather than answering from general understanding?"
    ),
    "prose_suffices": (
        "Could a knowledgeable generalist fully satisfy this request in prose, with "
        "no tools, no documentation, and no access to the user's files or accounts?"
    ),
}
INVERTED = {"prose_suffices"}  # a yes here points away from needing a skill


def build_state(request: str) -> dict:
    return {"request": request, "recent_context": ""}


@json_cache
def rank_wide(request: str) -> dict:
    """Request 1: rank all 182 skills, and score the request for whether a skill applies."""
    questions = {
        "which": Choice(
            instructions=CHOICE_INSTRUCTIONS,
            criteria={skill["name"]: skill["description"] for skill in ROSTER},
        )
    }
    for key, text in GATE_QUESTIONS.items():
        questions[f"gate::{key}"] = Noul(instructions=text)
    started = perf_counter()
    response = client.system_one(
        state=build_state(request), questions=questions, model=TYPESAFE_MODEL
    )
    ranked = sorted(
        response.answers["which"].probabilities.items(), key=lambda kv: -kv[1]
    )
    values = {
        key.removeprefix("gate::"): answer.noul
        for key, answer in response.answers.items()
        if key.startswith("gate::")
    }
    oriented = [(1.0 - v) if k in INVERTED else v for k, v in values.items()]
    return {
        "ranked": ranked[
            :12
        ],  # more than any shortlist needs, and keeps the cache small
        "gate": sum(oriented) / len(oriented),
        "values": values,
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


DEMO = [
    "Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so it syncs"
    " to my phone? Just write it up in whatever editor pops up.",
    "Can you put together a pitch deck skeleton (cover, situation overview, comps, precedent"
    " transactions, DCF, LBO) as a .pptx, using our firm-template.pptx for branding and"
    " footnoting each valuation number back to the cell it came from in the model?",
    "Post this announcement to my Mastodon account.",
]
for request in DEMO:
    wide = rank_wide(request)
    verdict = "suggest" if wide["gate"] >= GATE_THRESHOLD else "stay quiet"
    print(f'"{request[:78]}"')
    print(f"  needs a skill {wide['gate']:.2f} -> {verdict}   ({wide['seconds']}s)")
    for name, probability in wide["ranked"][:SHORTLIST]:
        print(f"    {probability:.3f}  {name:<38}{BY_NAME[name]['description']}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
needs a skill 0.75 -> suggest (0.31s)
0.990 apple-notes Manage Apple Notes via memo CLI: create, search, edit.
0.010 computer-use Drive the user's desktop in the background — clicking, ty...
0.000 concept-diagrams Generate flat, minimal educational SVG visuals as HTML.
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
needs a skill 0.76 -> suggest (0.16s)
0.700 powerpoint Create, read, edit .pptx decks, slides, notes, templates.
0.300 pptx-author Build PowerPoint decks headless with python-pptx.
0.000 chroma Embedding database for RAG and semantic search.
"Post this announcement to my Mastodon account."
needs a skill 0.78 -> suggest (0.16s)
0.550 xurl X/Twitter via xurl CLI: raw post search, posting, DM, media.
0.140 computer-use Drive the user's desktop in the background — clicking, ty...
0.080 openhands Delegate coding to OpenHands CLI (model-agnostic, LiteLLM).Die Notes.app-Anfrage ist eindeutig, und ihre erste Option ist die richtige. Nichts, was ein Ranking tun kann, wird die Mastodon-Option retten: Die drei Fragen sagen aus, dass eine Fähigkeit gewünscht ist, weil das Posten in ein Konto eine Aktion ist, und mit einer Fähigkeit zum Posten in X und keiner für Mastodon gewinnt ohnehin die nächstgelegene Fähigkeit.
Das lässt das Deck übrig. Beide Anführer haben .pptx Fähigkeiten, und bei 60 Zeichen stellt die breite Choice-Frage die Bearbeitungsfähigkeit der Autorisierungsfähigkeit voran, für eine Anfrage zur Erstellung eines Decks.
Schritt 4: Neubewertung der Top drei
Drei Optionen lassen Platz für die vollständige Beschreibung sowie den Einstieg in die jeweilige Fähigkeit
SKILL.md, sodass die zweite Anfrage dieselbe Frage an bessere Belege stellt:
whichist eineChoiceFrage zur Vorauswahl, wobei der längere Text die Kriterien für jede Option darstellt.fits::{name}ist eineNoulFrage pro Kandidat: Erfüllt diese Fähigkeit die spezifische Sache, die die Anfrage verlangt? Jede wird separat beantwortet, sodass alle niedrig ausfallen können, und eine Vorauswahl, deren höchster Wert unter 0,30 liegt, wird vollständig verworfen.
RERANK_INSTRUCTIONS = (
    "Exactly one of these skills is the right one to load for the user's latest "
    "request. Which one? Read what each actually does, not just its name."
)


def rerank_criteria(names: tuple[str, ...], excerpt: int) -> dict[str, str]:
    return {
        name: f"{BY_NAME[name]['description_full']} — {BY_NAME[name]['body'][:excerpt]}"
        for name in names
    }


def rerank_questions(names: tuple[str, ...], excerpt: int) -> dict:
    questions = {
        "which": Choice(
            instructions=RERANK_INSTRUCTIONS, criteria=rerank_criteria(names, excerpt)
        )
    }
    for name in names:
        questions[f"fits::{name}"] = Noul(
            instructions=(
                f"Does the skill '{name}' do the specific thing the user's request asks "
                f"for? It is described as: {BY_NAME[name]['description_full']}"
            )
        )
    return questions


@json_cache
def rerank(request: str, names: tuple[str, ...], excerpt: int) -> dict:
    """Request 2: the same Choice over a shortlist, plus one absolute noul per candidate."""
    started = perf_counter()
    response = client.system_one(
        state=build_state(request),
        questions=rerank_questions(names, excerpt),
        model=TYPESAFE_MODEL,
    )
    return {
        "winner": response.answers["which"].choice,
        "fits": {
            key.removeprefix("fits::"): answer.noul
            for key, answer in response.answers.items()
            if key.startswith("fits::")
        },
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


for request in DEMO:
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        print(f'"{request[:78]}"\n  scored too low, nothing suggested\n')
        continue
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    best = max(result["fits"].values())
    verdict = result["winner"] if best >= FITS_THRESHOLD else "nothing fits"
    print(f'"{request[:78]}"')
    print(f"  was {shortlist[0]} -> {verdict}   ({result['seconds']}s)")
    for name in shortlist:
        print(f"    fits {result['fits'][name]:.2f}  {name}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
was apple-notes -> apple-notes (0.12s)
fits 0.60 apple-notes
fits 0.54 computer-use
fits 0.01 concept-diagrams
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
was powerpoint -> pptx-author (0.09s)
fits 0.73 powerpoint
fits 0.38 pptx-author
fits 0.02 chroma
"Post this announcement to my Mastodon account."
was xurl -> xurl (0.09s)
fits 0.56 xurl
fits 0.38 computer-use
fits 0.05 openhandsDie beiden .pptx Fähigkeiten trennen sich, sobald jede von ihnen ihren eigenen Text beisteuert: Die Deck-Anfrage wechselt zur Authoring-Fähigkeit.
Die fits Noul und die Choice sind sich dort nicht einig: Die Noul bewerten die Bearbeitungsfähigkeit höher, während die Choice die Autorenschaftsfähigkeit wählt. Sie entscheiden über unterschiedliche Dinge. Die Choice legt fest, welche Fähigkeit, und die Noul entscheiden, ob überhaupt etwas gesagt wird.
Die Mastodon-Anfrage übersteht beide Prüfungen: Ihr bester fits Noul liegt über 0,30, daher schlägt das Rezept die X-Fähigkeit für eine Anfrage zu Mastodon vor. Die meisten ähnlichen Anfragen werden so erfasst. Die zweite Durchlaufphase kann nur das ablehnen, was ihr das breite Ranking vorgibt, und hier waren das drei knappe Fehltreffer.
Die folgende Funktion ist das gesamte Rezept: zwei Anfragen und zwei Schwellenwerte, wobei höchstens ein Funktionsname zurückgegeben wird.
Um es auf deine eigene Liste zu richten, ersetze hermes_roster.json. Jede der obigen Fragen liest name, description, description_full und body aus dieser Datei aus, und sonst weiß nichts über Hermes.
def suggest(request: str) -> tuple[str, ...]:
    """At most one skill name for a request, or () for "nothing here applies"."""
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        return ()
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    if max(result["fits"].values()) < FITS_THRESHOLD:
        return ()
    return (result["winner"],)


def suggestion_block(names: tuple[str, ...]) -> str:
    """What gets appended after the roster, in the suggestion.

    This string is a measured input rather than prose: it goes to the agent, so it is part
    of every graded turn's cache key. Editing a word here silently invalidates the shipped
    results and costs a live re-run to restore them.
    """
    body = (
        f"Relevant to the current request: {', '.join(names)}. Ignore this if it does not "
        "fit what the user actually asked for."
        if names
        else "No skill in the roster appears relevant to this request."
    )
    return f"\n\n<skill_relevance>\n{body}\n</skill_relevance>"


print(suggestion_block(suggest(DEMO[1])))
print(suggestion_block(suggest(DEMO[2])))
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>


<skill_relevance>
Relevant to the current request: xurl. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>
Schritt 5: Vorschlag messen
Jede der 488 Anfragen wird dreimal an den Agenten gesendet, jeweils eine gemessene Runde. Die Durchläufe unterscheiden sich nur darin, was dem Agenten mitgeteilt wird:
| was in den System-Prompt gehört | |
|---|---|
| Agent allein | nichts |
| Agent mit Vorschlag | alles, was suggest() zurückgegeben hat |
| Agent mit der Antwort | der Name der abdeckenden Fähigkeit oder „nichts trifft zu“, wenn keine vorhanden ist |
Das dritte ist nicht erreichbar; es ist die Obergrenze, an der sich die anderen beiden messen lassen müssen.
Die Formulierung dieses Vorschlags erfüllt zwei Funktionen. Sie besagt, dass der Vorschlag ignoriert werden kann, weil ein stärkeres Durchsetzen auch bei falschen Vorschlägen Compliance erzwingt, und ein falscher Vorschlag ist schlimmer als keiner. Und ein Zug ohne Vorschlag sendet dennoch einen Satz, der dies mitteilt; das vollständige Unterlassen würde die eigene Anweisung des Rosters „im Zweifel zur Ladung neigen“ unangefochten lassen.
texts = [request["text"] for request in REQUESTS]
with ThreadPoolExecutor(max_workers=WORKERS) as pool:  # up to 488 x 2 TypeSafe requests
    suggested = dict(zip(texts, pool.map(suggest, texts)))
WIDE = {text: rank_wide(text) for text in texts}  # all cache hits now; reused below

arms = {
    "baseline": {},
    "TypeSafe": {
        request["text"]: suggestion_block(suggested[request["text"]])
        for request in REQUESTS
    },
    "oracle": {
        request["text"]: suggestion_block((request["gold"],) if request["gold"] else ())
        for request in REQUESTS
    },
}
scores = {
    arm: summarise(run_arm(arm, suggestions)) for arm, suggestions in arms.items()
}

print(f"{'run':<10}{'wrong loads':>13}{'needless loads':>16}")
for arm, row in scores.items():
    print(f"{arm:<10}{row['wrong_load']:>13.1%}{row['needless_load']:>16.1%}")


def fewer(metric: str) -> str:
    """The plain ratio between the two arms' error rates."""
    return f"{scores['baseline'][metric] / scores['TypeSafe'][metric]:.1f}x fewer"


print(
    f"\nbaseline -> TypeSafe:  {fewer('wrong_load')} wrong loads, "
    f"{fewer('needless_load')} needless ones"
)
run wrong loads needless loads
baseline 16.8% 9.8%
TypeSafe 7.3% 4.0%
oracle 2.5% 1.2%
baseline -> TypeSafe: 2.3x fewer wrong loads, 2.4x fewer needless onesmoved = [
(
baseline[p["text"]]["loaded"][:1] == [p["gold"]],
run_turn(AGENT_MODEL, "TypeSafe", p["text"], arms["TypeSafe"][p["text"]])[
"loaded"
][:1]
== [p["gold"]],
)
for p in POSITIVES
]
print(
f"of {len(POSITIVES)} covered requests: {sum(not b and a for b, a in moved)} the suggestion "
f"fixed, {sum(b and not a for b, a in moved)} it broke"
)of 315 covered requests: 37 the suggestion fixed, 7 it brokeDer Vorschlag behebt deutlich mehr Anfragen, als er stört, doch er bricht einige Fälle, die der Agent bereits korrekt gelöst hatte. Ein selbstbewusster, falscher Vorschlag wirkt überzeugender als gar kein Vorschlag – das ist der Preis dafür, ihn vor der Antwort zu platzieren.
SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

ARM_COLOR = {"baseline": BLUE, "TypeSafe": ORANGE, "oracle": MUTED}


def style(ax):
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)


panels = [
    ("wrong_load", f"wrong loads\n{len(POSITIVES)} covered requests"),
    ("needless_load", f"needless loads\n{len(NEGATIVES)} uncovered requests"),
]
names = list(scores)
fig, axes = plt.subplots(1, 2, figsize=(8.4, 3.6), facecolor=SURFACE)
for ax, (metric, title) in zip(axes, panels):
    style(ax)
    ax.grid(axis="y", color=GRID, linewidth=0.8)
    values = [scores[arm][metric] for arm in names]
    bars = ax.bar(
        names,
        values,
        0.58,
        color=[ARM_COLOR[arm] for arm in names],
        # the oracle is a ceiling, not a competitor: gray, and hatched so it never depends
        # on colour alone
        hatch=["", "", "///"],
        edgecolor=SURFACE,
        linewidth=1.2,
    )
    ax.bar_label(
        bars,
        labels=[f"{v:.1%}" for v in values],
        padding=3,
        color=INK2,
        fontsize=9,
    )
    ax.set_title(title, loc="left", color=INK2, fontsize=9.5)
    ax.set_ylim(0, max(values) * 1.28)
    ax.yaxis.set_major_formatter(PercentFormatter(xmax=1, decimals=0))
    ax.set_ylabel("% of those requests - lower is better", color=INK2, fontsize=9)
fig.suptitle(
    f"Hermes' {len(ROSTER)}-skill roster, {len(REQUESTS)} requests, {AGENT_MODEL}",
    x=0.02,
    ha="left",
    color=INK,
    fontsize=11,
)
fig.tight_layout()
display(fig)
plt.close(fig)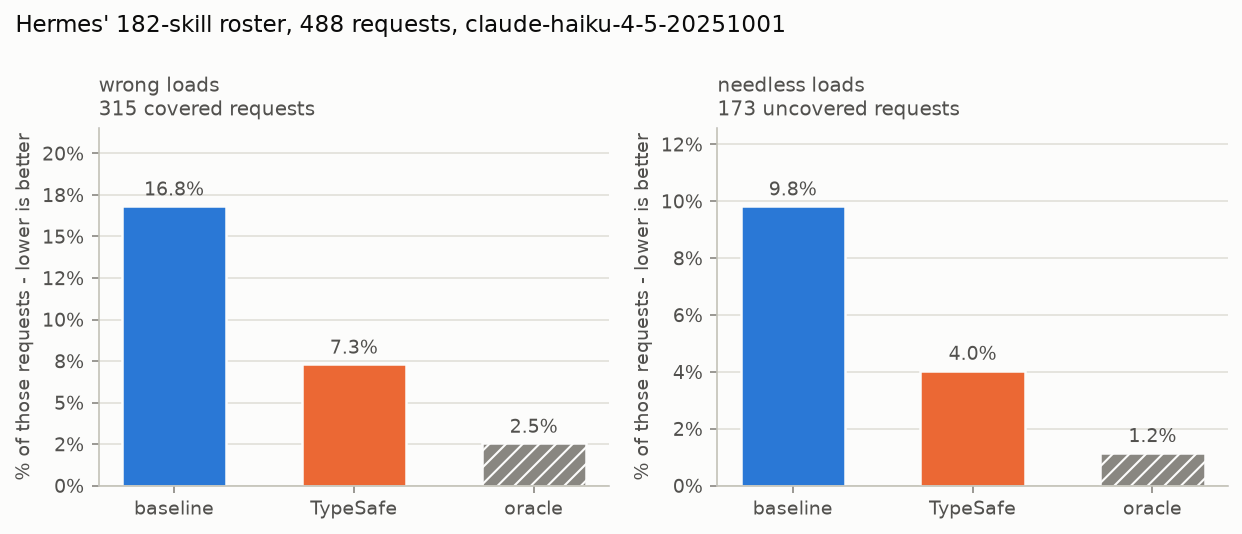
Was die Ergebnisse zeigen
- Falsche Ladevorgänge sanken von 16,8 % auf 7,3 % und unnötige von 9,8 % auf 4,0 %, was den Großteil der Lücke zwischen dem Raten anhand eines abgeschnittenen Index und dem direkten Erhalt der Antwort ausmacht.
- Einige Anfragen, die der Agent ursprünglich korrekt beantwortete, werden falsch, sobald ein Vorschlag angehängt wird. Die Zählwerte stehen oben.
Kopiere diese Struktur, wenn ein Agent von dir eine große Liste verwaltet: eine günstige Rangliste über alles, dann ein genauer Blick auf zwei oder drei. Jeder Schritt kann leer ausgehen.
Öffnen Sie es im Playground
Erstelle einen Playground-Link für die Deck-Anfrage aus Schritt 4, indem du die vollständige Beschreibung und den Textauszug jedes Kandidaten als Kriterien verwendest.
demo_shortlist = tuple(name for name, _ in rank_wide(DEMO[1])["ranked"][:SHORTLIST])
playground_link = make_playground_link(
    build_state(DEMO[1]),
    rerank_questions(demo_shortlist, EXCERPT_CHARS),
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open the shortlist + questions in the TypeSafe playground]({playground_link})"
    )
)
Die Shortlist + Fragen im TypeSafe-Playground öffnen →
Was kommt als Nächstes
Die gleiche Struktur taucht auch anderswo auf: Intent Routing für die Weiterleitung an einen Handler statt an eine Fähigkeit, Confidence für die Auswahl der beiden Schwellenwerte und Speculative Fan-Out für die Bündelung jeder Frage in einer einzigen Anfrage.