 JevCode
Selbstkonsistenz: Entscheidungen
Fügen Sie ein unsicheres Ergebnis zu den Moderationsentscheidungen hinzu und vergleichen Sie die Übereinstimmung der Labels mit dem Anteil der automatischen Maßnahmen.
Maschinell aus en übersetzt, nicht lektoriert. Nur als Kurzreferenz geeignet.

Dieses Kochbuch nimmt einen grenzwertigen Benutzerbeitrag, wendet einen Moderationsraster 15 Mal darauf an
und prüft, ob jede Antwort über die Wiederholungen hinweg stabil bleibt. Jede Prüfung ist ein
Choice, sodass jede Antwort ein Label aus einem festen Satz ist. In einer Moderationspipeline
ist dieses Label die Routing-Entscheidung: entfernen oder stehen lassen, eskalieren oder automatisch lösen, an die
Drohung-, Spam- oder allgemeine Warteschlange senden. Wenn das Label von einem Durchlauf zum nächsten wackelt, wird
derselbe Beitrag aus keinem guten Grund an verschiedene Stellen geroutet.
Die Rubrik umfasst 8 Choice Fragen, und jeder Lauf ist ein Aufruf, der alle 8 beantwortet. Wir führen
15
Wiederholungen pro Bedingung durch, wobei eine Bedingung ein Modell plus eine Einstellung ist, und zeichnen jedes
zurückgegebene Label auf.
Die Bedingungen:
- Nicht-Reasoning-LLMs
claude-haiku-4-5undgpt-5.4-mini, bei Temperatur0und dem API-Standardwert. - Reasoning-LLMs
gpt-5.5undclaude-opus-4-8, die keinen Temperatur-Drehregler haben. - TypeSafe: ein
system_one-Aufruf über die 8Choice-Fragen hinweg, mit einem neuenuid- Feld (ein einmaliger, wegwerfbarer Wert) bei jedem Aufruf, passend zum Noul-Cookbook-Setup.
Worauf man achten sollte: Ausgewählte Labels können innerhalb einer einzigen Bedingung umschlagen, einschließlich TypeSafe, und Bedingungen widersprechen sich gegenseitig.
In diesem Lauf wiederholen die LLM-Verteilungseinstellungen ihre Pluralitätslabels 87,5 % bis 100 % der Zeit, im Vergleich zu 90,8 % bei TypeSafe. TypeSafe weist eine geringere mittlere Wahrscheinlichkeitsvariation als fünf der sechs LLM-Verteilungsbedingungen auf; Haiku bei Temperatur 0 variiert weniger. Nahe liegende Wahrscheinlichkeiten ermöglichen dennoch Routing-Änderungen: TypeSafe wechselt bei 2 von 8 Fragen.
Für Anwendungsentscheidungen fordern wir ebenfalls eine maximale Wahrscheinlichkeit von mindestens 0.60; andernfalls
ist das Ergebnis uncertain und wird zur menschlichen Überprüfung weitergeleitet. Die Übereinstimmung von TypeSafe steigt dann auf
99,2 %, mit automatischen Labels bei 74,2 % der Antworten. Wir zeigen die Rohausgaben und wenden den
gleichen Schwellenwert auf LLM-Wahrscheinlichkeitsbedingungen an, wobei Auslassungen und Änderungen sichtbar bleiben.
Einrichtung
pip install anthropic openai matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/dann TYPESAFE_API_KEY, ANTHROPIC_API_KEY und OPENAI_API_KEY festlegen.
Dieser Lauf verwendet jev-latest auf der Produktions-API, abgerufen am 2026-09-11.
import hashlib
import json
import os
import textwrap
from collections import Counter
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
from secrets import token_hex
from statistics import mean

from time import perf_counter

import anthropic
import matplotlib
import matplotlib.pyplot as plt
import numpy as np
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from matplotlib.colors import ListedColormap
from openai import OpenAI
from typesafe_sdk import Choice, TypeSafeClient

matplotlib.use("Agg")  # headless render

BASE_MODELS = [
    "claude-haiku-4-5",
    "gpt-5.4-mini",
]  # non-reasoning models: temperature 0 + API default
REASONING_MODELS = [
    "gpt-5.5",
    "claude-opus-4-8",
]  # reasoning models: think first, no temperature
TYPESAFE_MODEL = "jev-latest"  # the TypeSafe model
NUM_SAMPLES = 15  # repeated post+rubric calls per condition
MIN_CHOICE_PROBABILITY = 0.60  # illustrative automatic-action threshold

LLM_PRICES = {  # $ per 1M tokens (input, output); prices + model ids as of 2026-07, see README
    "claude-haiku-4-5": (1.00, 5.00),
    "gpt-5.4-mini": (0.75, 4.50),
    "gpt-5.5": (5.00, 30.00),
    "claude-opus-4-8": (5.00, 25.00),
}
TYPESAFE_PRICE = (0.042, 0.00)  # Historical TypeSafe rate, as of 2026-08

anthropic_client = anthropic.Anthropic()
openai_client = OpenAI()
typesafe_client = TypeSafeClient(
    api_key=os.environ["TYPESAFE_API_KEY"],
    base_url="https://api.typesafe.ai",
    timeout=30.0,
)
Der Zustand: ein Benutzerbeitrag an der Grenze, als JSON
Der folgende Beitrag ist darauf ausgelegt, auf der Zaunlinie zu balancieren. Die Sprache ist hitzig und beleidigend, gerichtet teils gegen eine Person und teils gegen das Argument und die Community. Er enthält eine Einladung außerhalb der Plattform (einen Link, der Menschen auf eine andere Site zieht), einen vorherigen Verstoß auf dem Konto und vier Nutzerberichte, und die drohende Formulierung ist nie sauber ausgedrückt.
Hier gibt es keine offensichtliche Einzelantwort, und genau das ist der Punkt: Kleine Wortunterschiede sollten denselben Beitrag nicht willkürlich zwischen den Durchsetzungspfaden verschieben.
Die LLMs erhalten json.dumps(POST) im Prompt. TypeSafe erhält das Python-Dict direkt.
POST = {
    "post_id": "P-88213",
    "author": {
        "user_id": "u/4471",
        "account_age_days": 38,
        "prior_strikes": 1,
        "followers": 210,
    },
    "context": {
        "surface": "public reply",
        "in_reply_to": "another user defending a game patch",
        "community": "r/gamedebates",
    },
    "content": {
        "text": (
            "Are you seriously this dense? Anyone who defends that patch is a complete clown and "
            "should be embarrassed to even post here. People like you are what's ruining this "
            "community and honestly you need to be dealt with. Come say it to my face, invite's "
            "right here. Keep it up and I'll end your whole channel."
        ),
        "has_link": True,
        "link_domain": "discord.gg",
        "language": "en",
    },
    "reports": {"user_reports": 4, "report_reasons": ["harassment", "spam", "threat"]},
}
Die Rubrik: 8 Choice Fragen
Jede Frage enthält ein key, eine Zeile mit Anweisungen und einen festen Label-Satz. Die Labels innerhalb einer Frage sind sich gegenseitig ausschließend (es gilt genau eines), und jedes trägt eine kurze Beschreibung. TypeSafe gibt ein ausgewähltes choice sowie eine probabilities-Verteilung über die Labels zurück. Die LLMs werden gebeten, dieselben Label-Sätze zu verwenden, wodurch jede Zeile vergleichbar bleibt.
QUESTIONS = {
    "category": (
        "What is the single most applicable content-policy category for this post?",
        {
            "None": "No policy violation of any kind.",
            "Harass": "Insults or demeans a person, with no threat of harm and no protected-class attack.",
            "Hate": "Attacks a person or group over a protected characteristic (race, religion, gender, ...).",
            "Violence": "Makes a credible threat of harm or incites violence against someone.",
            "Spam": "Unsolicited promotion or link spam, with no personal attack.",
            "Sexual": "Sexual or adult content.",
        },
    ),
    "primary_risk": (
        "What is the primary moderation risk that should drive triage for this post?",
        {
            "Harassment": "Personal attack or targeted abuse is the main risk.",
            "Violence": "A threat of harm or intimidation is the main risk.",
            "LinkAbuse": "External-link or off-platform coordination risk is the main risk.",
            "AccountHistory": "Prior account history or repeat behavior is the main risk.",
            "LowRisk": "No meaningful moderation risk is present.",
        },
    ),
    "target": (
        "Who or what is the content primarily directed at?",
        {
            "None": "Not directed at anyone in particular.",
            "Person": "Directed at one specific individual.",
            "Group": "Directed at a protected group or class.",
            "Platform": "Directed at the community or platform itself, not a person.",
        },
    ),
    "action": (
        "What enforcement action should be taken on this post?",
        {
            "Allow": "Leave the post up with no action.",
            "Warn": "Leave the post up but attach a warning label.",
            "Remove": "Remove the post, but do not penalize the account.",
            "Strike": "Remove the post and add a strike to the account.",
            "Escalate": "Take no automated action; hold for a human decision.",
        },
    ),
    "queue": (
        "Which single moderation queue should own this post?",
        {
            "Auto": "Auto-resolve; no human queue needed.",
            "General": "General moderation queue.",
            "Threat": "Threat / violence response queue.",
            "Spam": "Spam and platform-abuse queue.",
            "TSLead": "Trust-and-safety lead / senior queue.",
        },
    ),
    "link_handling": (
        "How should any external link or off-platform invite in the post be handled?",
        {
            "Allow": "Leave the link in place.",
            "RmLink": "Strip or disable the link but keep the post.",
            "Brigade": "Treat the link as coordinated brigading and action it as abuse.",
            "Escalate": "Send the link to a specialist to assess before acting.",
        },
    ),
    "review_path": (
        "Who should make the final call on this post?",
        {
            "Auto": "Automated action; no human review.",
            "Human": "A frontline human moderator makes the call.",
            "Senior": "A senior or specialist reviewer is required.",
            "Legal": "Route to legal or law-enforcement escalation.",
        },
    ),
    "severity": (
        "What is the overall severity of this post?",
        {
            "None": "No violation.",
            "Low": "Rude or dismissive, but essentially harmless.",
            "Medium": "Personal harassment with no clearly credible threat.",
            "High": "Harassment together with a threat that could be read as credible.",
        },
    ),
}
Wie wir fragen
Jeder LLM-Aufruf ist ein Prompt, der json.dumps(POST), alle 8 Fragen und jedes erlaubte Label enthält. Es gibt zwei Antwortformate. Im Verteilungsmodus gibt das Modell ein JSON-Objekt pro Frage mit einer Wahrscheinlichkeit für jedes Label zurück. Im Single-Pick-Modus gibt es ein einzelnes, nacktes Label pro Frage zurück, und unsere Analyse legt die gesamte Wahrscheinlichkeitsmasse auf dieses Label.
Der TypeSafe-Aufruf ist eine system_one Anfrage über denselben Beitrag und dieselben 8
Choice Fragen, die eine Verteilung pro Frage zurückgibt.
Jede Abfrage erhält zudem einen frischen uid, einen einmaligen, vergänglichen Wert, der sich bei jedem Durchlauf ändert, während der Beitrag und die Bewertungskriterien unverändert bleiben. Er erscheint im LLM-Prompt sowie als zusätzliches Feld im TypeSafe-Status. Diese Konfiguration kann die Empfindlichkeit gegenüber dem irrelevanten Feld nicht von Variationen trennen, die auch bei identischen Anfragen auftreten würden.
Jeder Helfer gibt die Antwort, eine geschätzte Kosten und die Latenz der Hin- und Rückreise zurück.
def argmax_label(values: list, labels: list[str]) -> str | None:
    """The label with the most probability mass, or ``None`` if any value is missing or
    non-numeric -- a partially parsed distribution never yields a confident-looking pick."""
    numeric = [_numeric_value(value) for value in values]
    if any(value is None for value in numeric):
        return None
    return labels[int(np.argmax(numeric))]


def choice_decision_with_uncertainty(values: list, labels: list[str]) -> str | None:
    """Abstain below the action threshold; retain invalid results as parse failures."""
    label = argmax_label(values, labels)
    if label is None:
        return None
    probabilities = [float(value) for value in values]
    if any(value < 0 or value > 1 for value in probabilities):
        return None
    return label if max(probabilities) >= MIN_CHOICE_PROBABILITY else "uncertain"


def choice_decision_annotation(values: list, labels: list[str]) -> str:
    """Show the application decision and top probability in a heatmap cell."""
    decision = choice_decision_with_uncertainty(values, labels)
    if decision is None:
        return ""
    probability = max(float(value) for value in values)
    probability_text = f"{probability:.2f}".removeprefix("0")
    return f"{decision} {probability_text}"


def _numeric_value(value: object) -> float | None:
    """A finite numeric value, or ``None`` if the model emitted something unusable."""
    try:
        numeric = float(value)
    except (TypeError, ValueError):
        return None
    return numeric if np.isfinite(numeric) else None


def parse_distribution(raw: object, labels: list[str]) -> list[float]:
    """Map a model's already-parsed per-question reply to per-label probabilities, in label order
    (distribution-mode answers left un-normalized).

    A single-pick reply is a single label string -> all the mass on that exact label; a
    distribution-mode reply is a dict read label by label. Anything that doesn't match a known label
    or isn't a finite number is left NaN -- we report the gap rather than massaging the reply (e.g.
    stripping an echoed description) to make it fit."""
    if isinstance(raw, str):  # single-pick mode: a single chosen label
        if raw in labels:
            return [1.0 if label == raw else 0.0 for label in labels]
        return [float("nan")] * len(labels)
    if not isinstance(raw, dict):
        return [float("nan")] * len(labels)
    return [
        value if (value := _numeric_value(raw.get(label))) is not None else float("nan")
        for label in labels
    ]


def rubric_prompt(mode: str, sample_index: int, rubric_hash: str) -> str:
    """The post + all questions (with their label sets) in one prompt; ``mode`` picks the format.

    ``mode="dist"`` asks for a probability distribution over each question's labels; the single-pick
    mode (``mode="single"``) asks for a single label per question. The uid line combines
    ``rubric_hash`` (which rubric version) with ``sample_index`` and a random token, so every repeat
    is a distinct, independent draw and two different rubrics never share a nonce."""
    lines = []
    for key, (instructions, choices) in QUESTIONS.items():
        labels = "\n".join(f"     {label}: {desc}" for label, desc in choices.items())
        lines.append(f"- {key}: {instructions}\n   labels:\n{labels}")
    exclusivity = (
        "\n\nEach question's labels are mutually exclusive: exactly one applies. If a post could "
        "arguably fit more than one, pick the single most severe / most specific label per the "
        "label descriptions."
    )
    if mode == "single":
        answer_format = (
            "\n\nFor each question, pick exactly ONE label.\nRespond with ONLY a JSON object "
            "mapping each question's key to one of that question's bare labels (the label only, "
            "not its description), with one entry per question."
        )
    else:
        answer_format = (
            "\n\nFor each question, give a probability distribution over that question's labels "
            "(values 0.00-1.00 that sum to 1).\nRespond with ONLY a JSON object mapping each "
            "question's key to an object mapping that question's bare labels (the label only, "
            "not its description) to probabilities, with one entry per question."
        )
    return (
        f"uid: {rubric_hash}:{sample_index}:{token_hex(4)}\n\n"
        f"Document (a reported user post):\n{json.dumps(POST, indent=2)}\n\nQuestions:\n"
        + "\n".join(lines)
        + exclusivity
        + answer_format
    )


def _cost(prices: tuple[float, float], input_tokens: int, output_tokens: int) -> float:
    return input_tokens / 1e6 * prices[0] + output_tokens / 1e6 * prices[1]


def _call_llm(model: str, prompt: str, temperature: float | None):
    """One LLM call -> (text, cost_usd, latency_s), routed by model name."""
    reasoning = model in REASONING_MODELS
    started = perf_counter()
    if model.startswith("claude"):
        kwargs = {
            "model": model,
            "max_tokens": 4096,
            "messages": [{"role": "user", "content": prompt}],
        }
        if reasoning:
            kwargs["thinking"] = {"type": "adaptive"}
        elif temperature is not None:
            kwargs["temperature"] = temperature
        response = anthropic_client.messages.create(**kwargs)
        text = next((b.text for b in response.content if b.type == "text"), "")
        usage = (response.usage.input_tokens, response.usage.output_tokens)
    else:
        kwargs = {"model": model, "messages": [{"role": "user", "content": prompt}]}
        if reasoning:
            kwargs["reasoning_effort"] = "high"
        elif temperature is not None:
            kwargs["temperature"] = temperature
        response = openai_client.chat.completions.create(**kwargs)
        text = response.choices[0].message.content
        usage = (response.usage.prompt_tokens, response.usage.completion_tokens)
    return text, _cost(LLM_PRICES[model], *usage), perf_counter() - started


# All samples (LLM and TypeSafe) are cached to ``json_cache.json``, which ships with the cookbook, so
# re-rendering is instant and reproduces the published numbers with no API spend. ``sample_index``
# seeds the uid buster and is part of the cache key, so each of the NUM_SAMPLES repeats is its own
# entry and its own independent draw, not one draw replayed. Delete ``json_cache.json`` to re-sample
# everything live.
json_cache = JsonCache(Path("json_cache.json"))


def _rubric_fingerprint() -> str:
    """Short digest of everything that shapes the prompt/rubric: the state and every question's
    text and label set. Passed into the cached calls below so that editing the post or any question
    changes the cache key and forces a fresh sample, instead of silently serving a stale answer that
    was generated for the old wording."""
    payload = json.dumps([POST, QUESTIONS], sort_keys=True, default=str)
    return hashlib.sha256(payload.encode()).hexdigest()[:12]


RUBRIC_HASH = _rubric_fingerprint()


@json_cache
def _call_typesafe(sample_index: int, rubric_hash: str, model: str):
    """Return distributions, token usage, latency, and model metadata for one call.

    ``rubric_hash`` and ``model`` prevent reuse across rubric or model changes.
    Preserve the returned model because an alias can resolve to a different version later.
    """
    questions = {
        key: Choice(instructions=instructions, criteria=choices)
        for key, (instructions, choices) in QUESTIONS.items()
    }
    started = perf_counter()
    response = typesafe_client.system_one(
        model=model,
        state={"uid": f"{rubric_hash}:{sample_index}:{token_hex(4)}", "post": POST},
        questions=questions,
    )
    distributions = {}
    for key, (_instructions, choices) in QUESTIONS.items():
        probabilities = dict(response.answers[key].probabilities)
        distributions[key] = [
            probabilities.get(label, float("nan")) for label in choices
        ]
    return (
        distributions,
        response.usage.input_tokens,
        response.usage.output_tokens,
        perf_counter() - started,
        {"requested_model": model, "response_model": response.model},
    )


@json_cache
def ask_llm_rubric(
    model: str,
    mode: str,
    temperature: float | None,
    sample_index: int,
    rubric_hash: str,
):
    """One LLM rubric query -> (per-question label distributions keyed by question key, cost_usd,
    latency_s); NaNs if the reply doesn't parse.

    ``mode="dist"`` parses 8 label distributions; the single-pick mode (``mode="single"``) parses 8
    single labels and puts all the mass on each. ``rubric_hash`` goes into the prompt's uid nonce
    (and so the cache key), so an edited state/rubric busts the cache instead of serving a stale
    answer."""
    prompt = rubric_prompt(mode, sample_index, rubric_hash)
    text, cost, latency = _call_llm(model, prompt, temperature)
    # Peel a single ```json ... ``` fence (claude-haiku-4-5 sometimes adds one despite "ONLY a JSON
    # object").
    stripped = text.strip()
    if stripped.startswith("```"):
        stripped = stripped[stripped.find("\n") + 1 :] if "\n" in stripped else ""
        if stripped.rstrip().endswith("```"):
            stripped = stripped.rstrip()[: -len("```")]
    try:
        raw = json.loads(stripped)
    except (ValueError, json.JSONDecodeError):
        raw = {}
    if not isinstance(raw, dict):
        raw = {}
    distributions = {
        key: parse_distribution(raw.get(key), list(choices))
        for key, (_instructions, choices) in QUESTIONS.items()
    }
    return distributions, cost, latency
Experimentelle Bedingungen
Experiment Grid
| Modellgruppe | Modell | Verteilung (t=0) | Verteilung (Standard) | Einzelwahl (t=0) |
|---|---|---|---|---|
| Nicht-Reasoning-Modelle | claude-haiku-4-5 |
✓ | ✓ | ✓ |
| Nicht-Reasoning-Modelle | gpt-5.4-mini |
✓ | ✓ | ✓ |
| Reasoning-Modelle | gpt-5.5 |
— | ✓ | — |
| Reasoning-Modelle | claude-opus-4-8 |
— | ✓ | — |
| TypeSafe | jev-latest (typesafe_choice) |
— | ✓ | — |
- Ein
✓markiert eine Bedingung, die mit 15 Wiederholungen getestet wurde; ein—markiert eine Kombination, die nicht getestet wird. - Die Standardspalte sendet kein Temperaturargument: Nicht-Reasoning-Modelle verwenden das API-Standardverhalten, und Reasoning-Modelle sowie TypeSafe laufen ohne Temperatureinstellung.
- Single-Pick-Bedingungen liefern ein Label pro Frage.
- Temperatur
0wird häufig für Reproduzierbarkeit empfohlen, daher wird sie mit dem API-Standard verglichen.
Wir ziehen NUM_SAMPLES = 15 Wiederholungen pro Bedingung. Jede Wiederholung hat ihren eigenen Cache-Schlüssel und zählt als eigenständiger Draw, und der Cache (json_cache.json) wird mit dem Kochbuch ausgeliefert, sodass das erneute Rendern ihn wiederverwendet und keine API-Aufrufe verbraucht. Löschen Sie den Cache, um wieder live zu sampeln.
CONDITIONS = []
for (
    model
) in BASE_MODELS:  # non-reasoning models: dist at t=0 / default, then a single-pick variant
    for temp_value, temp_label in ((0, "0"), (None, "default")):
        CONDITIONS.append(
            {
                "label": f"{model} t={temp_label}",
                "model": model,
                "temp": temp_value,
                "mode": "dist",
            }
        )
    CONDITIONS.append(
        {
            "label": f"{model} single-pick t=0",
            "model": model,
            "temp": 0,
            "mode": "single",
        }
    )
CONDITIONS += [  # reasoning models: one distribution condition each
    {
        "label": f"{model}-reasoning",
        "model": model,
        "temp": None,
        "mode": "dist",
    }
    for model in REASONING_MODELS
]
LABELS = [condition["label"] for condition in CONDITIONS]
TYPESAFE_LABEL = "typesafe_choice"
ALL_LABELS = [*LABELS, TYPESAFE_LABEL]

runs: dict[
    str, list
] = {}  # label -> NUM_SAMPLES samples of {question key: distribution}
stats: dict[str, list] = {}  # label -> NUM_SAMPLES (cost_usd, latency_s) pairs
with ThreadPoolExecutor(max_workers=16) as pool:
    futures = {
        condition["label"]: [
            pool.submit(
                ask_llm_rubric,
                condition["model"],
                condition["mode"],
                condition["temp"],
                sample_index,
                RUBRIC_HASH,
            )
            for sample_index in range(NUM_SAMPLES)
        ]
        for condition in CONDITIONS
    }
    for label, sample_futures in futures.items():
        results = [future.result() for future in sample_futures]
        runs[label] = [result[0] for result in results]
        stats[label] = [(result[1], result[2]) for result in results]

# TypeSafe samples are drawn sequentially, after the LLM pool has closed, so each call's latency is a
# clean round trip rather than one measured under the 16-way LLM thread contention.
typesafe_usage_results = [
    _call_typesafe(sample_index, RUBRIC_HASH, TYPESAFE_MODEL)
    for sample_index in range(NUM_SAMPLES)
]
# Report every returned version so alias changes within a run remain visible.
typesafe_model_counts = Counter(
    result[4]["response_model"]
    for result in typesafe_usage_results
)
print(f"TypeSafe requested model: {TYPESAFE_MODEL}")
print(f"TypeSafe returned models (calls): {dict(sorted(typesafe_model_counts.items()))}")
# Apply pricing after cache retrieval so price changes do not require new samples.
typesafe_results = [
    (distributions, _cost(TYPESAFE_PRICE, input_tokens, output_tokens), latency)
    for distributions, input_tokens, output_tokens, latency, _metadata in typesafe_usage_results
]
typesafe_runs = [result[0] for result in typesafe_results]
stats[TYPESAFE_LABEL] = [(result[1], result[2]) for result in typesafe_results]
TypeSafe requested model: jev-latest
TypeSafe returned models (calls): {'jev-1.13.0': 15}Kosten + Geschwindigkeit (pro Rubrik-Abfrage)
Die untenstehenden Kosten basieren auf den historischen Preisannahmen in der Setup-Konfiguration, einschließlich der speed_latest-Rate für TypeSafe. Sie sind keine verifizierten jev-latest-Preise oder aktuellen Abrechnungsbeträge.
Eine Zeile entspricht einer vollständigen Rubrikabfrage mit 8 Fragen. time/call und cost/call mitteln die 15 Abfragen, und die vs ts_choice-Spalten teilen durch die TypeSafe-Werte. Die LLMs laufen in einem Pool mit 16 parallelen Instanzen.
typesafe_cost = mean([cost for cost, _latency in stats["typesafe_choice"]])
typesafe_latency = mean([latency for _cost, latency in stats["typesafe_choice"]])
name_w = max(len(name) for name in ALL_LABELS) + 2  # fit the longest condition label
# Stack comparison headers so the relative speed and cost columns can stay narrow.
print(
    f"{'':<{name_w + 31}}{'speed vs':>11}{'cost vs':>11}\n"
    f"{'condition':<{name_w}}{'calls':>7}{'time/call':>11}{'cost/call':>13}"
    f"{'ts_choice':>11}{'ts_choice':>11}"
)
for name in ALL_LABELS:
    costs, latencies = zip(*stats[name])
    cost = mean(costs)
    latency = mean(latencies)
    print(
        f"{name:<{name_w}}{len(costs):>7}{latency * 1000:>9.0f}ms"
        f"{'$' + format(cost, '.6f'):>13}"
        f"{format(latency / typesafe_latency, '.1f') + 'x':>11}"
        f"{format(cost / typesafe_cost, '.1f') + 'x':>11}"
    )
speed vs cost vs
condition calls time/call cost/call ts_choice ts_choice
claude-haiku-4-5 t=0 15 3853ms $0.003498 33.8x 76.1x
claude-haiku-4-5 t=default 15 3860ms $0.003494 33.8x 76.0x
claude-haiku-4-5 single-pick t=0 15 992ms $0.001527 8.7x 33.2x
gpt-5.4-mini t=0 15 2293ms $0.002299 20.1x 50.0x
gpt-5.4-mini t=default 15 1986ms $0.002164 17.4x 47.1x
gpt-5.4-mini single-pick t=0 15 826ms $0.000936 7.2x 20.3x
gpt-5.5-reasoning 15 12978ms $0.041255 113.7x 897.4x
claude-opus-4-8-reasoning 15 10376ms $0.028375 90.9x 617.2x
typesafe_choice 15 114ms $0.000046 1.0x 1.0xIn dieser Ausführung typesafe_choice beträgt die durchschnittliche Hin- und Rücklauf-Latenz 114 ms. Die LLM-Bedingungen reichen von 826 ms bis 13,0 Sekunden pro Aufruf unter den oben genannten Konfigurationen für Parallelität.
Plot: jede Entscheidung einer Stichprobe als Heatmap
So liest du es:
- Äußere Zeilengruppe: die Frage.
- Innere Zeile: die Bedingung.
- Spalte: ein vollständiger Rubrik-Aufruf.
- Zellentext: die Anwendungsentscheidung sowie die Wahrscheinlichkeit im oberen Label.
- Zellfarbe: die Position des Labels innerhalb dieser Frage, sodass dieselbe Farbe über die gesamte Zeile hinweg bedeutet, dass die Entscheidung jedes Mal dieselbe ist.
- Grau
uncertain: die höchste Wahrscheinlichkeit liegt unter0.60, daher wird der Fall zur menschlichen Überprüfung weitergeleitet. - Gestreift
n/a: die Antwort ließ sich nicht in verwertbare Labels parsen (ein Parsing-Fehler). - Leere Zeilen sind lediglich Platzhalter.
Single-Pick-Bedingungen behalten ihre zurückgegebenen Labels: Sie liefern keine Unsicherheitsschätzung.
GAP = 1  # blank spacer row(s) between question blocks
HEAT_LABELS = ALL_LABELS
rows_per_block = len(HEAT_LABELS)  # rows per question block
pooled_runs = {
    **runs,
    TYPESAFE_LABEL: typesafe_runs,
}

row_index_values, row_text, row_labels, blocks = [], [], [], []
for question_index, (question_key, (question_text, choices)) in enumerate(
    QUESTIONS.items()
):
    labels = list(choices)
    if question_index:  # blank spacer rows (NaN -> rendered white) separate the blocks
        row_index_values.extend([np.nan] * NUM_SAMPLES for _ in range(GAP))
        row_text.extend([[""] * NUM_SAMPLES for _ in range(GAP)])
        row_labels.extend([""] * GAP)
    blocks.append((len(row_index_values), question_key, question_text))
    for label in HEAT_LABELS:
        values_by_sample = [
            pooled_runs[label][sample][question_key] for sample in range(NUM_SAMPLES)
        ]
        picks = [
            choice_decision_with_uncertainty(values, labels) for values in values_by_sample
        ]
        row_index_values.append(
            [
                10 if pick == "uncertain" else labels.index(pick) if pick in labels else np.nan
                for pick in picks
            ]
        )
        row_text.append(
            [choice_decision_annotation(values, labels) for values in values_by_sample]
        )
        row_labels.append(label)

heatmap_matrix = np.array(row_index_values, dtype=float)
# Reserve gray for abstentions while concrete-label colors remain local to each question.
cmap = ListedColormap([*plt.get_cmap("tab10").colors, "#dddddd"])
cmap.set_bad(
    "white"
)  # NaN cells (spacer rows AND unparseable replies) render white here...

fig, ax = plt.subplots(figsize=(15, 0.33 * len(row_index_values) + 1))
ax.imshow(heatmap_matrix, cmap=cmap, vmin=0, vmax=10, aspect="auto")
for row in range(heatmap_matrix.shape[0]):
    is_spacer_row = row_labels[row] == ""  # blank separator between question blocks
    for col in range(heatmap_matrix.shape[1]):
        label_text = row_text[row][col]
        if label_text:
            ax.text(
                col,
                row,
                label_text,
                ha="center",
                va="center",
                fontsize=5.7,
                family="monospace",
                color="black",
            )
        elif (
            not is_spacer_row
        ):  # ...but an unparseable reply gets a hatched "n/a", not blank white
            ax.add_patch(
                plt.Rectangle(
                    (col - 0.5, row - 0.5),
                    1,
                    1,
                    facecolor="#e8e8e8",
                    edgecolor="#b0b0b0",
                    hatch="////",
                    linewidth=0,
                )
            )
            ax.text(
                col,
                row,
                "n/a",
                ha="center",
                va="center",
                fontsize=5,
                family="monospace",
                color="#b30000",
            )

ax.set_xticks(range(NUM_SAMPLES))
ax.set_xticklabels(range(1, NUM_SAMPLES + 1), fontsize=7)
ax.set_xlabel("rubric query")
ax.set_yticks(range(len(row_labels)))
ax.set_yticklabels(row_labels, fontsize=7)
ax.tick_params(length=0)
for edge in ("top", "right", "left", "bottom"):
    ax.spines[edge].set_visible(False)

# outer level of the multi-index: the question key, printed once per block and centered, with the
# question text wrapped right under it
y_axis_transform = ax.get_yaxis_transform()
for start, question_key, question_text in blocks:
    center = start + (rows_per_block - 1) / 2
    ax.text(
        -0.2,
        center - 0.7,
        question_key,
        transform=y_axis_transform,
        ha="right",
        va="center",
        fontsize=8,
        fontweight="bold",
    )
    ax.text(
        -0.2,
        center + 0.1,
        textwrap.fill(question_text, 34),
        transform=y_axis_transform,
        ha="right",
        va="top",
        fontsize=6,
        style="italic",
        color="gray",
    )

ax.set_title(
    f"Every sample's decision + top probability; gray = uncertain (< {MIN_CHOICE_PROBABILITY:.2f})\n"
    f"(rows = question x condition, {NUM_SAMPLES} columns)",
    pad=12,
)
fig.tight_layout()
display(fig)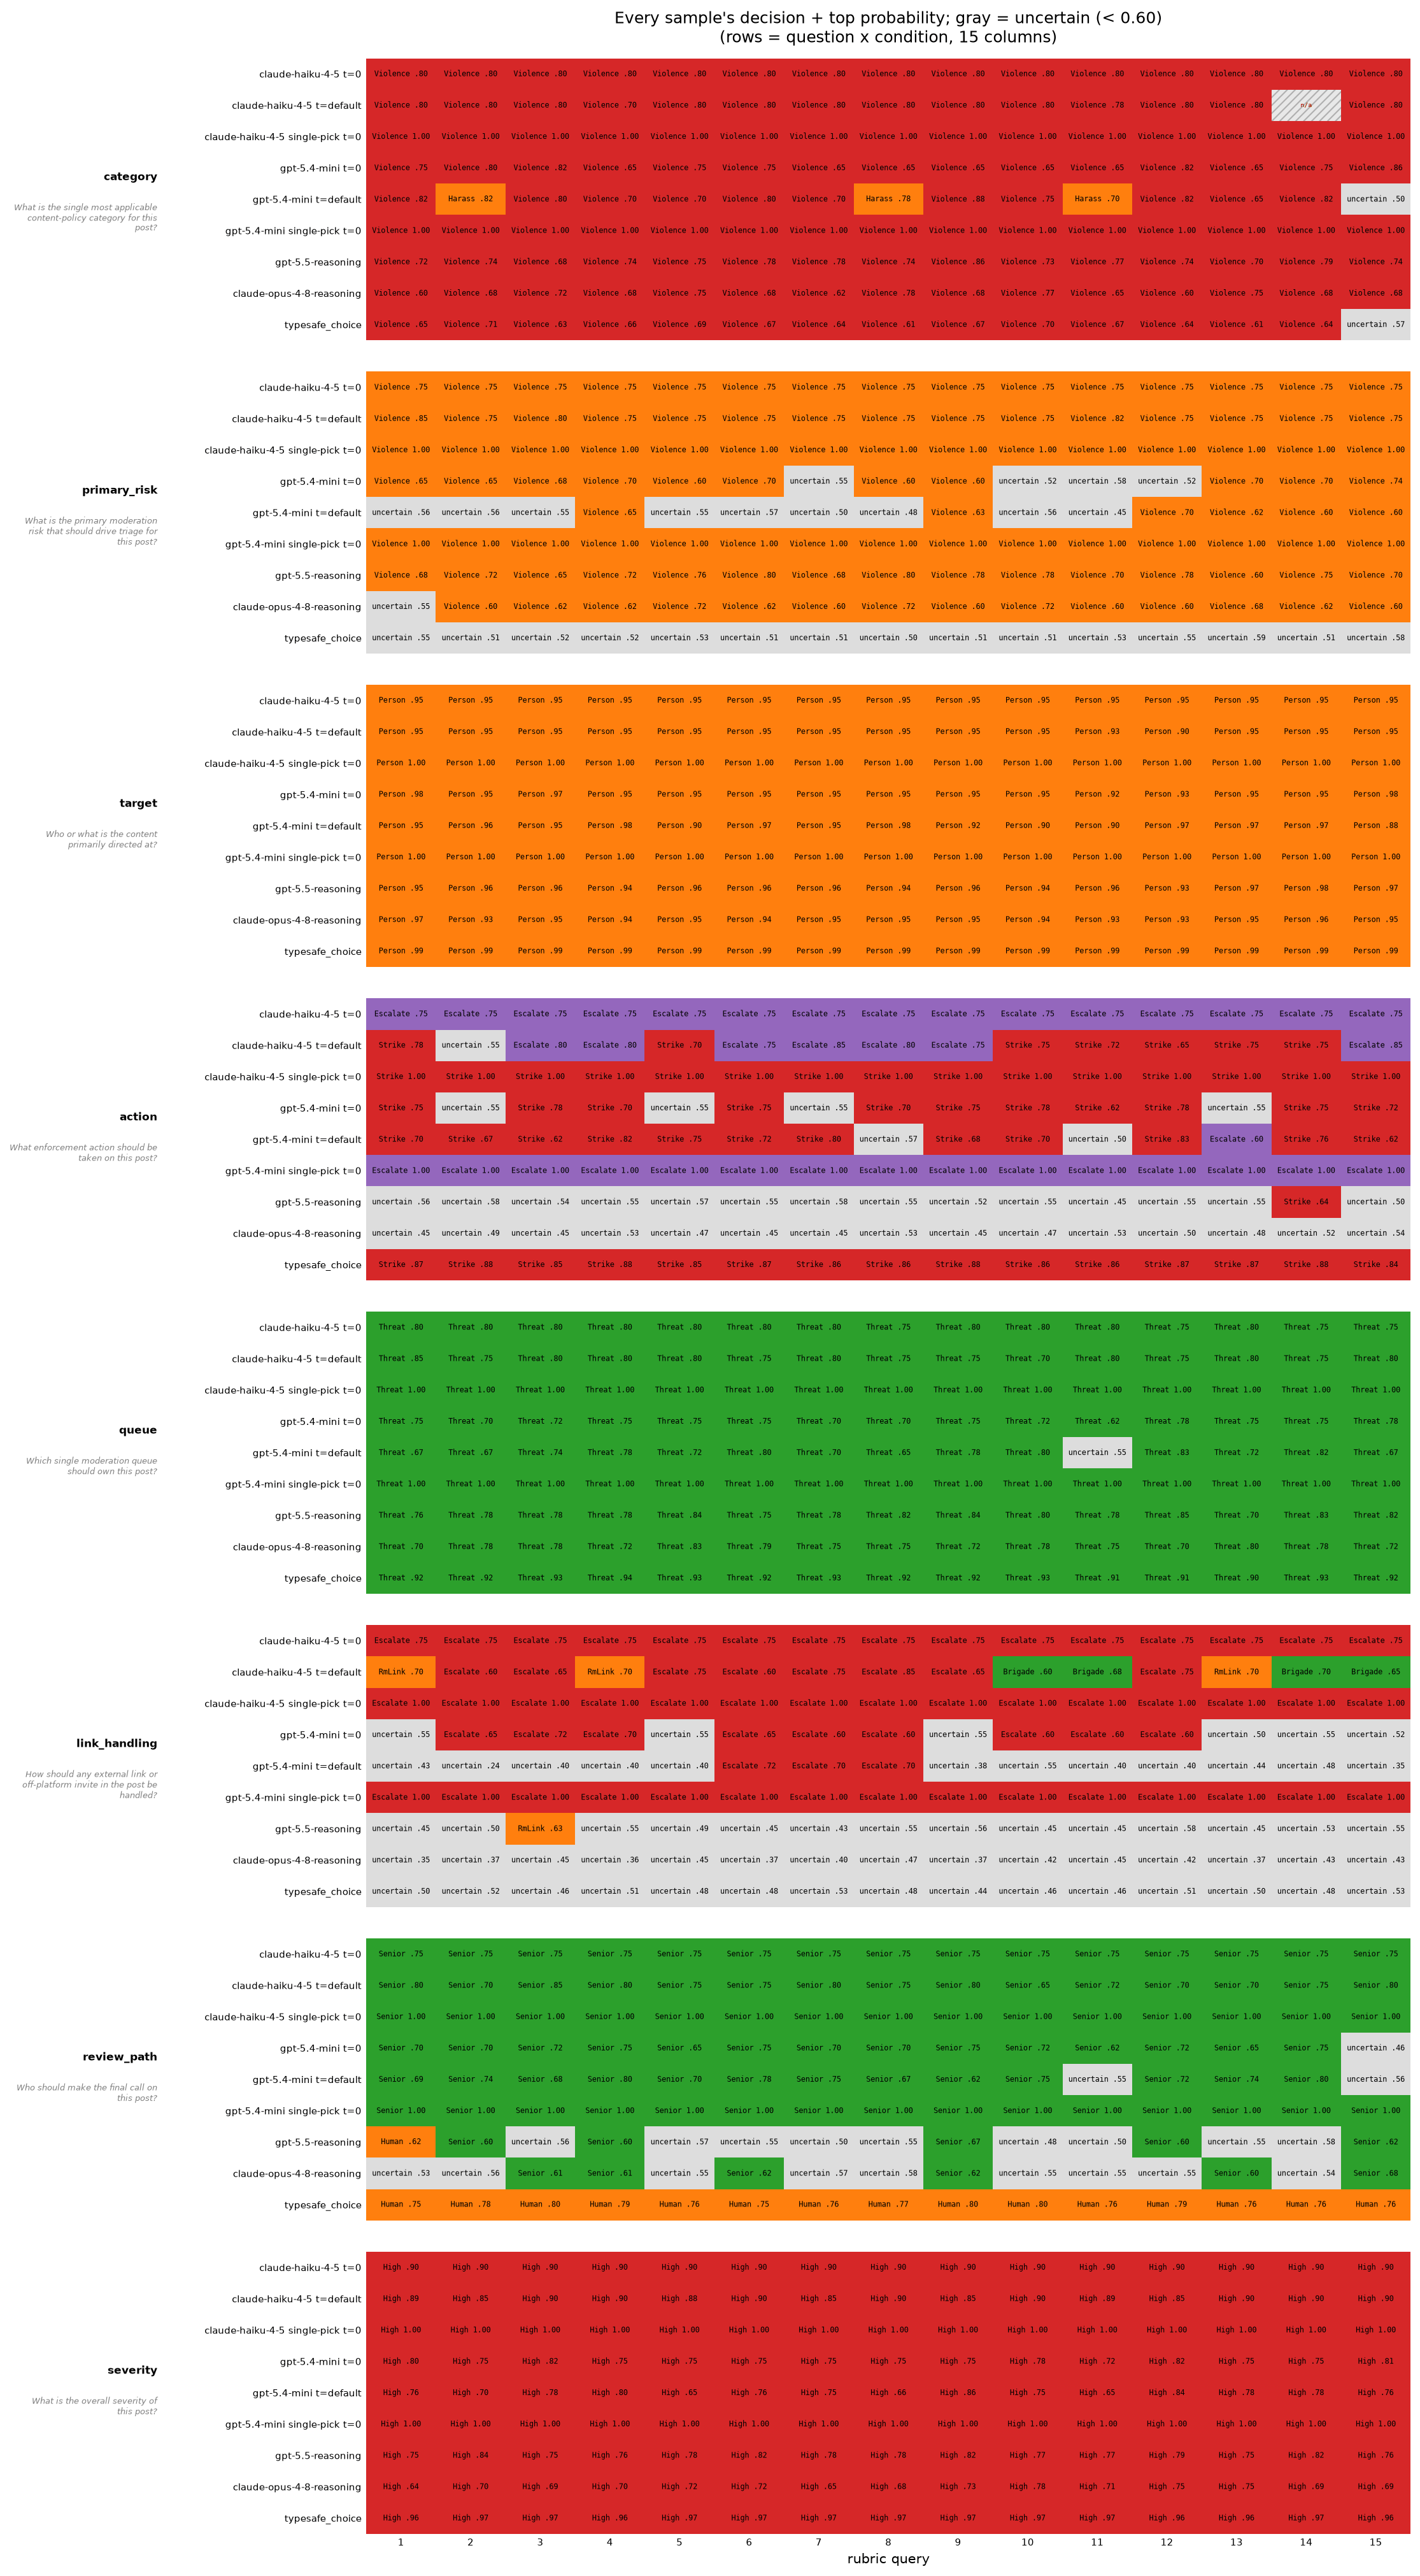
Die klareren Fragen bleiben stabil: target liest Person und severity liest High durchgängig. Die Grenzfälle verteilen sich auf die Bedingungen: category, primary_risk, action, review_path und link_handling. Einige Bedingungen wechseln auch innerhalb ihrer eigenen 15 Wiederholungen. Vor der Enthaltung ändert TypeSafe sein Top-Label bei primary_risk (Belästigung 11 Mal, Gewalt 4 Mal) und link_handling (RmLink 8 Mal, Brigade 7 Mal). Beide Zeilen zeigen nun durchgängig uncertain, da ihre höchsten Wahrscheinlichkeiten unter 0.60 liegen.
Wahrscheinlichungs-Standardabweichung
Dies betrachtet die vollständigen Wahrscheinlichkeitsvektoren, nicht nur das ausgewählte Label. Für jede Bedingung sammeln wir alle 15 Verteilungen für jede Frage, berechnen die Standardabweichung der Wahrscheinlichkeit jedes Labels über die Wiederholungen hinweg (wie stark sie von Lauf zu Lauf schwankt) und mitteln dann diese Standardabweichungen über alle Labels und Fragen. Wir berichten auch über die größte einzelne Standardabweichung eines Labels und zählen Parsing-Fehler separat.
Der Vergleichstabelle werden alle LLM-Bedingungen, die Wahrscheinlichkeitsausgaben erzeugen, gegen TypeSafe gegenübergestellt. Die Zeilen mit der einzelnen Auswahl sind ausgelassen, da sie harte Labels statt Wahrscheinlichkeitsverteilungen ausgeben.
def probability_std_stats(samples: list) -> tuple[float, float, float]:
    """Mean label std dev, max label std dev, parse-failure rate."""
    label_stds = []
    parse_failures = []
    for question_key in QUESTIONS:
        arr = np.array(
            [sample[question_key] for sample in samples],
            dtype=float,
        )
        parse_failures.extend(np.isnan(arr).any(axis=1).tolist())
        label_stds.extend(np.nanstd(arr, axis=0).tolist())
    return (
        float(np.nanmean(label_stds)),
        float(np.nanmax(label_stds)),
        float(np.mean(parse_failures)),
    )


PROBABILITY_OUTPUT_LABELS = [
    condition["label"] for condition in CONDITIONS if condition["mode"] == "dist"
] + [TYPESAFE_LABEL]
probability_std_by_label = {
    label: probability_std_stats(pooled_runs[label])
    for label in PROBABILITY_OUTPUT_LABELS
}
typesafe_mean_std = probability_std_by_label[TYPESAFE_LABEL][0]

print(
    f"{'condition':<{name_w}}{'mean prob std':>15}{'max prob std':>14}"
    f"{'parse fail':>12}{'x TypeSafe':>12}"
)
for label in PROBABILITY_OUTPUT_LABELS:
    mean_std, max_std, parse_failure_rate = probability_std_by_label[label]
    relative_std = mean_std / typesafe_mean_std
    print(
        f"{label:<{name_w}}{mean_std:>15.4f}{max_std:>14.4f}"
        f"{parse_failure_rate:>11.0%}{relative_std:>12.2f}x"
    )
condition mean prob std max prob std parse fail x TypeSafe
claude-haiku-4-5 t=0 0.0012 0.0221 0% 0.12x
claude-haiku-4-5 t=default 0.0516 0.3150 1% 5.29x
gpt-5.4-mini t=0 0.0312 0.0905 0% 3.20x
gpt-5.4-mini t=default 0.0543 0.2303 0% 5.56x
gpt-5.5-reasoning 0.0305 0.1047 0% 3.12x
claude-opus-4-8-reasoning 0.0245 0.0693 0% 2.52x
typesafe_choice 0.0098 0.0515 0% 1.00xIn diesem Durchlauf weist TypeSafe eine mittlere Standardabweichung der Wahrscheinlichkeit von 0.0098 und eine maximale Standardabweichung für einzelne Labels von 0.0515 auf. Haiku bei der Temperatur 0 hat eine niedrigere mittlere Standardabweichung von 0.0012. Die anderen fünf LLM-Wahrscheinlichkeitsbedingungen reichen von 0.0245 bis 0.0543, was etwa 2.5x bis 5.6x des TypeSafe-Mittels entspricht. Kleine Änderungen können immer noch das Top-Label wechseln, wenn zwei Labels nah beieinander liegen.
Plot: Entscheidungsvereinbarung mit ungewissem Ausgang
Gib uncertain zurück, wenn die höchste Wahrscheinlichkeit unter 0.60 liegt. Zähle für jede bedingungsbasierte Wahrscheinlichkeitsausgabe und jede Frage die häufigste Anwendungsentscheidung, einschließlich uncertain, und teile sie durch alle 15 Ziehungen. Parsing-Fehler werden gegen die Übereinstimmung gewertet. Jeder Balken mittelt die Punktzahl über alle 8 Fragen, wobei die höchste Übereinstimmung zuerst kommt.
Single-Pick-LLM-Bedingungen sind ausgeschlossen, da sie keine Unsicherheitsschätzung liefern.
# Compute policy decisions and agreement once for both this chart and the comparison table.
decisions_by_condition = {}
policy_agreement_by_condition = {}
for label in PROBABILITY_OUTPUT_LABELS:
    decisions = [
        [
            choice_decision_with_uncertainty(sample[key], list(choices))
            for sample in pooled_runs[label]
        ]
        for key, (_instructions, choices) in QUESTIONS.items()
    ]
    decisions_by_condition[label] = decisions
    shares = [
        max(Counter(value for value in row if value is not None).values(), default=0)
        / NUM_SAMPLES
        for row in decisions
    ]
    policy_agreement_by_condition[label] = mean(shares)

# Sort by the measured agreement, keeping TypeSafe's color independent of its rank.
bar_labels = sorted(
    PROBABILITY_OUTPUT_LABELS, key=policy_agreement_by_condition.__getitem__, reverse=True
)
rates = [policy_agreement_by_condition[label] for label in bar_labels]

fig_bar, bar_ax = plt.subplots(figsize=(7, 0.45 * len(bar_labels) + 1))
positions = range(len(bar_labels))
bar_ax.barh(
    list(positions),
    rates,
    color=["#2b8cbe" if label == TYPESAFE_LABEL else "#fe9929" for label in bar_labels],
    alpha=0.85,
)
for label, position, rate in zip(bar_labels, positions, rates):
    marker = "*" if label == "claude-haiku-4-5 t=0" else ""
    bar_ax.text(
        rate + 0.01, position, f"{rate:.1%}{marker}", va="center", fontsize=8, color="gray"
    )
bar_ax.set_yticks(list(positions))
bar_ax.set_yticklabels(bar_labels, fontsize=8)
bar_ax.invert_yaxis()  # first condition on top
bar_ax.set_xlim(0, 1.08)
bar_ax.set_xticks(np.linspace(0, 1, 6))
bar_ax.set_xlabel("decision agreement across 15 re-runs (mean over 8 questions)")
for edge in ("top", "right", "left"):
    bar_ax.spines[edge].set_visible(False)
bar_ax.tick_params(length=0)
fig_bar.suptitle("Decision agreement including uncertain outcomes", y=1.0)
# Keep the caveat inside the exported chart so it travels with the 100% annotation.
fig_bar.text(
    0.01,
    0.01,
    "* Haiku t=0: 100% repeatability does not imply correctness.\n"
    "  This experiment does not measure accuracy.",
    fontsize=8,
)
fig_bar.tight_layout(rect=(0, 0.11, 1, 1))
display(fig_bar)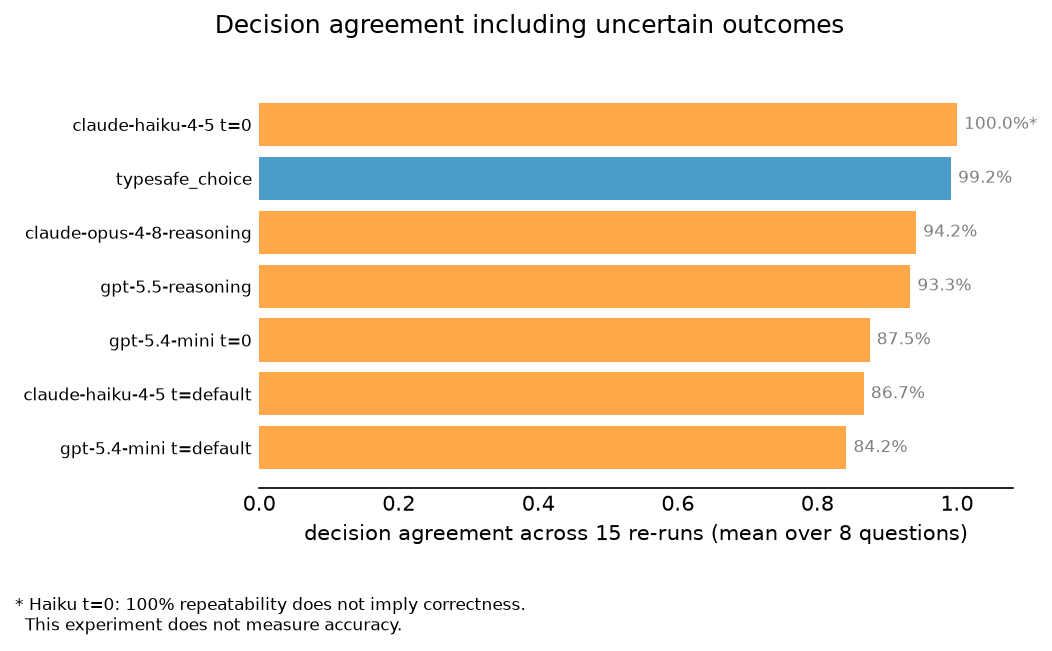
Unter derselben 0.60-Regel erzielte Haiku bei Temperatur 0 eine Trefferquote von 100 %. TypeSafe erreichte 99,2 %, und die anderen LLM-Bedingungen lagen zwischen 84,2 % und 94,2 %. TypeSafe gab bei 25,8 % der Antworten uncertain zurück und handelte automatisch in den anderen 74,2 % der Fälle; Haiku bei Temperatur 0 verzichtete niemals auf eine Antwort. Diese Prozentsätze messen ausschließlich die Wiederholbarkeit. Die folgende Tabelle stellt die rohe Übereinstimmung und die Verzichtsraten neben der Policy-Übereinstimmung in diesem Diagramm dar.
Lassen Sie unsichere Wahrscheinlichkeiten zu einer unsicheren Entscheidung führen
Eine kleine Änderung der Wahrscheinlichkeit kann zwei nahe beieinander liegende Labels austauschen. Die Anwendung muss nicht auf den Gewinner reagieren: Gib uncertain zurück, wenn die höchste Wahrscheinlichkeit unter 0.60 liegt, und leite diesen Fall an einen Menschen weiter. Wähle bei genau 0.60 das Label mit der höchsten Wahrscheinlichkeit. Dabei werden die zurückgegebenen Wahrscheinlichkeiten verwendet, nicht das separate Feld confidence der API, und es werden keine zusätzlichen Modellaufrufe benötigt.
Die Schwelle ist eine illustrische Anwendungsrichtlinie, keine kalibrierte Garantie oder eine Schwelle, die gewählt wurde, um die Übereinstimmung dieses Durchlaufs zu maximieren. Wählen Sie Produktionsschwellen mit beschrifteten Beispielen und den Kosten für fehlerhafte Aktionen und menschliche Überprüfung.
Wir wenden dieselbe Regel auf jede bedingte Wahrscheinlichkeitsausgabe an. Einzelne LLM-Antworten haben keine Wahrscheinlichkeitsschätzung; ihre synthetischen One-Hot-Vektoren können Unsicherheit nicht messen, daher werden sie aus der Einigungsübersicht und -tabelle ausgeschlossen.
def agreement_rate(samples: list) -> float:
    """Mean over questions of the raw plurality label's share across all NUM_SAMPLES draws.

    Parse failures count against agreement because a failed route is not a repeated decision.
    """
    shares = []
    for question_key, (_instructions, choices) in QUESTIONS.items():
        labels = list(choices)
        picks = [
            argmax_label(samples[sample][question_key], labels)
            for sample in range(NUM_SAMPLES)
        ]
        picks = [pick for pick in picks if pick is not None]
        if not picks:
            shares.append(0.0)
            continue
        top = Counter(picks).most_common(1)[0][1]
        shares.append(top / NUM_SAMPLES)
    return mean(shares) if shares else float("nan")


# Keep failures separate from abstentions and count conflicting concrete actions per question.
print(
    f"{'condition':<{name_w}}{'raw agree':>12}{'policy agree':>14}"
    f"{'uncertain':>12}{'automatic':>12}{'conflicts':>11}"
)
for label in PROBABILITY_OUTPUT_LABELS:
    decisions = decisions_by_condition[label]
    flat = [value for row in decisions for value in row]
    uncertain_rate = mean(value == "uncertain" for value in flat)
    automatic_rate = mean(value not in (None, "uncertain") for value in flat)
    conflicts = sum(
        len({value for value in row if value not in (None, "uncertain")}) > 1
        for row in decisions
    )
    print(
        f"{label:<{name_w}}{agreement_rate(pooled_runs[label]):>11.1%}"
        f"{policy_agreement_by_condition[label]:>13.1%}{uncertain_rate:>11.1%}"
        f"{automatic_rate:>11.1%}{conflicts:>11}"
    )
condition raw agree policy agree uncertain automatic conflicts
claude-haiku-4-5 t=0 100.0% 100.0% 0.0% 100.0% 0
claude-haiku-4-5 t=default 87.5% 86.7% 0.8% 98.3% 2
gpt-5.4-mini t=0 99.2% 87.5% 12.5% 87.5% 0
gpt-5.4-mini t=default 90.8% 84.2% 22.5% 77.5% 2
gpt-5.5-reasoning 90.0% 93.3% 30.8% 69.2% 1
claude-opus-4-8-reasoning 92.5% 94.2% 33.3% 66.7% 0
typesafe_choice 90.8% 99.2% 25.8% 74.2% 0policy agree wertet uncertain als Entscheidung; Parsing-Fehler zählen gegen die Vereinbarung.
automatic ist der Anteil aller Antworten, die ein Label auswählen. conflicts zählt Fragen
mit mehr als einem konkreten Label über die Wiederholungen hinweg, unter Ignorierung
von Enthaltungen. Diese Maßnahmen beschreiben Wiederholbarkeit und wie oft die Anwendung
handelt, nicht ob ihre Handlungen richtig sind.
Die Übereinstimmung von TypeSafe stieg von 90,8 % auf 99,2 %. Von den Antworten waren 25,8 % unsicher und
74,2 % automatisch. primary_risk und link_handling blieben bei jeder Wiederholung unsicher;
category wechselte zwischen Gewalt und uncertain, überschritt bei einigen Wiederholungen die Aktionsschwelle, bei anderen nicht. Keine Frage führte zu zwei verschiedenen konkreten TypeSafe-Labels.
Dies alles zeigt keine Genauigkeit oder Überlegenheit: Haiku bei Temperatur 0 hatte hier eine Übereinstimmung von 100 %, ohne Enthaltungen.
# Show every TypeSafe decision while retaining the top probability behind it.
policy_decisions = decisions_by_condition[TYPESAFE_LABEL]
policy_values = []
for row, (_key, (_instructions, choices)) in zip(policy_decisions, QUESTIONS.items()):
    labels = list(choices)
    policy_values.append([
        10 if value == "uncertain" else labels.index(value) if value is not None else np.nan
        for value in row
    ])
policy_cmap = ListedColormap([*plt.get_cmap("tab10").colors, "#dddddd"])
policy_cmap.set_bad("white")
fig_policy, ax_policy = plt.subplots(figsize=(13, 4))
ax_policy.imshow(policy_values, cmap=policy_cmap, vmin=0, vmax=10, aspect="auto")
for row_index, key in enumerate(QUESTIONS):
    for sample_index in range(NUM_SAMPLES):
        decision = policy_decisions[row_index][sample_index]
        probability = max(typesafe_runs[sample_index][key])
        ax_policy.text(sample_index, row_index, f"{decision or 'n/a'}\n{probability:.2f}",
                       ha="center", va="center", fontsize=6)
ax_policy.set_yticks(range(len(QUESTIONS)), list(QUESTIONS))
ax_policy.set_xticks(range(NUM_SAMPLES), range(1, NUM_SAMPLES + 1))
ax_policy.set_xlabel("rubric query")
ax_policy.set_title(
    "TypeSafe application decisions: gray means uncertain "
    f"(top probability < {MIN_CHOICE_PROBABILITY:.2f})"
)
fig_policy.tight_layout()
display(fig_policy)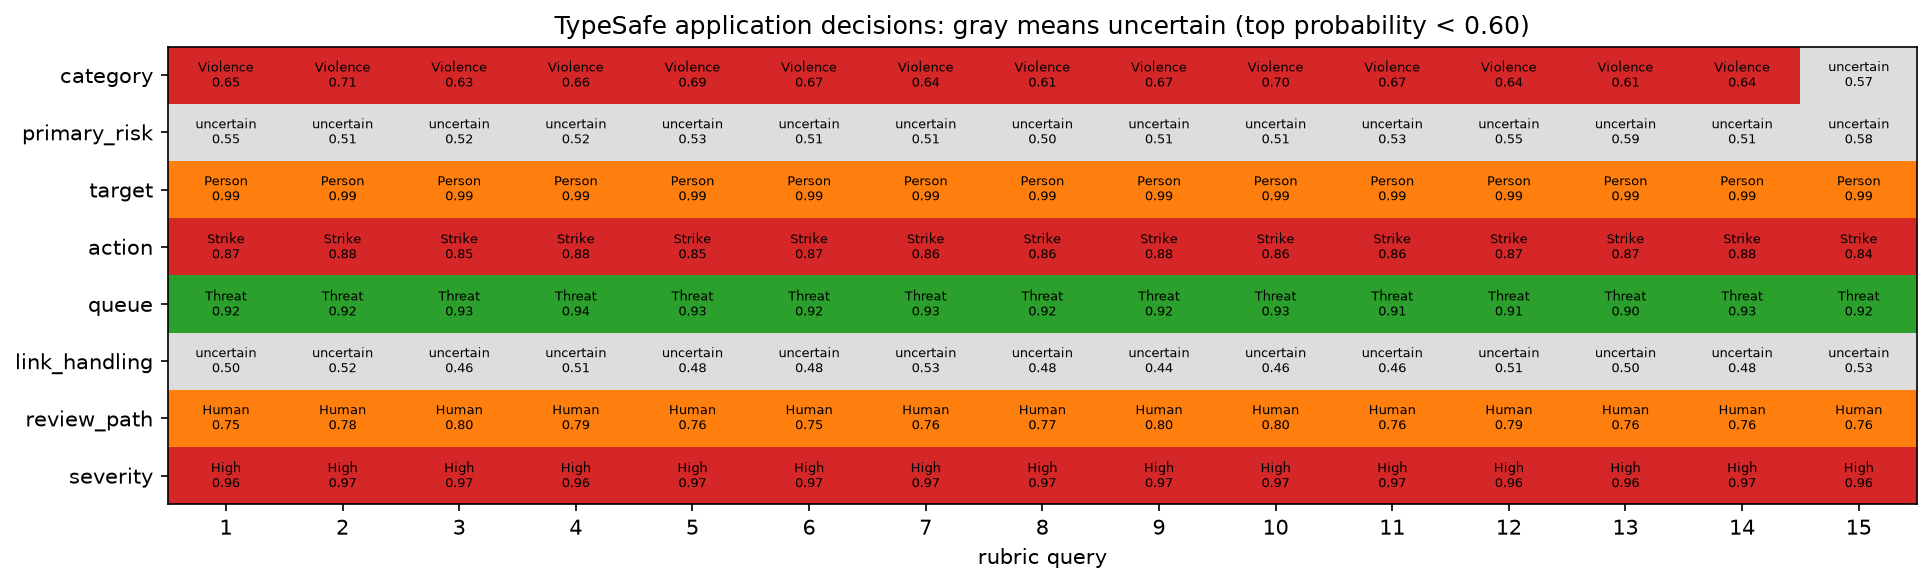
Diese Richtlinie macht das Modell nicht deterministisch. Das Zurückhalten kann konkurrierende
Labels durch dasselbe Ergebnis der menschlichen Überprüfung ersetzen, aber eine Wahrscheinlichkeit nahe 0.60 kann immer noch
zwischen einem konkreten Label und uncertain wechseln. Die Wahrscheinlichkeitsstatistiken und die Spalte raw agree der Tabelle melden weiterhin die ursprünglichen Modellausgaben.
Öffnen Sie es im TypeSafe-Playground
Der folgende Link öffnet denselben Beitrag und dieselbe Rubrik im Playground: ein Beitrag, dieselben 8
Choices und TypeSafe jev-latest.
playground_link = make_playground_link(
    {"post": POST},
    {
        key: Choice(instructions=instructions, criteria=choices)
        for key, (instructions, choices) in QUESTIONS.items()
    },
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this post + rubric in the TypeSafe playground]({playground_link})"
    )
)