 JevCode
Vorab analysierte Wertextraktion
Verwendet Regexes, um Kandidaten für E-Mail-Adressen, Telefonnummern und Beträge zu finden, und lässt anschließend TypeSafe den angeforderten Span auswählen, damit Code einen wörtlichen Wert normalisieren kann.
Maschinell aus en übersetzt, nicht lektoriert. Nur als Kurzreferenz geeignet.

Ein Regex findet die Kandidatenwerte, TypeSafe wählt denjenigen aus, nach dem die Frage fragt, und der Code kopiert ihn wortwörtlich.
Die find- und pick-Paarung hier ist eine, auf die Sie in Ihren eigenen Dokumenten verweisen können, und drei bearbeitete Fälle zeigen ihre Anwendung: die Adresse, an die ein Absender seine Quittung gesendet haben möchte, eine Telefonnummer als +14155550177 und eine Rechnungssumme als 1315.50 USD, die als Gebühr markiert ist.
TypeSafe wählt eine der Optionen aus, die du ihm übergibst, daher müssen die Kandidaten zuerst gefunden werden. Ein Regex findet sie, TypeSafe wählt eine aus, und der Code kopiert die Auswahl, in drei Schritten:
- Ein regulärer Ausdruck findet die Kandidatenwerte im Text. Stelle ihn so ein, dass er zu viel findet.
- TypeSafe wählt aus, welchen Kandidaten die Frage sucht, und liest alle Attribute aus, die der Code später benötigt (Währung, Land, ob es sich um einen Gutschrift- oder Lastschriftbetrag handelt).
- Der Code kopiert den ausgewählten Wert und normalisiert ihn.
Da TypeSafe nur zwischen den vom Regex gefundenen Bereichen wählt, ist der zurückgegebene Wert einer dieser Bereiche, unverändert kopiert. Er kann keinen Wert erfinden oder eine Ziffer transponieren.
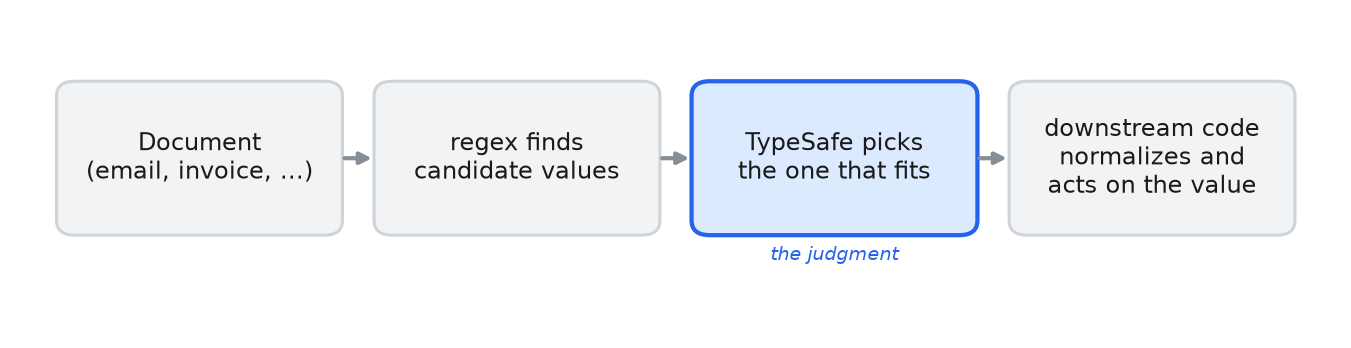
Der Regex findet Kandidatenwerte im Dokument, TypeSafe wählt einen aus, und nachgelagerter Code normalisiert ihn und handelt entsprechend.
Einrichtung
pip install ipython phonenumbers "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/dann TYPESAFE_API_KEY festlegen.
import os
import re
from decimal import Decimal
from pathlib import Path

import phonenumbers
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
NONE = "none"  # the escape hatch on every selection: "none of the candidates fits"

# base_url defaults to https://api.typesafe.ai/ ; the env override points at another deployment.
ts = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # cached re-renders need no key
    base_url=os.environ.get("TYPESAFE_BASE_URL"),
    timeout=30.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Helfer
find führt eine Regex aus, die auf Überfindung abgestimmt ist, und dedupliziert die Treffer. pick ist eine
Choice-Frage, deren Optionen die von find zurückgegebenen Spannen sind, sodass die Antwort eine dieser
Spannen ist, die exakt kopiert wurde, oder none, wenn kein Kandidat passt. classify ist eine
Choice-Frage über einen festen Satz von Labels, die hier für die Währung und das
Land verwendet wird.
is_true ist ein Noul, der hier verwendet wird, um zu fragen, ob es sich bei einem Betrag um einen Kredit handelt.
Jeder Aufruf wird in json_cache.json zwischengespeichert, sodass das erneute Rendern keine API-Aufrufe auslöst.
EMAIL_RE = re.compile(r"[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}")
PHONE_RE = re.compile(r"\(?\+?\d[\d\s()\-.]{6,}\d")
MONEY_RE = re.compile(r"[$€£¥]\s?\d[\d,]*(?:\.\d{2})?")


def find(pattern: re.Pattern, text: str) -> list[str]:
    """Code-side candidate finder: recall-tuned regex, deduped, in document order."""
    seen: set[str] = set()
    out: list[str] = []
    for match in pattern.findall(text):
        span = match.strip()
        if span and span not in seen:
            seen.add(span)
            out.append(span)
    return out


@json_cache
def pick(document: str, candidates: list[str], question: str) -> dict:
    """TypeSafe selects which found span plays the role. Returns {choice, confidence}.

    The options ARE the candidate spans, so ``choice`` is a verbatim copy of one of them (or the
    ``none`` hatch) - the model chooses, code owns the string."""
    criteria = {c: None for c in candidates} | {
        NONE: "None of these is the requested value."
    }
    answer = ts.system_one(
        state=document,
        questions={"pick": Choice(instructions=question, criteria=criteria)},
        model=TYPESAFE_MODEL,
    ).answers["pick"]
    return {"choice": answer.choice, "confidence": answer.confidence}


@json_cache
def classify(document: str, question: str, options: list[str]) -> dict:
    """A small Choice over a fixed label set (currency, country, ...). Returns {choice, confidence}."""
    answer = ts.system_one(
        state=document,
        questions={
            "q": Choice(instructions=question, criteria={o: None for o in options})
        },
        model=TYPESAFE_MODEL,
    ).answers["q"]
    return {"choice": answer.choice, "confidence": answer.confidence}


@json_cache
def is_true(document: str, question: str) -> float:
    """A yes/no Noul. Returns P(yes)."""
    return (
        ts.system_one(
            state=document,
            questions={"q": Noul(instructions=question)},
            model=TYPESAFE_MODEL,
        )
        .answers["q"]
        .noul
    )
E-Mail: die richtige Adresse nach Rolle auswählen
Vier Adressen in den Headern. Der Textkörper bittet darum, die Quittung an eine private Adresse statt an das To: Rechnungsalias zu senden, daher hängt die Antwort vom Lesen des Textkörpers ab. Zwei Fragen hier: Welche Adresse erhält die Quittung und welche hat die Nachricht gesendet.
EMAIL_DOC = """From: Dana Whit <[email protected]>
To: [email protected]
Cc: [email protected]
Reply-To: [email protected]

Hi team - please don't use the billing alias for this one. Send my receipt to my
personal address instead. Thanks, Dana."""

emails = find(EMAIL_RE, EMAIL_DOC)
receipt = pick(
    EMAIL_DOC, emails, "Which email address does the sender want their receipt sent to?"
)
sender = pick(
    EMAIL_DOC, emails, "Which email address did this message come from (the From line)?"
)

print("candidates :", emails)
# code copies the picked value verbatim and normalizes (lowercase); it never re-types it
print(
    f"receipt -> : {receipt['choice'].lower():<28} (conf {receipt['confidence']:.2f})"
)
print(f"sender  -> : {sender['choice'].lower():<28} (conf {sender['confidence']:.2f})")
candidates : ['[email protected]', '[email protected]', '[email protected]', '[email protected]']
receipt -> : [email protected] (conf 0.98)
sender -> : [email protected] (conf 1.00)receipt ist die persönliche Gmail-Adresse in der Reply-To:-Zeile, was der Textkörper verlangt; sender ist die in der From-Zeile. Beide sind Kopien von Regex-Übereinstimmungen, die im Code kleingeschrieben wurden.
Telefon: das Mobiltelefon auswählen, auf E.164 normalisieren
Drei Zahlen, keine davon mit einer Landesvorwahl. TypeSafe wählt die Mobilnummer aus
und liest das Land aus dem Text; phonenumbers kombiniert diese beiden Antworten zu E.164,
dem internationalen Format, das mit einem + und der Landesvorwahl beginnt.
PHONE_DOC = """Reach our San Francisco office at these numbers: main desk (415) 555-0199,
billing fax (415) 555-0142, and my direct cell (415) 555-0177. Call the cell if it's urgent."""

phones = find(PHONE_RE, PHONE_DOC)
mobile = pick(PHONE_DOC, phones, "Which of these is the direct mobile / cell number?")
region = classify(
    PHONE_DOC,
    "In what country is this office located?",
    ["US", "GB", "DE", "FR", "CA", "AU"],
)

# code copies the picked value and normalizes it with the model-supplied country
parsed = phonenumbers.parse(mobile["choice"], region["choice"])
e164 = phonenumbers.format_number(parsed, phonenumbers.PhoneNumberFormat.E164)

print("candidates :", phones)
print(f"mobile  -> : {mobile['choice']}  (conf {mobile['confidence']:.2f})")
print(f"country -> : {region['choice']}  (conf {region['confidence']:.2f})")
print(f"E.164   -> : {e164}")
candidates : ['(415) 555-0199', '(415) 555-0142', '(415) 555-0177']
mobile -> : (415) 555-0177 (conf 1.00)
country -> : US (conf 0.90)
E.164 -> : +14155550177Nichts in den Ziffern verrät, welche Nummer die Mobilnummer ist oder in welchem Land sie sich befindet; die Wörter darum herum tun es. TypeSafe liest diese Wörter, und phonenumbers formatiert die ausgewählte Nummer als +14155550177.
Geld: Betrag auswählen, Währung klassifizieren, Kredit vs. Lastschrift markieren
Eine Rechnung mit vier Beträgen. TypeSafe wählt die Gesamtforderung und den Gutschriftsbetrag aus, liest die Währung und markiert jeden erfassten Betrag als Belastung oder Gutschrift. Der Code kopiert jede erfasste Zeichenkette und parst sie zu einem Decimal.
MONEY_DOC = """Invoice INV-2087.
Subtotal: $1,200.00
Sales tax: $115.50
Total due: $1,315.50
A $50.00 courtesy credit from last month has already been applied."""

amounts = find(MONEY_RE, MONEY_DOC)
currency = classify(
    MONEY_DOC,
    "What currency are these amounts in?",
    ["USD", "EUR", "GBP", "JPY", "CAD"],
)
total = pick(MONEY_DOC, amounts, "Which amount is the total the customer must pay?")
credit = pick(
    MONEY_DOC, amounts, "Which amount is the courtesy credit that was applied?"
)


def to_decimal(value: str) -> Decimal:
    """Copy the picked value and parse the number in code (US grouping/decimal here)."""
    return Decimal(re.sub(r"[^\d.]", "", value))


for label, chosen in [("total due", total), ("credit", credit)]:
    is_credit = is_true(
        MONEY_DOC,
        f"Is the amount {chosen['choice']} a credit or refund to the customer, not a charge?",
    )
    kind = "credit" if is_credit > 0.5 else "charge"
    print(
        f"{label:<10}: {chosen['choice']:<10} -> {to_decimal(chosen['choice'])} {currency['choice']} "
        f"({kind}, P(credit)={is_credit:.2f})"
    )
print("\ncandidates :", amounts)
total due : $1,315.50 -> 1315.50 USD (charge, P(credit)=0.01)
credit : $50.00 -> 50.00 USD (credit, P(credit)=0.99)
candidates : ['$1,200.00', '$115.50', '$1,315.50', '$50.00']Der Gesamtbetrag beträgt 1.315,50 USD und der Gutschriftsbetrag 50,00 USD. Die Gutschrift-oder-Belastung
Noul antwortet mit 0,01 auf den Gesamtbetrag und mit 0,99 auf die Gutschrift, sodass der Code das Vorzeichen jedes Decimal kennt, das er parst.
to_decimalgeht davon aus, dass das Komma Tausender trennt und der Punkt das Dezimalzeichen ist. Das gilt für$1,315.50; bei€1.315,50ist es umgekehrt. Stelle eineNoul-Frage dazu, welche Konvention das Dokument verwendet, und verzweige dies im Code.
Öffnen Sie es im TypeSafe-Playground
Ein Freigabelink, der den E-Mail-Thread im Browser öffnet, mit der Quittierungsfrage darin und den vier Adressen, die der Regex in seinen Optionen gefunden hat.
receipt_criteria = {e: None for e in emails} | {
    NONE: "None of these is the requested value."
}
playground_link = make_playground_link(
    EMAIL_DOC,
    {
        "receipt": Choice(
            instructions="Which email address does the sender want their receipt sent to?",
            criteria=receipt_criteria,
        )
    },
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this thread + selection in the TypeSafe playground]({playground_link})"
    )
)
Diesen Thread + Auswahl im TypeSafe-Playground öffnen →
Zwei Grenzen
- Eine
ChoiceFrage erlaubt höchstens 255 Optionen. Bei mehr Kandidaten als das, verengen Sie in zwei Schritten: Wählen Sie zuerst den Abschnitt, dann den Bereich darin. - Das Finden der Kandidaten ist der Teil, der Arbeit erfordert. E-Mail-Adressen, Telefonnummern und Beträge werden von Regexen abgedeckt; ein Name nicht, daher müssen seine Kandidaten aus einem bereits vorhandenen Verzeichnis stammen oder von einem Named-Entity-Erkennungsmodell oder einem LLM vorgeschlagen werden. TypeSafe wählt dann denjenigen aus, den die Frage verlangt.