 JevCode
Zeilenweise Suche
Erstellen Sie semantische Suche für GitHub's Terms of Service. Werten Sie in einer Anfrage 218 line ids gegen eine plain-language query mit einer Choice question aus und verwenden Sie eine Noul question, um zu prüfen, ob das Dokument eine Antwort enthält.
Maschinell aus en übersetzt, nicht lektoriert. Nur als Kurzreferenz geeignet.

Du hast die Nutzungsbedingungen von GitHub und eine Frage in einfacher Sprache dazu. Du benötigst die Zeilen, die die Frage beantworten, sowie eine Möglichkeit zu erkennen, wenn das Dokument keine Antwort enthält. Die enthaltenen Abfragen sortieren Zeilen mit direkten Antworten an erster Stelle. Die exists-Schwellenwerte klassifizieren die verbleibenden Fälle als fehlend oder unvollständig. Du erhältst find(), das die exists-Wahrscheinlichkeit und einen Relevanzscore pro Zeile zurückgibt.
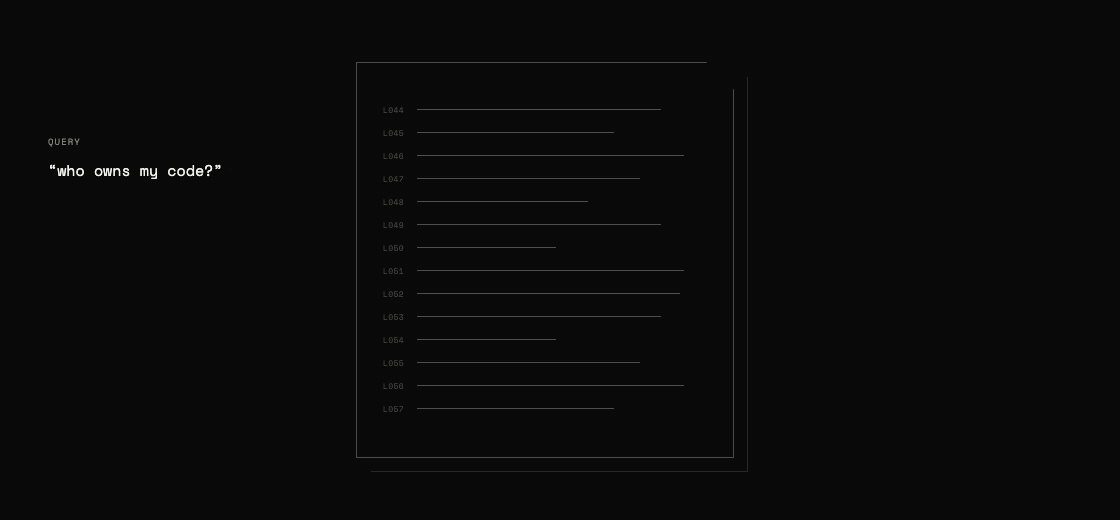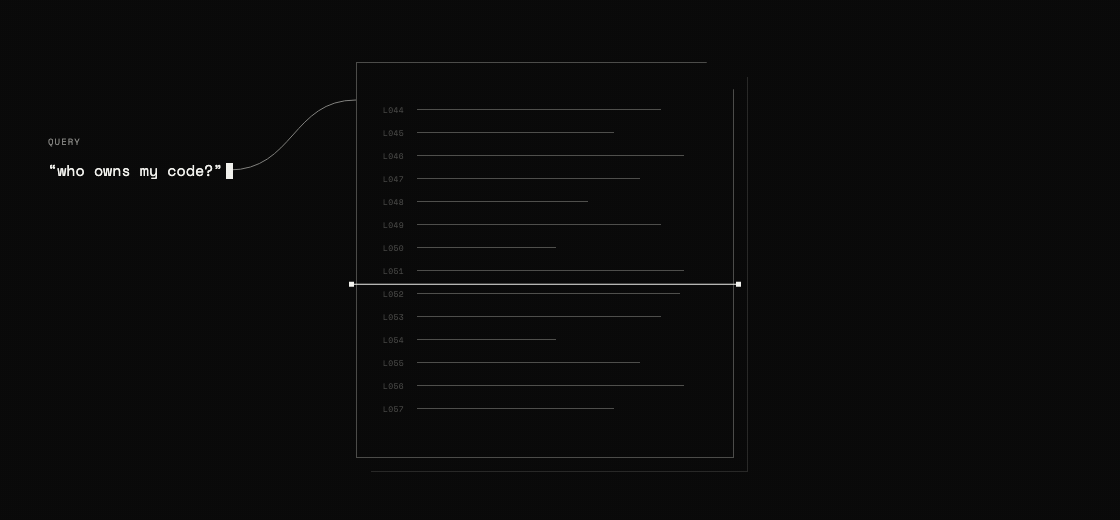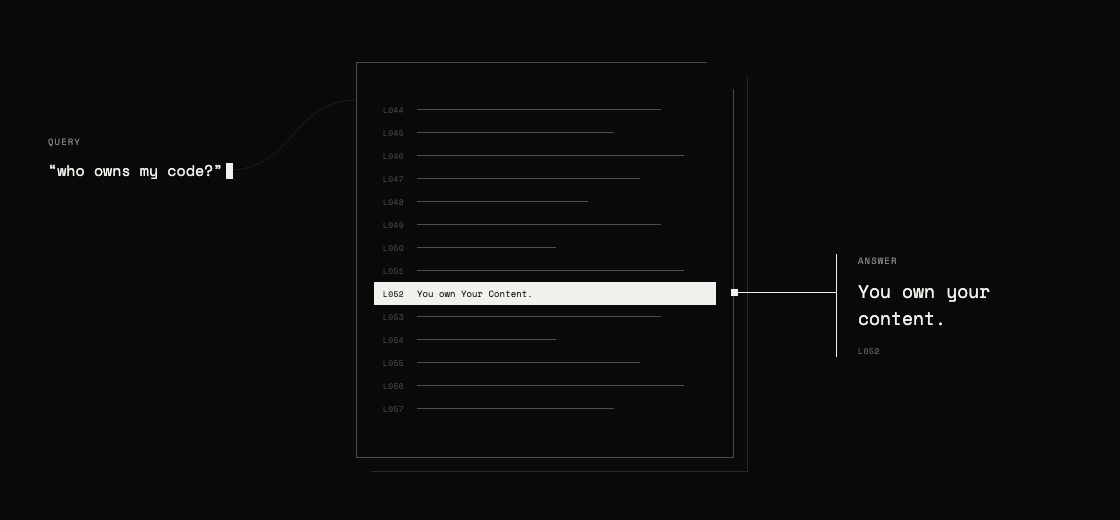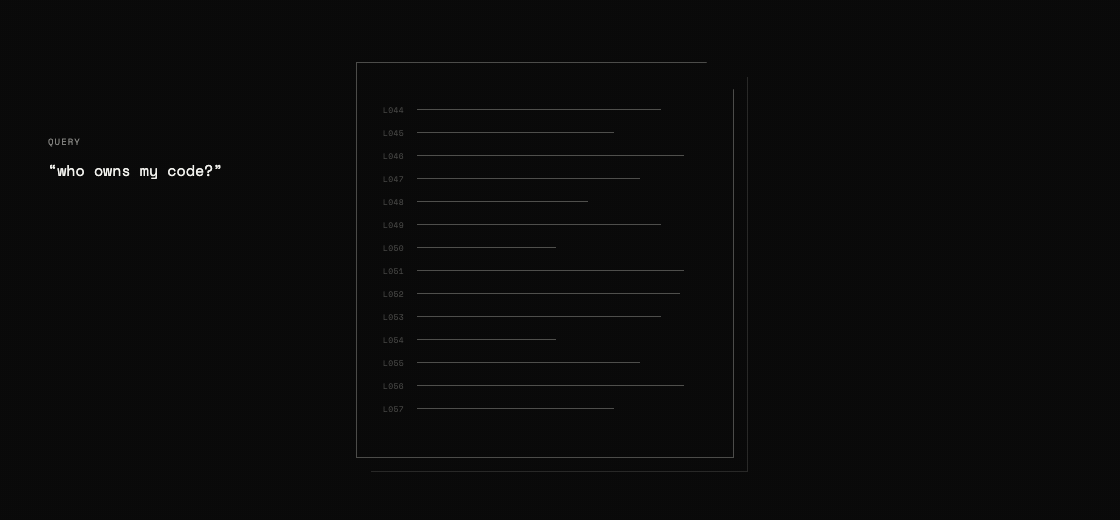
Das Search-Backend setzt sich aus drei Teilen zusammen:
- Markiere jede Zeile mit einer ID, damit TypeSafe sie referenzieren kann.
- Verwende eine
Choice-Frage, um diese Zeilen-IDs danach zu rangieren, wie gut sie die Anfrage beantworten. Choice-Fragen-Wahrscheinlichkeiten summieren sich immer zu 1, sodass eine Zeile auch dann auf Rang 1 landet, wenn keine die Anfrage beantwortet. - Verwende in derselben Anfrage eine
Noul-Frage, um zu prüfen, ob das Dokument überhaupt eine Antwort enthält.
Setup
Holen Sie sich einen TypeSafe-API-Schlüssel
Erstellen Sie einen Schlüssel in der TypeSafe-Konsole und exportieren Sie ihn:
export TYPESAFE_API_KEY="your-key-here"Abhängigkeiten installieren
pip install "typesafe-sdk>=0.5.7" cooksafe \
  --extra-index-url https://pypi.typesafe.ai/
JsonCache spielt die enthaltenen API-Antworten ab, sodass die folgenden Schritte ohne API-Schlüssel
oder Kosten ausgeführt werden. Um die Anfragen live zu stellen, setzen Sie TYPESAFE_API_KEY und löschen
json_cache.json.
Skript erstellen
Start semantic_search.py mit den Imports und dem Client:
import os
import urllib.request
from pathlib import Path

from cooksafe import JsonCache
from typesafe_sdk import Choice, Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"

client = TypeSafeClient(
    api_key=os.environ.get("TYPESAFE_API_KEY", "cache-only"), timeout=120.0
)
json_cache = JsonCache(Path("json_cache.json"))
Schritt 1: Tagge jede Zeile mit einer ID
Das Testdokument sind die Nutzungsbedingungen von GitHub, aufgeteilt in 218 Klauseln, sodass jedes Suchergebnis auf eine zitierfähige Zeile verweist.
Zu semantic_search.py hinzufügen:
GIST = (
    "https://gist.githubusercontent.com/eugene-shvarts/900632789a24983d5678ffd508dd01f6"
    "/raw/cf9c2ab422d568deade949ef0a06bed6896964b9/github-tos.txt"
)


@json_cache
def fetch_document(url: str) -> str:
    request = urllib.request.Request(
        url, headers={"User-Agent": "typesafe-cookbook/1.0"}
    )
    with urllib.request.urlopen(request) as response:
        return response.read().decode()


LINES = fetch_document(GIST).splitlines()
Der Cache verhindert wiederholte Downloads, und splitlines() hinterlässt eine Liste von 218 Strings.
Jetzt jede Zeile mit einer kurzen ID präfixen und die Zeilen wieder zu einem Dokument zusammenfügen. Das Modell verwendet diese IDs, um auf seine Antwort zu verweisen.
def line_id(i: int) -> str:
    return f"L{i:03d}"


DOCUMENT = "\n".join(f"{line_id(i)}| {line}" for i, line in enumerate(LINES))
DOCUMENT sieht jetzt so aus:
L052| You own Your Content. If you post Content you did not create, you are responsible for...
L053| You grant us and other Users the licenses in Sections D.4–D.8. These licenses apply...
L054| 4. License Grant to Us
Schritt 2: Fragen, wo die Antwort ist
Eine Choice Frage gibt für jede Option eine Wahrscheinlichkeit zurück. Verwenden Sie die Zeilen-IDs als Optionen, und „eine Option auswählen“ wird zu „auf eine Zeile zeigen“.
def where_question(query: str) -> Choice:
    return Choice(
        instructions=f'Which line of the document contains the answer to: "{query}"?',
        criteria={line_id(i): None for i in range(len(LINES))},
    )
Die Optionsbeschreibungen sind None, da das Dokument den Text für jede ID bereits enthält. Die Abfrage erfolgt in instructions; der Zustand bleibt zwischen den Suchen unverändert.
Hinweis — Eine
Choice-Frage akzeptiert bis zu 255 Optionen, daher durchsucht dieses Rezept Dokumente mit bis zu 255 Zeilen in einer einzigen Anfrage. Darüber hinaus suchen Sie in zwei Durchgängen: Eine Choice-Frage wählt einen Zeilenbereich aus, und eine zweite Rangfolge bewertet die Zeilen darin.
Schritt 3: Prüfen, ob eine Antwort existiert
Die Wahrscheinlichkeiten der Choice-Werte summieren sich immer zu 1, sodass einige Zeilenranglisten an erster Stelle stehen, auch wenn das Dokument die Frage nicht beantwortet. Die Rangliste allein kann keine echte Antwort von der nächstgelegenen irrelevanten Zeile unterscheiden.
Stelle also eine zweite Frage in derselben Anfrage:
def exists_question(query: str) -> Noul:
    return Noul(
        instructions=f'Does any line of the document address or answer: "{query}"?',
        criteria=NoulCriteria(
            true="At least one line of the document states or directly implies the answer",
            false="No line of the document addresses this",
        ),
    )
Im Gegensatz zu den Choice-Wahrscheinlichkeiten hängt die Noul-Wahrscheinlichkeit nicht von den anderen Optionen ab, daher kann sie nahe bei Null liegen, wenn das Dokument keine Antwort enthält.
Schritt 4: Senden Sie beide Fragen in einer Anfrage
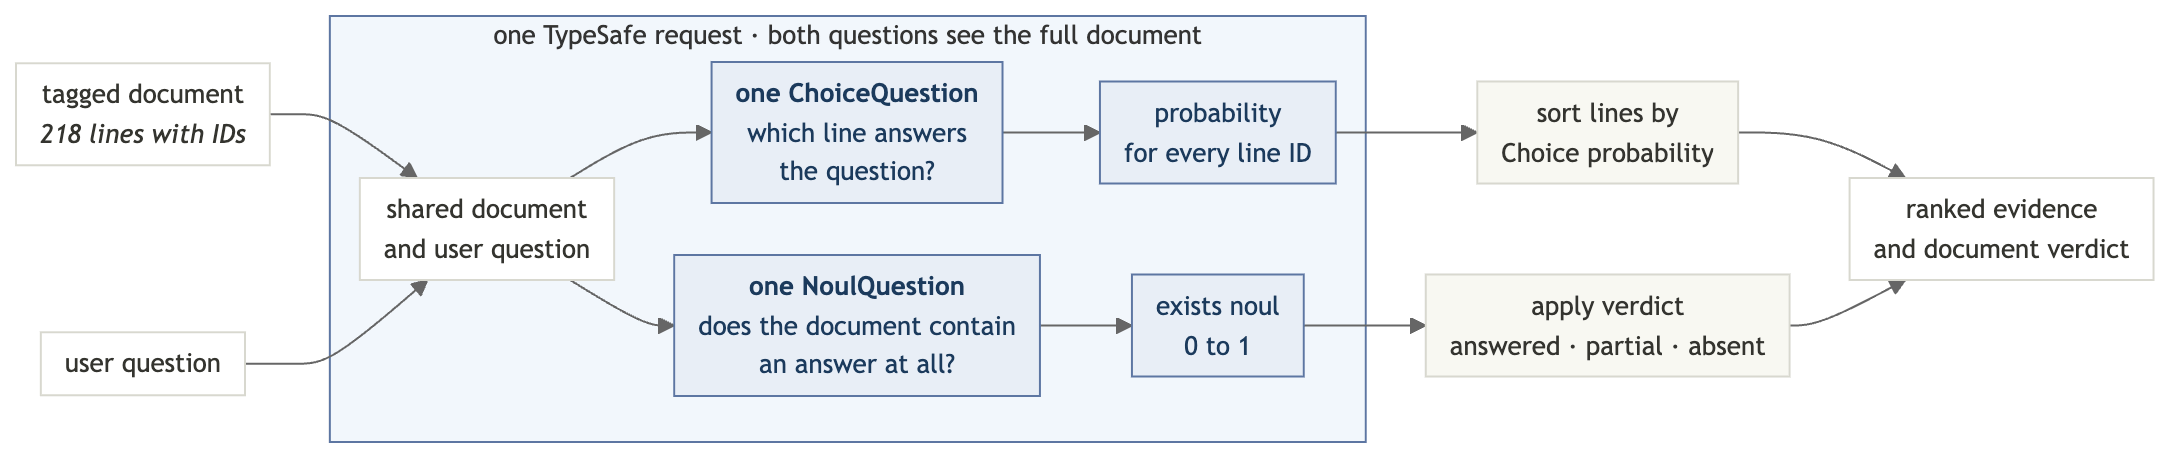
Die system_one-Methode beantwortet beide Fragen in einem Durchlauf. Der Zustand wird einmal gesendet, sodass das Hinzufügen der Existenzprüfung nur eine geringe Menge an zusätzlichem Output erfordert.
@json_cache
def _find(
    model: str,
    state: str,
    where: Choice,
    exists: Noul,
) -> dict:
    response = client.system_one(
        state=state,
        questions={"where": where, "exists": exists},
        model=model,
    )
    probabilities = response.answers["where"].probabilities
    return {
        "exists": response.answers["exists"].noul,
        "relevance": [probabilities.get(line_id(i), 0.0) for i in range(len(LINES))],
    }


def find(query: str) -> dict:
    return _find(
        TYPESAFE_MODEL,
        DOCUMENT,
        where_question(query),
        exists_question(query),
    )
Die relevance-Liste führt einen Score pro Zeile in Dokumentreihenfolge auf.
Schritt 5: das Ergebnis lesen
Zwei lokale Code-Snippets erledigen die Arbeit: verdict() wandelt die rohe exists-Wahrscheinlichkeit in drei Zustände um, wobei ein mittlerer Zustand für partielle Antworten vorgesehen ist, und show() stellt relevance als Balkendiagramm dar, sodass die Rangfolge in einem Terminal ablesbar ist.
FOUND, ABSENT = 0.7, 0.35  # present answers typically read >=0.9, absent <=0.05


def verdict(exists: float) -> str:
    if exists >= FOUND:
        return "answered in this document"
    return "not in this document" if exists < ABSENT else "partially addressed"


def show(query: str, top: int = 4) -> dict:
    result = find(query)
    print(f'"{query}"')
    print(f"  exists {result['exists']:.2f} -> {verdict(result['exists'])}")
    ranked = sorted(
        range(len(LINES)), key=lambda i: result["relevance"][i], reverse=True
    )
    for i in ranked[:top]:
        bar = "#" * max(1, round(result["relevance"][i] * 12))
        preview = LINES[i][:58].rstrip()
        print(f"  {line_id(i)}  {result['relevance'][i]:.2f}  {bar:<12}  {preview}")
    return result
Diese Schwellenwerte trennen die folgenden Beispiele, sollten aber vor dem Einsatz in der Produktion an Ihre eigenen Dokumente angepasst werden.
Schritt 6: die Suche ausführen
Stelle zwei Fragen, die direkte Antworten haben, eine Frage, die keine Antwort hat, und eine Frage, die eine teilweise Antwort hat, insgesamt vier.
print(f"{len(LINES)} lines, {len(DOCUMENT):,} characters\n")
show("who owns the code I upload?")
print()
show("can GitHub kick me off the platform without warning?")
print()
show("do I have to take disputes to arbitration?", top=2)
print()
show("can minors use GitHub with parental permission?", top=2)
218 lines, 43,980 characters
"who owns the code I upload?"
exists 0.98 -> answered in this document
L052 0.95 ########### You own Your Content. If you post Content you did not crea
L046 0.02 # Short version: You own content you create, but you allow u
L051 0.02 # 3. Ownership and License Grants
L217 0.01 # Questions about the Terms of Service? Contact us through t
"can GitHub kick me off the platform without warning?"
exists 0.97 -> answered in this document
L168 0.97 ############ GitHub has the right to suspend or terminate your access t
L167 0.03 # 3. GitHub May Terminate
L000 0.00 # Effective date: April 27, 2026 · A. Definitions
L001 0.00 # Short version: We use these basic terms throughout the agr
"do I have to take disputes to arbitration?"
exists 0.14 -> not in this document
L205 0.86 ########## Except to the extent applicable law provides otherwise, th
L168 0.02 # GitHub has the right to suspend or terminate your access t
"can minors use GitHub with parental permission?"
exists 0.46 -> partially addressed
L029 0.90 ########### You must be age 13 or older. While we are thrilled to see
L012 0.07 # “User,” “You,” and “Your” refer to the individual person,Was die Werte bedeuten
Die ersten beiden Abfragen liefern direkte Antworten und die zur Verifizierung benötigten Quellzeilen.
Die anderen beiden zeigen, warum die Existenzprüfung wichtig ist:
- Schiedsverfahren: Die Rangliste gibt der nächsten Zeile eine Punktzahl von 0,86, aber
existsist nur 0,14. Die Antwort ist nicht im Dokument enthalten. - Elterliche Erlaubnis: Die Altersregel rangiert an erster Stelle, aber sie beantwortet nicht, ob die elterliche Erlaubnis die Regel ändert. Das Ergebnis ist teilweise behandelt.
Die Rangliste sagt Ihnen, wo Sie suchen müssen; die exists-Punktzahl sagt Ihnen, ob das Ergebnis die Frage beantwortet.
Probieren Sie es mit Ihrem eigenen Dokument aus
Öffne den markierten Vertrag im TypeSafe-Playground, um die Fragen gegen denselben Text zu bearbeiten. Um deine eigenen zu durchsuchen, tausche die URL in fetch_document(); jede andere Zeile des Skripts arbeitet mit LINES.