 JevCode
Recherche ligne par ligne
Construisez une recherche sémantique pour les Conditions d'utilisation de GitHub. En une seule requête, évaluez 218 identifiants de lignes par rapport à une requête en langage courant avec une question Choice, et utilisez une question Noul pour vérifier si le document contient une réponse.
Traduit automatiquement depuis le en, non relu. À utiliser comme référence rapide uniquement.

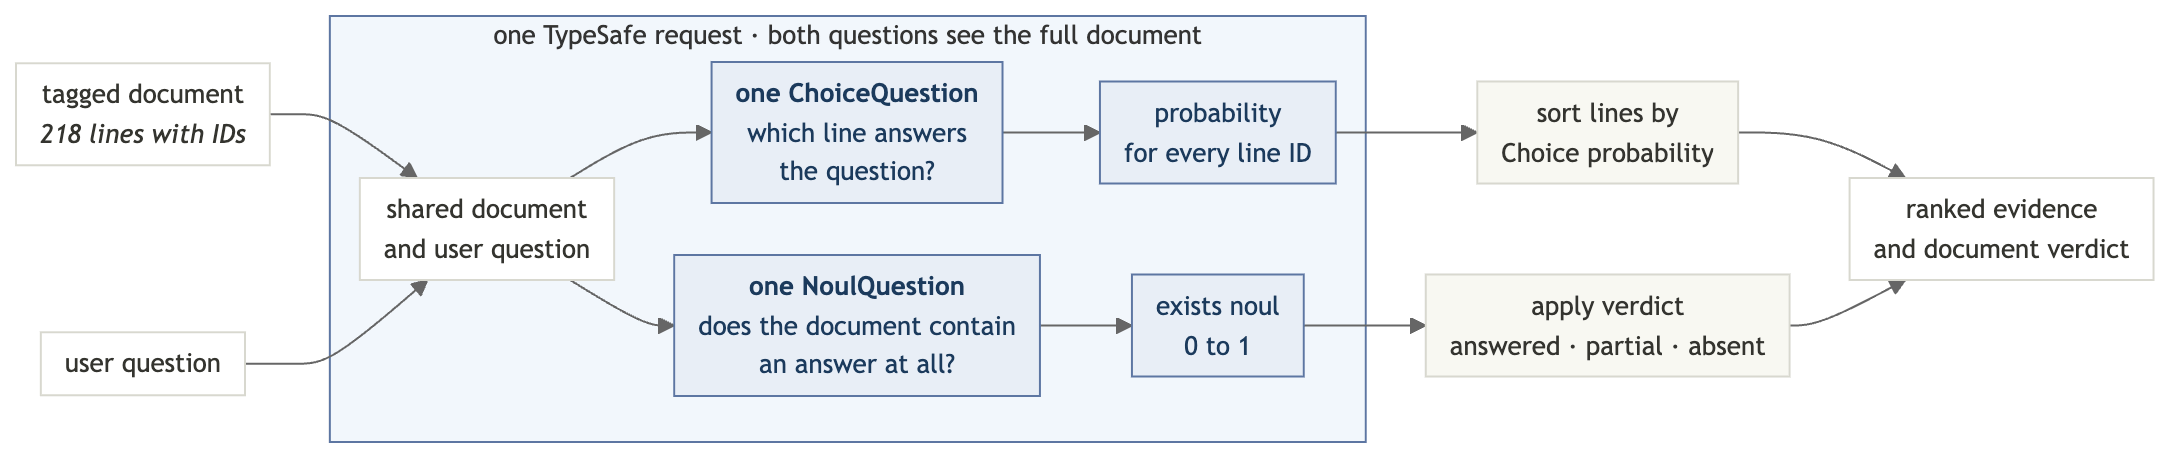
Vous avez les Conditions d’utilisation de GitHub et une question en langage clair à ce sujet. Vous avez besoin des lignes qui répondent à la question et d’un moyen de détecter quand le document ne contient aucune réponse. Les requêtes incluses classent les lignes avec des réponses directes en premier. Les seuils exists classent les cas restants comme manquants ou partiels. Vous obtenez find(), qui retourne la probabilité exists et un score de pertinence par ligne.
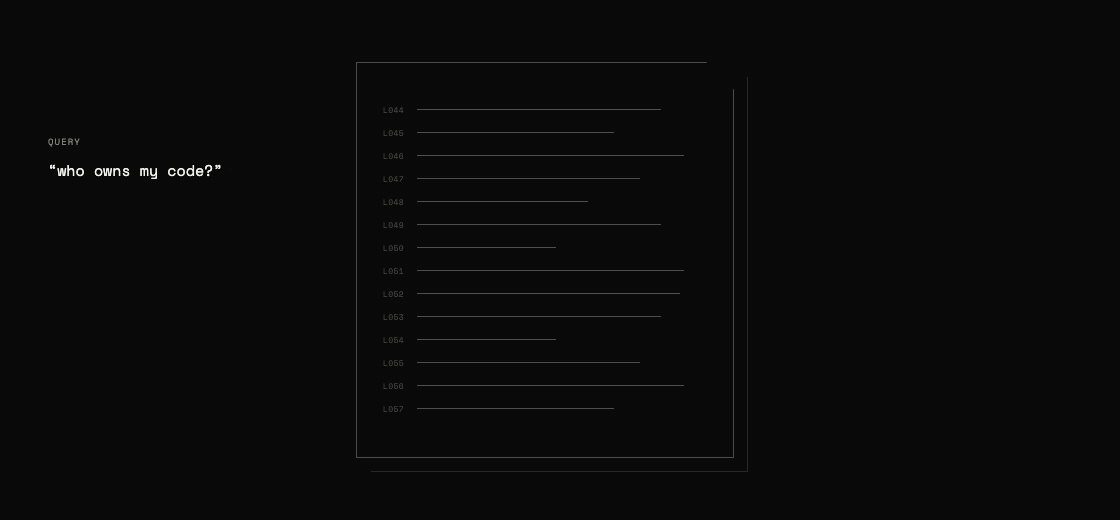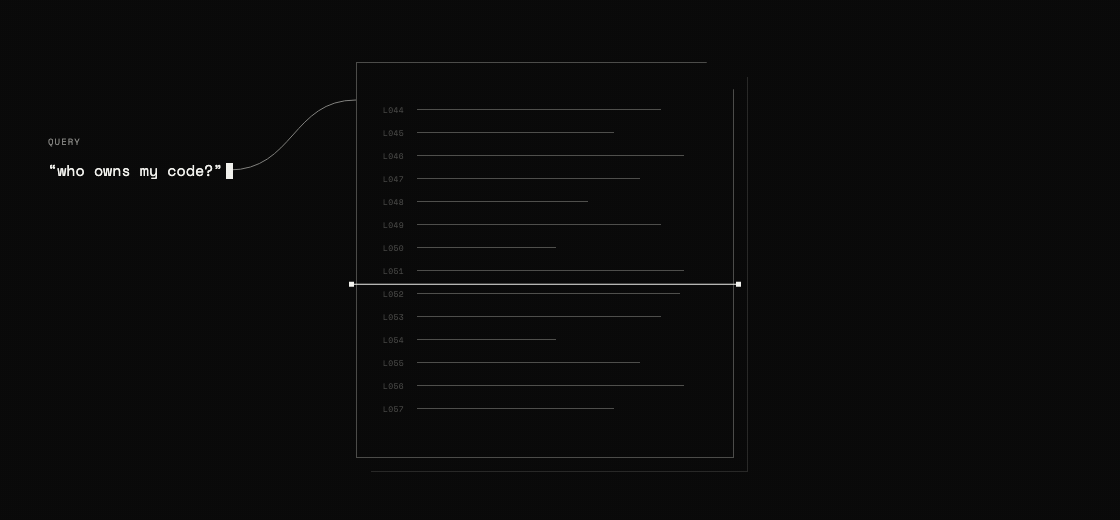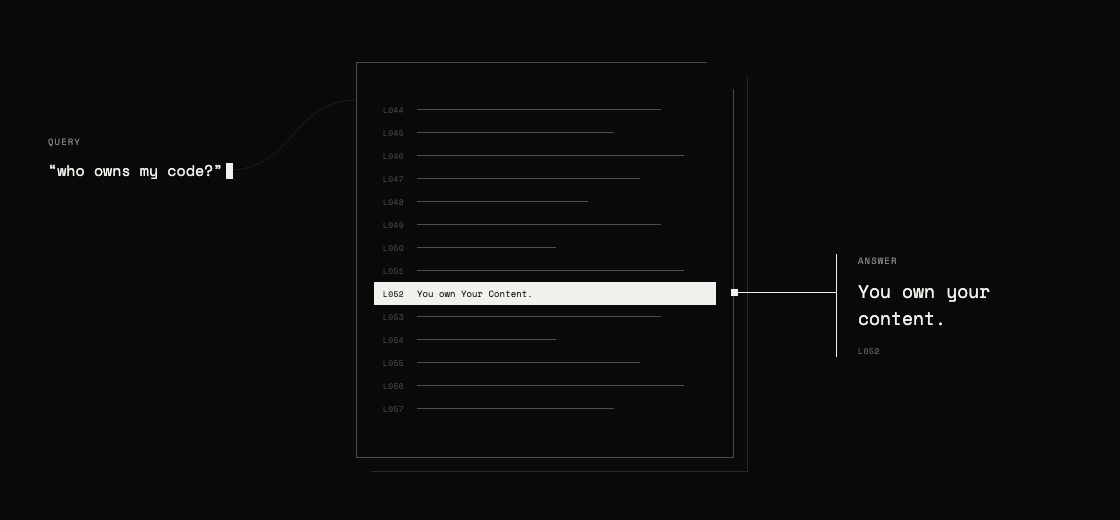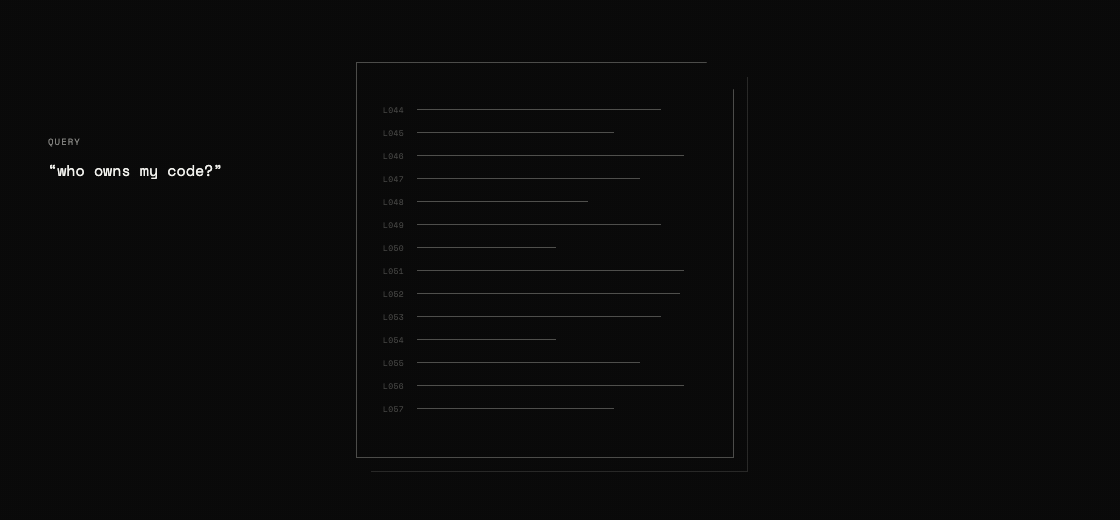
Le backend de recherche s’articule autour de trois parties :
- Attribuez un ID à chaque ligne afin que TypeSafe puisse y faire référence.
- Utilisez une question
Choicepour classer ces IDs de ligne selon la pertinence de leur réponse à la requête. Les probabilités d’une question Choice s’additionnent toujours à 1, de sorte qu’une ligne est classée première même si aucune ne répond à la requête. - Dans la même requête, utilisez une question
Noulpour vérifier si le document contient une réponse.
Configuration
Obtenir une clé API TypeSafe
Créez une clé dans la console TypeSafe et exportez-la :
export TYPESAFE_API_KEY="your-key-here"Installer les dépendances
pip install "typesafe-sdk>=0.5.7" cooksafe \
  --extra-index-url https://pypi.typesafe.ai/
JsonCache rejoue les réponses API incluses, de sorte que les étapes ci-dessous s’exécutent sans clé API ni coût. Pour rendre les requêtes réelles, définissez TYPESAFE_API_KEY et supprimez json_cache.json.
Créer le script
Commencez semantic_search.py avec les imports et le client :
import os
import urllib.request
from pathlib import Path

from cooksafe import JsonCache
from typesafe_sdk import Choice, Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"

client = TypeSafeClient(
    api_key=os.environ.get("TYPESAFE_API_KEY", "cache-only"), timeout=120.0
)
json_cache = JsonCache(Path("json_cache.json"))
Étape 1 : associez un ID à chaque ligne
Le document de test est les Conditions d’utilisation de GitHub, divisées en 218 clauses, de sorte que chaque résultat de recherche renvoie à une ligne citable.
Ajouter à semantic_search.py :
GIST = (
    "https://gist.githubusercontent.com/eugene-shvarts/900632789a24983d5678ffd508dd01f6"
    "/raw/cf9c2ab422d568deade949ef0a06bed6896964b9/github-tos.txt"
)


@json_cache
def fetch_document(url: str) -> str:
    request = urllib.request.Request(
        url, headers={"User-Agent": "typesafe-cookbook/1.0"}
    )
    with urllib.request.urlopen(request) as response:
        return response.read().decode()


LINES = fetch_document(GIST).splitlines()
Le cache empêche les téléchargements répétés, et splitlines() laisse une liste de 218 chaînes.
Maintenant, préfixez chaque ligne par un court ID et rejoignez les lignes pour former un seul document. Le modèle utilise ces ID pour pointer vers sa réponse.
def line_id(i: int) -> str:
    return f"L{i:03d}"


DOCUMENT = "\n".join(f"{line_id(i)}| {line}" for i, line in enumerate(LINES))
DOCUMENT ressemble maintenant à ceci :
L052| You own Your Content. If you post Content you did not create, you are responsible for...
L053| You grant us and other Users the licenses in Sections D.4–D.8. These licenses apply...
L054| 4. License Grant to Us
Étape 2 : demander où se trouve la réponse
Une question Choice renvoie une probabilité pour chaque option. Utilisez les IDs de ligne comme options,
et « choisir une option » devient « pointer une ligne. »
def where_question(query: str) -> Choice:
    return Choice(
        instructions=f'Which line of the document contains the answer to: "{query}"?',
        criteria={line_id(i): None for i in range(len(LINES))},
    )
Les descriptions des options sont None car le document contient déjà le texte pour chaque
ID. La requête va dans instructions ; l’état reste inchangé entre les recherches.
Note — Une question
Choiceaccepte jusqu’à 255 options, donc cette recette recherche des documents d’au maximum 255 lignes en une seule requête. Au-delà, effectuez la recherche en deux passes : une question Choice sélectionne une fenêtre de lignes, et une seconde classe les lignes à l’intérieur.
Étape 3 : vérifier s’il existe une réponse
Les probabilités de choix s’additionnent toujours à 1, donc certaines lignes arrivent en premier rang même lorsque le document ne répond pas à la question. Le seul classement ne permet pas de distinguer une réponse réelle de la ligne non pertinente la plus proche.
Alors posez une deuxième question, dans la même requête :
def exists_question(query: str) -> Noul:
    return Noul(
        instructions=f'Does any line of the document address or answer: "{query}"?',
        criteria=NoulCriteria(
            true="At least one line of the document states or directly implies the answer",
            false="No line of the document addresses this",
        ),
    )
Contrairement aux probabilités de Choice, la probabilité de Noul ne dépend pas des autres options, elle peut donc être proche de zéro lorsque le document ne contient pas de réponse.
Étape 4 : envoyer les deux questions dans une seule requête
La méthode system_one répond aux deux questions en un seul passage. L’état est envoyé une seule fois, donc l’ajout de la vérification d’existence ne nécessite qu’une petite quantité de sortie supplémentaire.
@json_cache
def _find(
    model: str,
    state: str,
    where: Choice,
    exists: Noul,
) -> dict:
    response = client.system_one(
        state=state,
        questions={"where": where, "exists": exists},
        model=model,
    )
    probabilities = response.answers["where"].probabilities
    return {
        "exists": response.answers["exists"].noul,
        "relevance": [probabilities.get(line_id(i), 0.0) for i in range(len(LINES))],
    }


def find(query: str) -> dict:
    return _find(
        TYPESAFE_MODEL,
        DOCUMENT,
        where_question(query),
        exists_question(query),
    )
La liste relevance maintient un score par ligne, dans l’ordre du document.
Étape 5 : lire le résultat
Deux morceaux de code local terminent le travail : verdict() transforme la probabilité brute exists en trois états, avec un état intermédiaire pour les réponses partielles, et show() affiche relevance sous forme de graphique en barres afin que le classement soit lisible dans un terminal.
FOUND, ABSENT = 0.7, 0.35  # present answers typically read >=0.9, absent <=0.05


def verdict(exists: float) -> str:
    if exists >= FOUND:
        return "answered in this document"
    return "not in this document" if exists < ABSENT else "partially addressed"


def show(query: str, top: int = 4) -> dict:
    result = find(query)
    print(f'"{query}"')
    print(f"  exists {result['exists']:.2f} -> {verdict(result['exists'])}")
    ranked = sorted(
        range(len(LINES)), key=lambda i: result["relevance"][i], reverse=True
    )
    for i in ranked[:top]:
        bar = "#" * max(1, round(result["relevance"][i] * 12))
        preview = LINES[i][:58].rstrip()
        print(f"  {line_id(i)}  {result['relevance'][i]:.2f}  {bar:<12}  {preview}")
    return result
Ces seuils séparent les exemples ci-dessous, mais ajustez-les en fonction de vos propres documents avant de les utiliser en production.
Étape 6 : exécuter la recherche
Posez deux questions qui ont des réponses directes, une qui n’a pas de réponse, et une qui a une réponse partielle, quatre au total.
print(f"{len(LINES)} lines, {len(DOCUMENT):,} characters\n")
show("who owns the code I upload?")
print()
show("can GitHub kick me off the platform without warning?")
print()
show("do I have to take disputes to arbitration?", top=2)
print()
show("can minors use GitHub with parental permission?", top=2)
218 lines, 43,980 characters
"who owns the code I upload?"
exists 0.98 -> answered in this document
L052 0.95 ########### You own Your Content. If you post Content you did not crea
L046 0.02 # Short version: You own content you create, but you allow u
L051 0.02 # 3. Ownership and License Grants
L217 0.01 # Questions about the Terms of Service? Contact us through t
"can GitHub kick me off the platform without warning?"
exists 0.97 -> answered in this document
L168 0.97 ############ GitHub has the right to suspend or terminate your access t
L167 0.03 # 3. GitHub May Terminate
L000 0.00 # Effective date: April 27, 2026 · A. Definitions
L001 0.00 # Short version: We use these basic terms throughout the agr
"do I have to take disputes to arbitration?"
exists 0.14 -> not in this document
L205 0.86 ########## Except to the extent applicable law provides otherwise, th
L168 0.02 # GitHub has the right to suspend or terminate your access t
"can minors use GitHub with parental permission?"
exists 0.46 -> partially addressed
L029 0.90 ########### You must be age 13 or older. While we are thrilled to see
L012 0.07 # “User,” “You,” and “Your” refer to the individual person,Ce que signifient les scores
Les deux premières requêtes retournent des réponses directes et les lignes sources nécessaires pour les vérifier.
Les deux autres montrent pourquoi la vérification d’existence est importante :
- Arbitrage : Le classement attribue un score de 0,86 à la ligne la plus proche, mais
existsn’obtient que 0,14. La réponse ne figure pas dans le document. - Autorisation parentale : La règle d’âge arrive en tête, mais elle ne répond pas à la question de savoir si l’autorisation parentale modifie cette règle. Le résultat est partiellement abordé.
Le classement vous indique où chercher ; le score exists vous indique si le résultat
répond à la question.
Essayez-le sur votre propre document
Ouvrir le contrat balisé dans le playground TypeSafe pour modifier les questions
par rapport au même texte. Pour rechercher le vôtre, remplacez l’URL dans fetch_document() ; chaque autre
ligne du script fonctionne avec LINES.