 JevCode
Réordonnancement
Génère des listes restreintes BM25 de 30 passages pour 40 requêtes juridiques CLERC, puis utilise une question TypeSafe par paire requête-candidat pour faire passer la précision top-1 de 5 % à 18 % et la précision top-10 de 38 % à 62 %.
Traduit automatiquement depuis le en, non relu. À utiliser comme référence rapide uniquement.

Vous avez des milliers de documents, et vous devez trouver celui qui répond à une question spécifique. Alors, comment le trouvez-vous ?
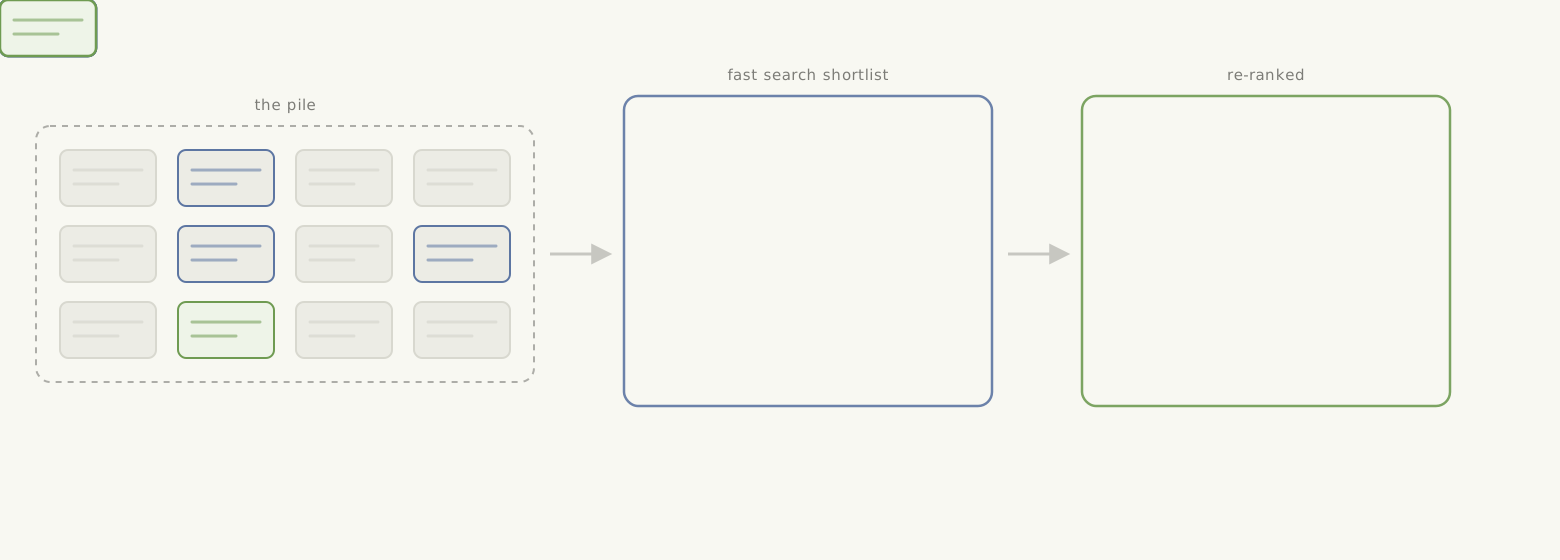
Commencez par utiliser une méthode rapide, telle que la correspondance de mots-clés, pour réduire ces milliers de candidats à une courte liste de candidats plausibles. Nous appelons cela la recherche rapide.
La recherche rapide est bonne pour cela, mais elle ne peut pas vous dire quel candidat de la liste restreinte est correct. C’est là qu’intervient le réordonnancement. Il évalue chaque candidat de la liste restreinte par rapport à la requête directement, et place le meilleur en premier.
Les deux étapes s’exécutent ci-dessous sur 3 565 passages d’arrêts de justice issus du jeu de données CLERC : BM25 construit une liste restreinte de recherche rapide de 30 candidats pour chacune des 40 requêtes, puis TypeSafe réordonne chaque liste. Avec le réordonnancement, le passage correct se retrouve en première position pour 18 % des requêtes, en hausse par rapport aux 5 % obtenus avec la seule recherche rapide.
Au fil du chemin, vous allez apprendre :
- Ce que fait la recherche rapide, et pourquoi elle ne constitue pas la réponse complète
- Ce qu’est le ré-ordonnancement, et comment il s’intègre après une étape de recherche rapide
- Comment TypeSafe évalue un candidat par rapport à une requête, et dans quelle mesure cela améliore le résultat
Essayez par vous-même
Ouvrir une requête, un candidat et une question de ré-ordonnancement dans le playground TypeSafe
Comment trouve-t-on un document parmi des milliers ?
Vous avez un tas de documents, et une requête, un morceau de texte décrivant ce que vous cherchez. Quelque part dans le tas se trouve le document unique qui y répond.
Vérifier chaque document par rapport à la requête un par un fonctionne, avec une comparaison par document : des millions de documents signifient des millions de comparaisons par requête. Vous pouvez améliorer les performances avec une approche en deux étapes :
- Réduisez la liste à un petit nombre de candidats probables, en utilisant une méthode suffisamment rapide pour être exécutée sur l’ensemble de la liste.
- Appliquez une étape plus précise à cette courte liste, afin de trouver la réponse exacte.
Ce cookbook teste cette configuration sur un jeu de données d’avis de justice, dans Le réordonnancement sur un exemple réel ci-dessous.
Qu’est-ce que la recherche rapide ?
La recherche rapide est toute méthode capable de comparer une requête à chaque document d’un vaste corpus et de retourner rapidement une courte liste classée. Les méthodes courantes incluent la recherche par mots-clés, comme BM25, et les plongements denses, qui comparent les passages par leur sens. Les systèmes combinent souvent les deux méthodes.
La première étape ici est BM25 et rien d’autre. BM25 classe les passages par mots partagés. Garder cette étape simple permet de concentrer l’attention sur le reclassement, qui est l’objet du livre de recettes. Le choix de la méthode de recherche rapide est une question secondaire : le reclassement ne voit jamais que les passages qui figurent dans la liste restreinte.
Qu’est-ce que le re-ranking ?
Le réordonnancement prend la liste rapide déjà produite par la recherche et la place dans un meilleur ordre. Au lieu de comparer la requête avec tout le corpus en une seule fois, il compare la requête avec chaque candidat de la liste individuellement, et trie la liste par ce score.
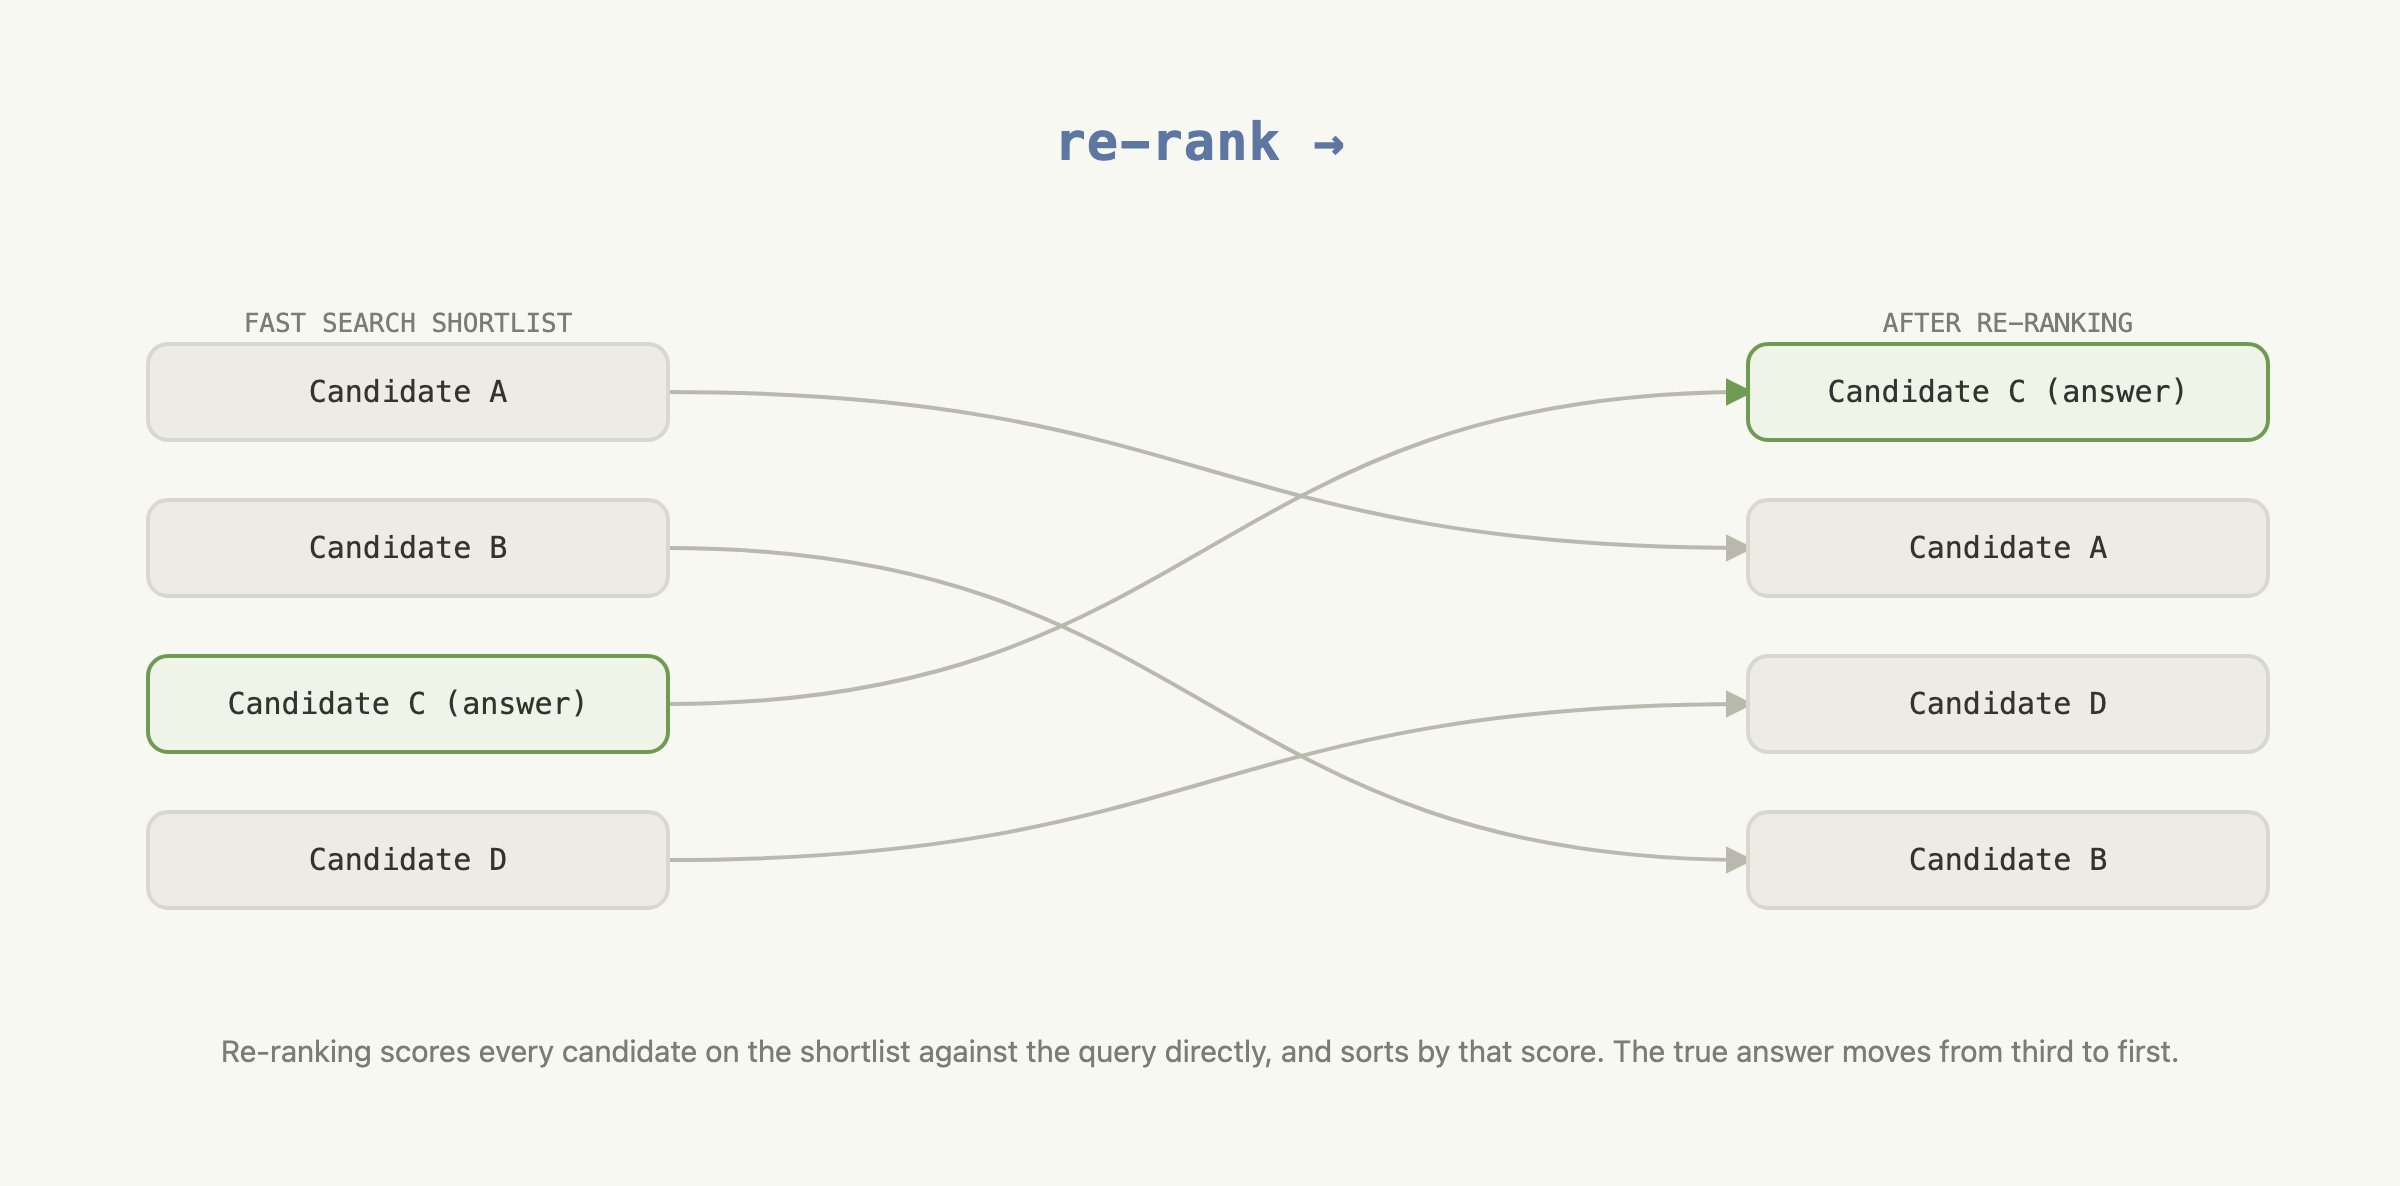
Le score peut provenir d’un modèle de langage. Fournissez-lui la requête et un candidat ensemble et demandez dans quelle mesure le candidat répond à la requête. Le réordonnancement trouve ensuite le meilleur résultat sur la liste restreinte, même lorsque sa formulation diffère de celle de la requête.
Réordonnancement avec TypeSafe
Un re-ranker a besoin d’une score comparable pour chaque paire requête-candidat. Un modèle de langage à usage général peut produire ces scores, ou classer directement toute la courte liste. Pour la notation indépendante des paires, cependant, vous devez définir une échelle de notation et inviter le modèle à appliquer la même norme à chaque candidat. Des appels répétés peuvent toujours produire des scores différents pour la même paire, tandis que la génération à usage général ajoute du temps et des coûts à une tâche qui ne nécessite qu’un seul nombre.
Ce que TypeSafe retourne
Avec TypeSafe, la demande de notation peut rester une question par oui ou non :
Could this candidate passage be from the cited precedent?Un simple oui ou non ne suffirait pas pour classer 30 candidats. Un Noul renvoie plutôt un nombre compris entre 0 et 1, appelé un
noul. Le noul est l’estimation de TypeSafe
de la probabilité que la réponse soit oui.
Les critères de la question définissent ce qui compte comme vrai et faux. TypeSafe les applique à chaque paire requête-candidat et renvoie le noul directement. Ce noul est le score sur lequel l’application trie. Aucune échelle de notation n’a besoin d’être inventée pour un modèle à usage général, et TypeSafe est conçu pour effectuer cette notation répétée plus rapidement, à moindre coût et de manière plus cohérente.
En pseudocode simplifié, un appel de notation TypeSafe ressemble à ceci :
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe lit la requête et un candidat ensemble par rapport à cette question, et retourne un noul.
Vous pouvez l’utiliser pour reclasser une liste restreinte en posant la même question à chaque candidat, puis en triant la liste restreinte selon le noul retourné par chaque appel, du plus élevé au plus bas.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
Le diagramme ci-dessous montre comment une requête par candidat produit les scores utilisés pour réorganiser la liste restreinte.
Direction du flux : LR
| Nœud | Description | Groupe |
|---|---|---|
q |
extrait de la requête / un passage d’opinion, / citation supprimée | — |
sl |
liste restreinte issue de la recherche rapide / 30 passages candidats | — |
quest |
un Noul / ce candidat pourrait-il provenir / du précédent cité ? / correction des critères vrai et faux | — |
fan |
une requête par candidat · aucune requête ne voit les autres | une requête par candidat · aucune requête ne voit les autres |
sort |
tri par Noul, / du plus élevé au plus bas | — |
out |
liste restreinte réordonnée / mêmes 30, meilleur ordre | — |
| De | Condition | À |
|---|---|---|
q |
— | fan |
sl |
— | fan |
quest |
— | fan |
fan |
— | sort |
Un exemple de ré-échantillonnage
La recherche rapide et le réordonnancement s’exécutent désormais sur CLERC, un jeu de données de récupération juridique. Cet exemple utilise 3 565 passages d’avis de tribunal et 40 requêtes.
Configuration
La première étape installe les paquets dont dépend ce tutoriel.
bm25setdatasetsconstruisent la courte liste de recherche rapide.typesafe-sdketcooksafegèrent le reclassement et la mise en cache de l’API.matplotlibgénère les graphiques de résultats.
pip install bm25s datasets matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Le bloc suivant configure le client TypeSafe et les constantes que le reste du tutoriel utilise, telles que le modèle TypeSafe à appeler et la taille d’une shortlist que la recherche rapide transmet au re-ranker. L’appel à TypeSafe nécessite un TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import msgspec
from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Classement des passages avec une recherche rapide
Le jeu de données utilisé ici est un corpus d’avis de tribunaux américains, regroupant 170 lignes. Chaque ligne se décompose comme suit :
- Requête : un extrait d’opinion avec une citation supprimée.
- Référence : le passage vers lequel la citation supprimée pointait, la seule réponse correcte à la requête.
- Candidats : tous les autres passages du corpus, chacun étant quelque chose que la requête pourrait être associée par erreur.
Parmi les 170 lignes, 40 sont sélectionnées pour être évaluées en tant que requêtes. Les 130 autres n’apparaissent jamais que comme des candidats.
La cellule suivante construit la shortlist, en utilisant la technique décrite ci-dessus :
- Charger le corpus.
- Le classer par rapport à chaque requête avec BM25.
Il n’y a pas encore de TypeSafe ici, ce n’est que l’étape de recherche rapide.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)


def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]


@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}


def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}


def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None


SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"


def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)


ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)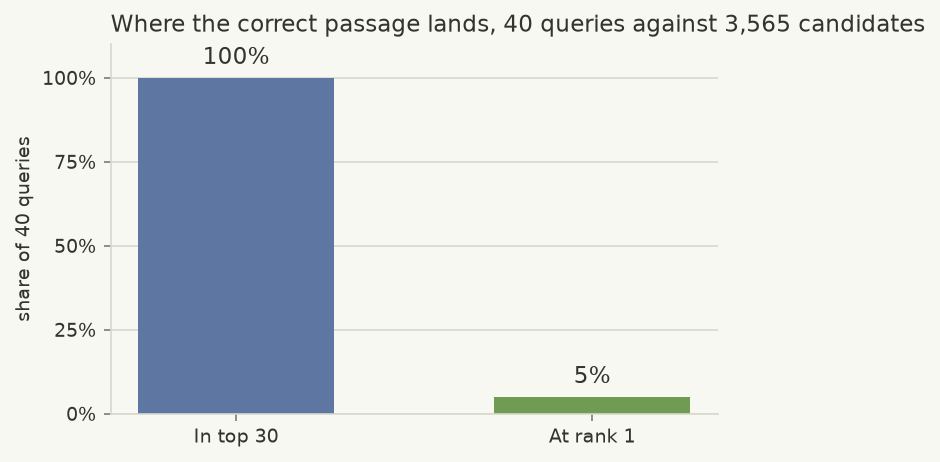
La recherche rapide a peu de chances de classer le bon passage en premier
Le graphique montre où la recherche rapide place le passage correct, sur 3 565 candidats.
La recherche rapide permet de réduire de manière fiable le corpus à une courte liste contenant la bonne réponse. Elle contient la bonne réponse pour 100 % des 40 requêtes. Mais ce passage est rarement le premier de la courte liste, seulement 5 % du temps.
Le réordonnancement ci-dessous ne fait que réorganiser les 30 meilleurs candidats déjà présents dans la liste restreinte. Il ne peut pas ajouter de passage que la recherche rapide n’a pas sélectionné. Ici, la liste restreinte contient le passage correct pour les 40 requêtes, le réordonnancement peut donc se concentrer sur le placement de chacun à une meilleure position.
Réordonnancement avec TypeSafe
Réévaluer les scores de chaque candidat de la liste restreinte par rapport à sa requête, puis les trier selon ce score. La question que TypeSafe se pose pour chaque paire est de savoir si le candidat pourrait être le passage vers lequel pointe la citation supprimée de la requête.
La cellule suivante effectue ce qui suit :
- Définissez cette question.
- Posez-la une fois par candidat sur chaque liste restreinte, 40 requêtes pour 30 candidats, soit 1 200 appels au total, exécutés de manière concurrente plutôt que séquentielle.
- Triez chaque liste restreinte selon le score renvoyé par TypeSafe, produisant ainsi le résultat réordonné.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)


@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = msgspec.json.encode(is_cited_source).decode()
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}


def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)


chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.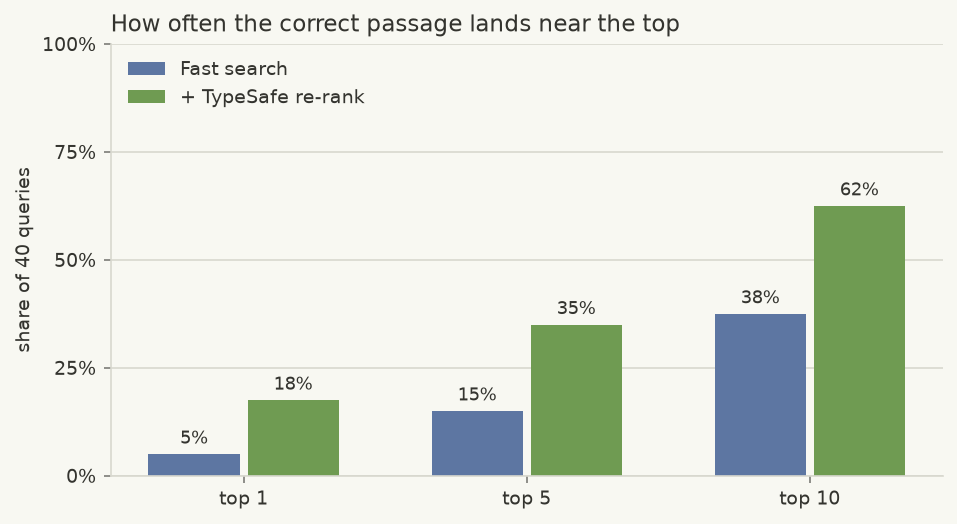
Le re-ranking déplace la bonne réponse vers le haut
Le graphique compare la recherche rapide à la recherche rapide avec réordonnancement, à trois seuils. Le réordonnancement rapproche le passage correct du sommet à chacun d’eux :
- Top 1 — 5 % → 18 %
- Top 5 — 15 % → 35 %
- Top 10 — 38 % → 62 %
Le nombre de jetons signalé et le coût couvrent les 1 200 appels TypeSafe utilisés pour réordonner les 40 listes restreintes.
Chaque ligne CLERC contient un passage correct et 20 passages négatifs. Ce guide regroupe les passages de 170 lignes en un corpus partagé. Pour chacune des 40 requêtes d’évaluation, BM25 sélectionne 30 candidats à partir de ce corpus complet, et non uniquement les 20 passages négatifs fournis avec cette ligne. TypeSafe lit ensuite la requête par rapport à chaque candidat sélectionné et réorganise ces 30 passages.
Ce guide posait une question par paire pour plus de clarté. Une application réelle poserait plusieurs questions sur la même paire en un seul appel. Voir le recette de questions parallèles et le modèle de Fan-Out spéculatif pour savoir comment.
La suite
Les mêmes blocs de construction apparaissent ailleurs dans la documentation de TypeSafe :
- Noul, pour expliquer comment TypeSafe transforme une question par oui ou non en un score.
- Déclenchement spéculatif en cascade, pour poser plusieurs questions sur un même document en un seul appel.
- Recherche ligne par ligne, pour une autre façon de rechercher dans un corpus par le sens plutôt que par les mots-clés.