 JevCode
再ランキング
40件のCLERC法務クエリに対して30件パスのBM25候補を構築し、各クエリと候補のペアに対して1つのTypeSafe質問を用いることで、トップ1の精度を5%から18%へ、トップ10の精度を38%から62%へ向上させる。
本文はenからの機械翻訳です。校正は未実施で、参考情報としてのみご利用ください。

何千ものドキュメントがあり、特定の質問に答えるものを見つけたいとします。では、どうやって見つけますか?
まず、キーワードマッチングなどの簡易な手法を用いて、数千の候補を妥当な候補の短縮リストに絞り込みます。これを高速検索と呼びます。
高速検索はそこが得意だが、ショートリストにある候補のうちどれが正解なのかを判別することはできない。そこでの出番が再ランク付けだ。これはクエリに対してショートリスト内の各候補を直接スコアリングし、最も優れたものを上位に配置する。
両手順は、CLERCデータセットの3,565件の裁判所意見書断片に対して以下で実行される:BM25は各40件のクエリに対して30件の候補からなる高速検索の短縮リストを構築し、その後 TypeSafe が各短縮リストを再ランク付けする。再ランク付けにより、正解の断片が18%のクエリで1位となり、高速検索のみでは5%であったものが向上した。
その過程で、あなたは以下を学びます:
- ファストサーチが何をするのか、そしてそれが答えのすべてではない理由
- リランキングが何なのか、そしてファストサーチのステップの後にどのように適合するのか
- TypeSafe が1つの候補をクエリに対してどのようにスコアリングするか、そしてそれが結果をどの程度改善するのか
自分で試してみよう
TypeSafe Playgroundでクエリ、候補、再ランク付けの質問を開く
何千もの文書の中から1つの文書を見つけるのか
あなたは文書の山と、検索クエリを持っています。それはあなたが探しているものを説明するテキストです。その山の中には、それに応える唯一の文書がどこかにあります。
クエリに対して文書ごとに一つずつ照合していく方法は、文書ごとに1回の比較で機能しますが、数百万の文書がある場合、クエリごとに数百万回の比較が必要になります。パフォーマンスを向上させるには、2段階のアプローチを採用できます:
- 全体のデータセットに対して高速に実行可能な手法を用いて、候補を有望な候補者の短いリストに絞り込む。
- その短いリストに対してより高精度な処理を適用し、正確な正解を特定する。
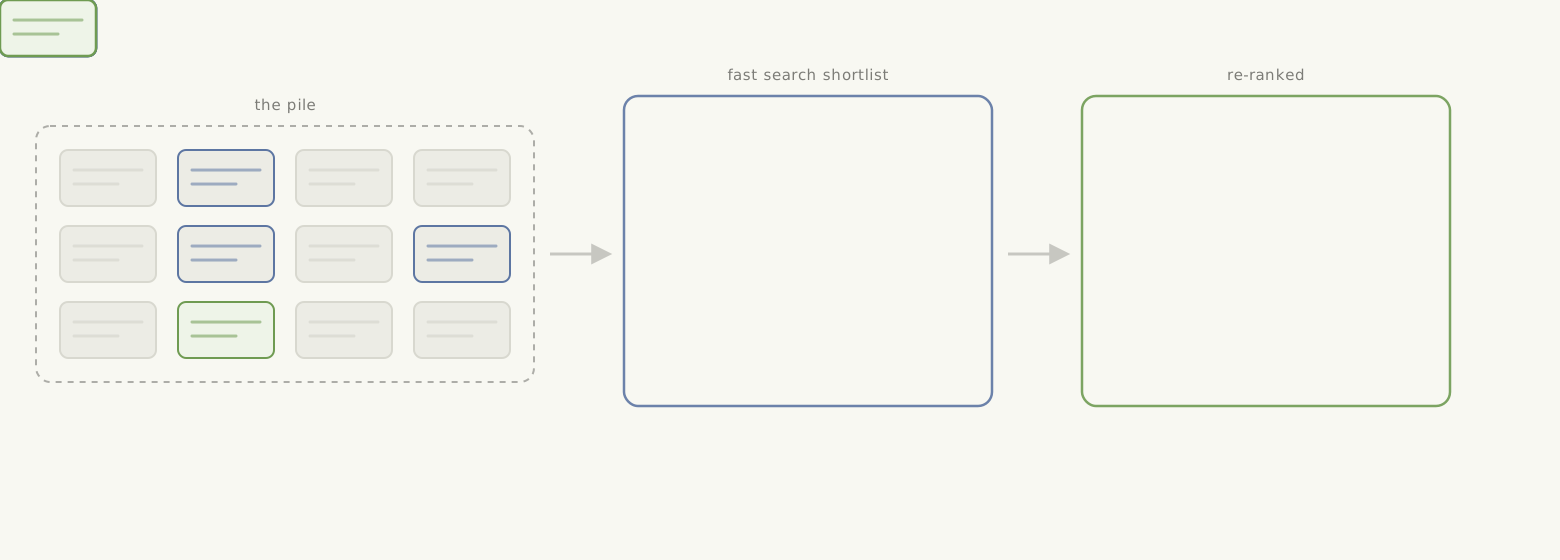
このクックブックは、裁判所の意見書のデータセットを用いて、以下の 実際の例での再ランク付け でその設定をテストします。
ファストサーチとは何ですか
高速検索とは、クエリを大規模なコーパス内のすべての文書と比較し、 迅速にランク付けされた候補リストを返すあらゆる手法を指す。一般的な手法には、 BM25などのキーワード検索や、意味によってパッセージを比較する ディープエンベディングがある。システムでは両方の手法を組み合わせることが多い。
ここでの最初のステップはBM25のみであり、それ以外は何もありません。BM25は共通の単語によってパッセージをランク付けします。 このステップをシンプルに保つことで、注目をリランキングに集中させることができます。これがこのクックブックの要点です。高速検索手法の選択は副次的な問題です。リランキングは、ショートリストに残ったパッセージのみを常に処理します。
リランキングとは何ですか?
Re-rankingは、すでに生成されたショートリストの高速検索をより良い順序に並べ替えます。 クエリを一度に全文書集合に対して比較するのではなく、ショートリスト上の各候補に対して 個別にクエリを比較し、そのスコアに基づいてショートリストをソートします。
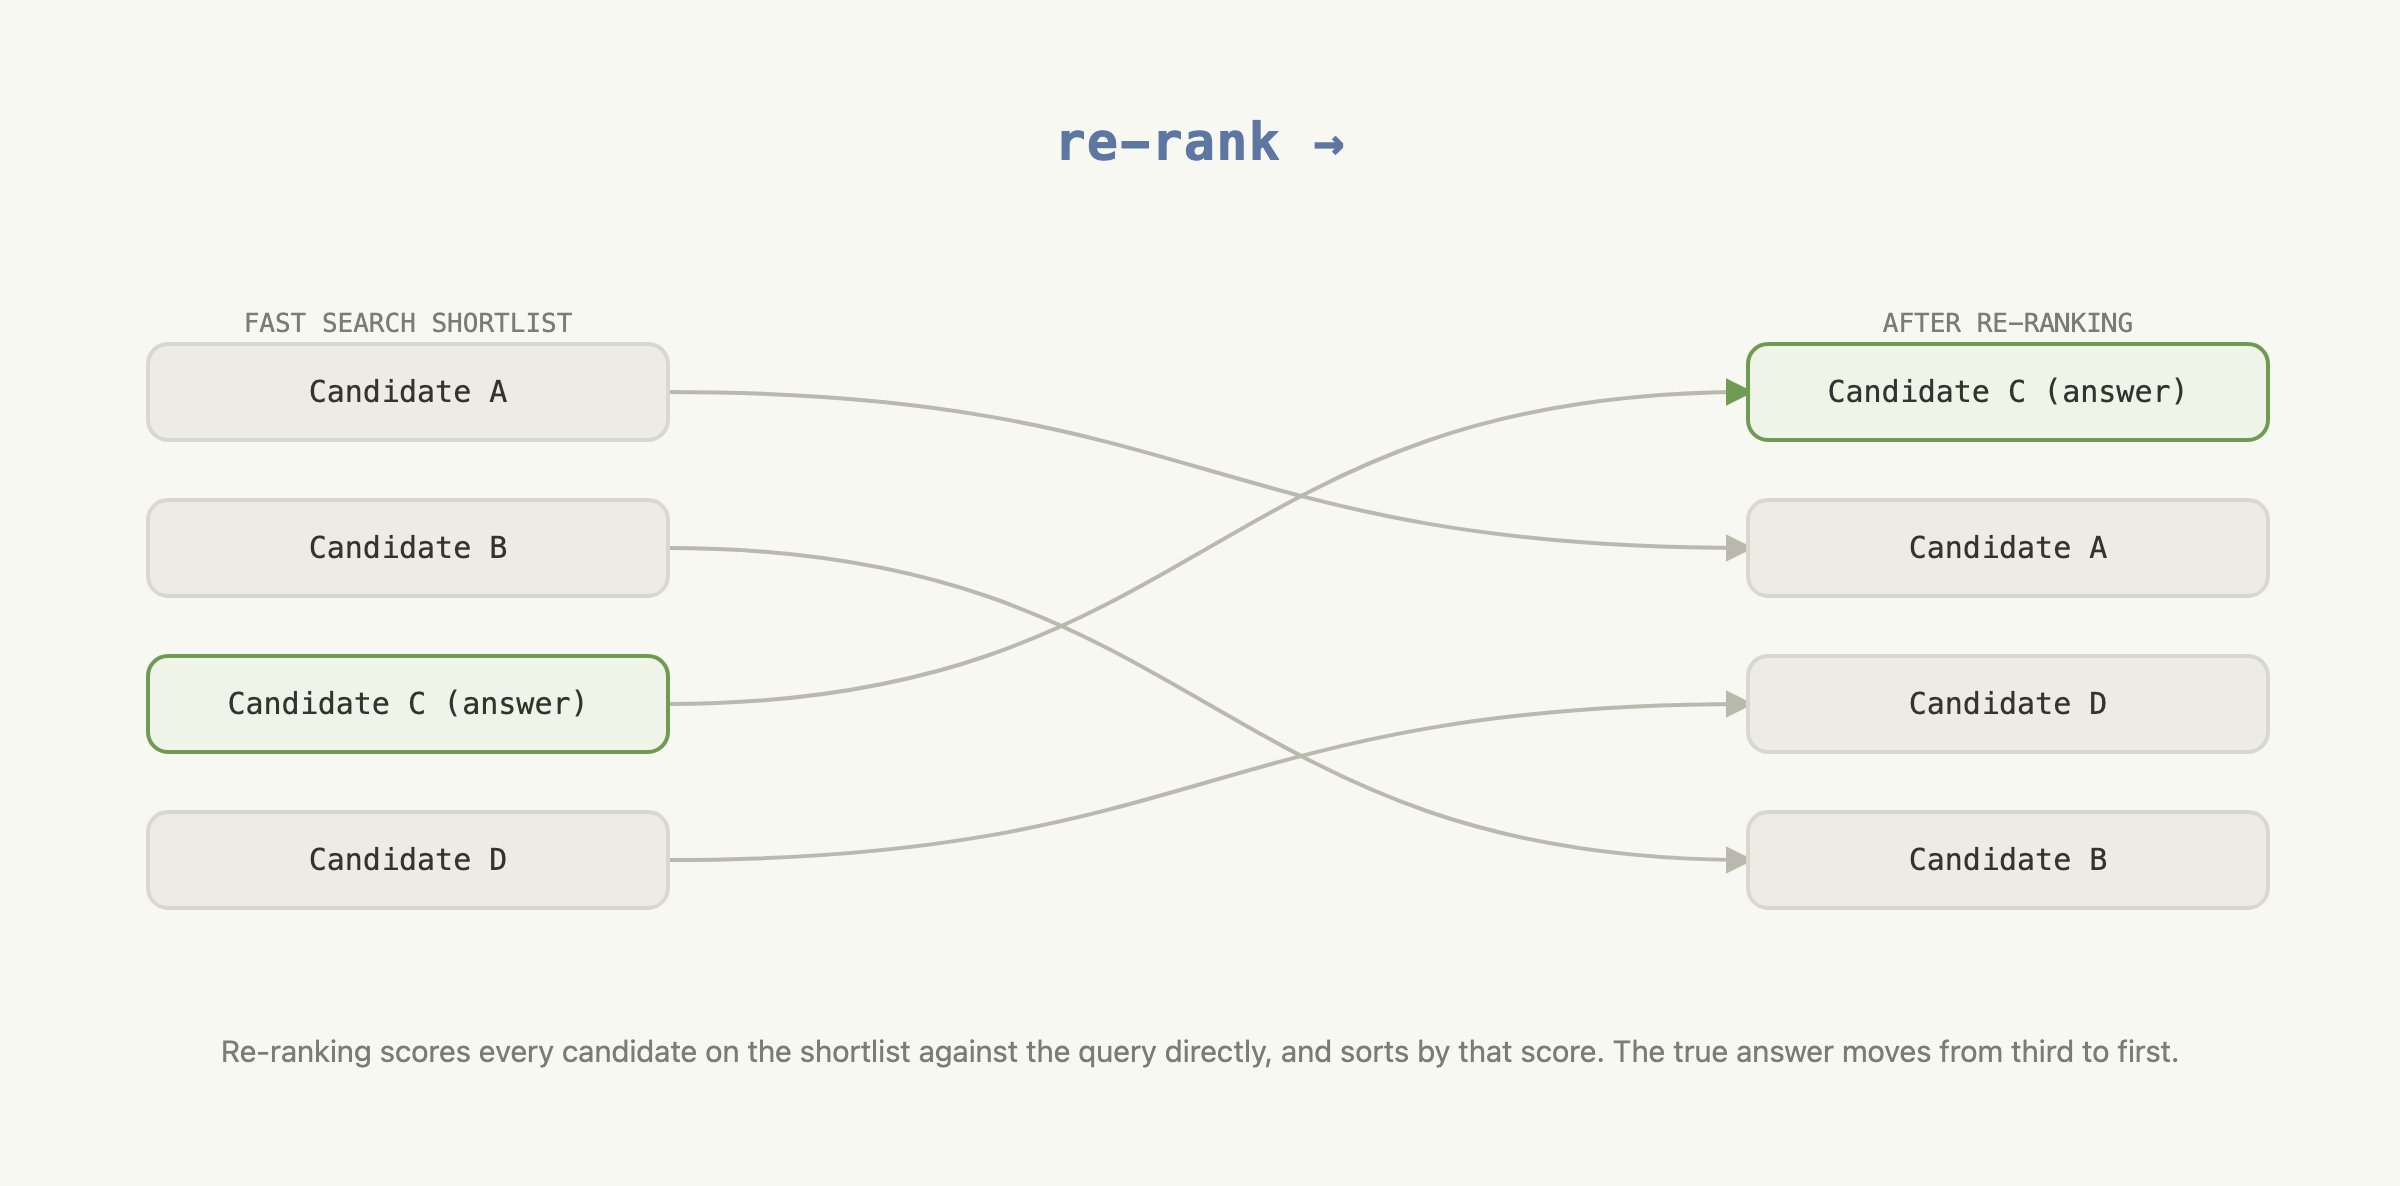
スコアは言語モデルから取得できます。クエリと1つの候補を同時に与え、その候補がクエリにどの程度答えているかを尋ねてください。再ランキングでは、候補の表現がクエリと異なっていても、ショートリスト内で最も適切な一致を見つけます。
TypeSafeによる再ランキング
A re-ranker needs a comparable score for every query-candidate pair. A general-purpose language model can produce these scores, or rank the whole shortlist directly. For independent pair scoring, however, you need to define a scoring scale and prompt the model to apply the same standard to every candidate. Repeated calls can still produce different scores for the same pair, while general-purpose generation adds time and cost to a task that only needs one number.
TypeSafeが返すもの
TypeSafeを使用すると、スコアリングリクエストはyes/noの質問のままにできます:
Could this candidate passage be from the cited precedent?30人の候補者を順位付けするには、単純な「はい」か「いいえ」では不十分です。代わりに、Noulは0から1の間の数値を返します。これはnoulと呼ばれます。noulは、回答が「はい」である可能性をTypeSafeが推定した値です。
質問の基準は、真と偽の定義を決定する。TypeSafe はこれらをすべてのクエリ候補ペアに適用し、noul を直接返す。この noul が、アプリケーションがソート対象とするスコアである。汎用モデルに対してスコアリング尺度を新たに考案する必要はなく、TypeSafe はこの繰り返しスコアリングをより高速、低コスト、かつ一貫性を持って実行するために構築されている。
簡易な擬似コードでは、1つのTypeSafeスコアリング呼び出しは以下のようになります:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafeは、その質問に対してクエリと1つの候補を一緒に読み取り、noulを返します。
これを使って、候補リストの各候補に対して同じ質問を実行し、各呼び出しで返ってくる noul でソートすることで、候補リストを再ランク付けできます。最も高い noul が先頭に来るようにします。
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
以下の図は、各候補ごとに1リクエストを送信することで、短縮リストの再順序付けに使用されるスコアがどのように生成されるかを示しています。
フロー方向:LR
| ノード | 説明 | グループ |
|---|---|---|
q |
検索断片 / 意見の断片1つ / 引用除去 | — |
sl |
高速検索からの候補リスト / 30件の候補断片 | — |
quest |
1つのNoul / この候補は / 引用された先例からか? / 基準の真偽修正 | — |
fan |
候補ごとに1つのリクエスト · 各リクエストは他を見ない | 候補ごとに1つのリクエスト · 各リクエストは他を見ない |
sort |
Noulでソート / 最高値が先 | — |
out |
再ランク付けされた候補リスト / 同じ30件、より良い順序 | — |
| 元 | 条件 | 先 |
|---|---|---|
q |
— | fan |
sl |
— | fan |
quest |
— | fan |
fan |
— | sort |
A re-ranking example
高速検索と再ランク付けは現在、 CLERCという法的検索データセット上で実行されています。 この例では、3,565件の裁判所意見の断片と40件のクエリを使用しています。
セットアップ
このステップでは、このチュートリアルで依存するパッケージをインストールします。
bm25sとdatasetsは高速検索の候補リストを構築します。typesafe-sdkとcooksafeは再ランク付けと API キャッシュの処理を担当します。matplotlibは結果のチャートを描画します。
pip install bm25s datasets matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/次のブロックでは、TypeSafe クライアントの設定と、以降のウォークスルーで使用する定数(呼び出す TypeSafe モデルや、高速検索が再ランクラーに渡すショートリストのサイズなど)を定義します。TypeSafe を呼び出すには TYPESAFE_API_KEY が必要です。
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import msgspec
from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
高速検索によるパスウェイのランク付け
ここで使用されているデータセットは、米国の裁判所判決のコーパスであり、170件の行が統合されています。各行は以下のように構成されています。
- クエリ: 引用が削除された意見の抜粋。
- ゴールド: 引用が指し示していた段落、すなわちクエリに対する唯一の正解。
- 候補: コーパス内の他のすべての段落。これらは、誤ってクエリとマッチングされる可能性があるもの。
170行のうち、40行がクエリとして評価するために選択される。残りの130行は候補としてのみ登場する。
次のセルは、上記で説明した手法を用いてショートリストを構築します:
- コーパスを読み込む。
- 各クエリに対してBM25でランク付けする。
まだ TypeSafe はないよ、これは高速検索フェーズだけだ。
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)


def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]


@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}


def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}


def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None


SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"


def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)


ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)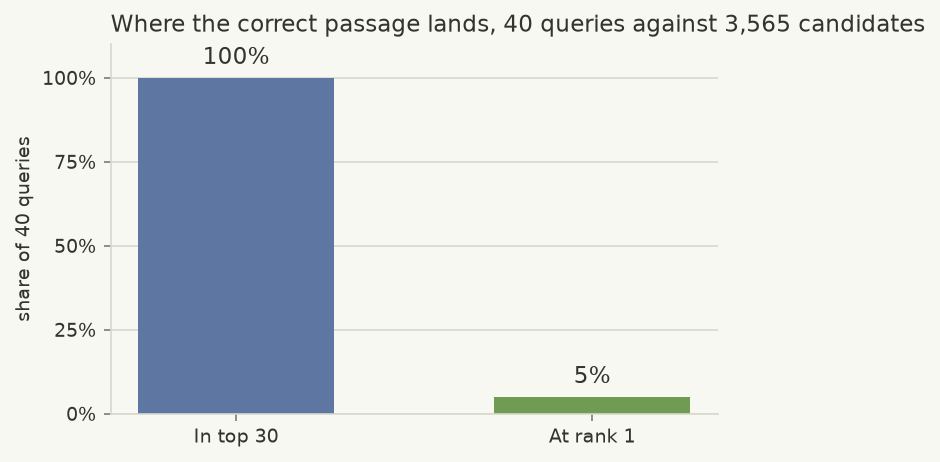
高速検索では、適切な記述が最初にランクインする可能性は低い
チャートは、3,565件の候補の中から、高速検索が正しい回答をどこに配置するかを示しています。
高速検索により、正解を含む候補リストへ確実に絞り込まれる。 40件のクエリすべてで正解が含まれる。しかし、その記述は候補リストで最上位に来ることは稀で、5%のケースにとどまる。
以下の再ランク付けは、すでにショートリストに含まれている上位30候補の順序のみを並べ替えます。高速検索が選択しなかったパッセージを追加することはできません。ここでは、ショートリストには40件すべてのクエリに対して正しいパッセージが含まれているため、再ランク付けは各パッセージをより良い位置に配置することに集中できます。
TypeSafe による再ランク付け
ショートリスト上の各候補について、クエリに対して再ランク付けスコアを算出し、そのスコアでソートする。TypeSafeが各ペアについて問うのは、その候補がクエリが参照している削除された引用の原文であるかどうかだ。
次のセルは以下の処理を行います:
- その質問を定義する。
- ショートリストの各候補に対して1回ずつ質問し、40クエリ×30候補で合計1,200回の呼び出しを行う。逐次ではなく並行して実行する。
- TypeSafeが返すスコアに基づいて各ショートリストをソートし、再ランク付けされた結果を生成する。
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)


@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = msgspec.json.encode(is_cited_source).decode()
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}


def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)


chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.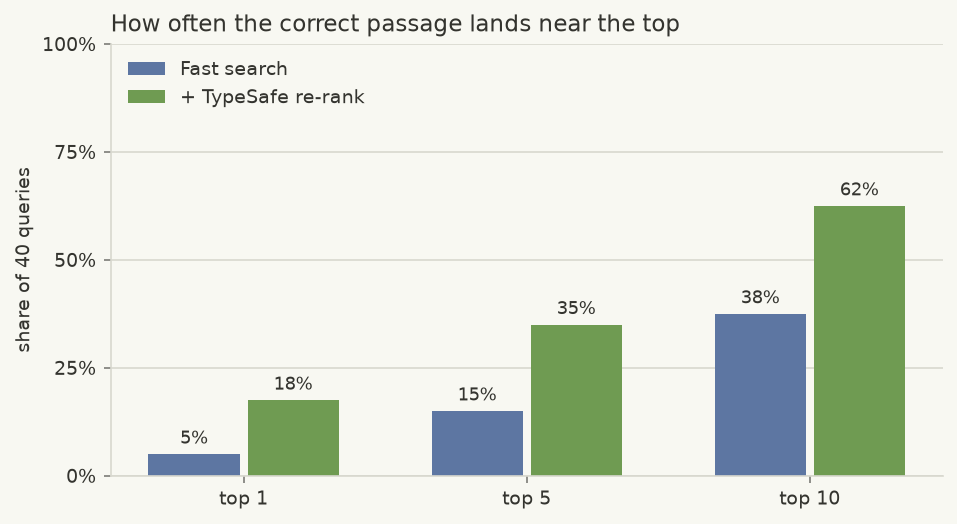
再ランキングは正解を上位に移動させる
チャートは、高速検索と高速検索+再ランク付けを、3つの閾値で比較しています。 再ランク付けは、それらのすべてにおいて、正しいパッセージをより上位に移動させます:
- Top 1 — 5% → 18%
- Top 5 — 15% → 35%
- Top 10 — 38% → 62%
報告されたトークン数とコストは、40のショートリストを再ランク付けするために使用された1,200回のTypeSafe呼び出しすべてをカバーしています。
各CLERC行には、1つの正解パッセージと20のネガティブパッセージが含まれています。このウォークスルーでは、170行のパッセージをプールして1つの共有コーパスにまとめます。各40の評価クエリについて、BM25は、その行に付随する20のネガティブのみならず、その完全なコーパス全体から30の候補を選択します。その後、TypeSafeが各選択された候補に対してクエリを読み込み、それら30のパッセージを再ランク付けします。
このウォークスルーでは、明確さのためにペアごとに1つの質問を行いました。実際のアプリケーションでは、1回の呼び出しで同じペアに関する複数の質問を行います。方法は、並列質問のcookbookおよびSpeculative Fan-Outパターンをご覧ください。
次のステップ
同じビルディングブロックは、TypeSafe のドキュメントの他の場所でも見られます:
- Noulは、TypeSafeがはい/いいえの質問をスコアに変換する方法を示します。
- Speculative Fan-Outは、1つの呼び出しで1つのドキュメントについて複数の質問を行う方法です。
- Line-by-line Searchは、キーワードではなく意味に基づいてコーパスを検索する別の方法です。