 JevCode
Re-ranking
Gera listas curtas de 30 passagens BM25 para 40 consultas jurídicas do CLERC, em seguida utiliza uma pergunta TypeSafe por par consulta-candidato para elevar a precisão do top-1 de 5% para 18% e a precisão do top-10 de 38% para 62%.
Traduzido automaticamente do en, sem revisão. Apenas como referência rápida.

Você tem milhares de documentos e precisa encontrar aquele que responde a uma pergunta específica. Então, como você o encontra?
Primeiro, use um método rápido, como correspondência de palavras-chave, para reduzir esses milhares de candidatos a uma lista curta de candidatos plausíveis. Chamamos isso de busca rápida.
A busca rápida é boa nisso, mas não consegue indicar qual candidato da lista final está correto. É aí que entra o re-ranking. Ele pontua cada candidato da lista final diretamente em relação à consulta e coloca o melhor em primeiro lugar.
Ambas as etapas são executadas abaixo em 3.565 passagens de decisões judiciais do conjunto de dados CLERC: o BM25 constrói uma lista rápida de 30 candidatos para cada uma das 40 consultas, e então o TypeSafe reclassifica cada lista. Com a reclassificação, a passagem correta aparece em primeiro lugar em 18% das consultas, um aumento em relação aos 5% obtidos apenas com a busca rápida.
Ao longo do caminho, você vai aprender:
- O que a busca rápida faz, e por que não é a resposta completa
- O que é o re-ranking, e como ele se encaixa após uma etapa de busca rápida
- Como o TypeSafe pontua um candidato em relação a uma consulta, e quanto isso melhora o resultado
Experimente você mesmo
Abra uma consulta, candidato e pergunta de reclassificação no TypeSafe Playground
Como encontramos um documento entre milhares?
Você tem uma pilha de documentos e uma consulta, um trecho de texto descrevendo o que você está procurando. Em algum lugar da pilha está o único documento que responde a ela.
Verificar cada documento contra a consulta um de cada vez funciona, com uma comparação por documento: milhões de documentos significam milhões de comparações por consulta. Você pode melhorar o desempenho com uma abordagem em duas etapas:
- Reduza a pilha a uma lista curta de candidatos prováveis, usando um método rápido o suficiente para ser executado em toda a pilha.
- Aplique uma etapa mais precisa a essa lista curta, para encontrar a resposta exata correta.
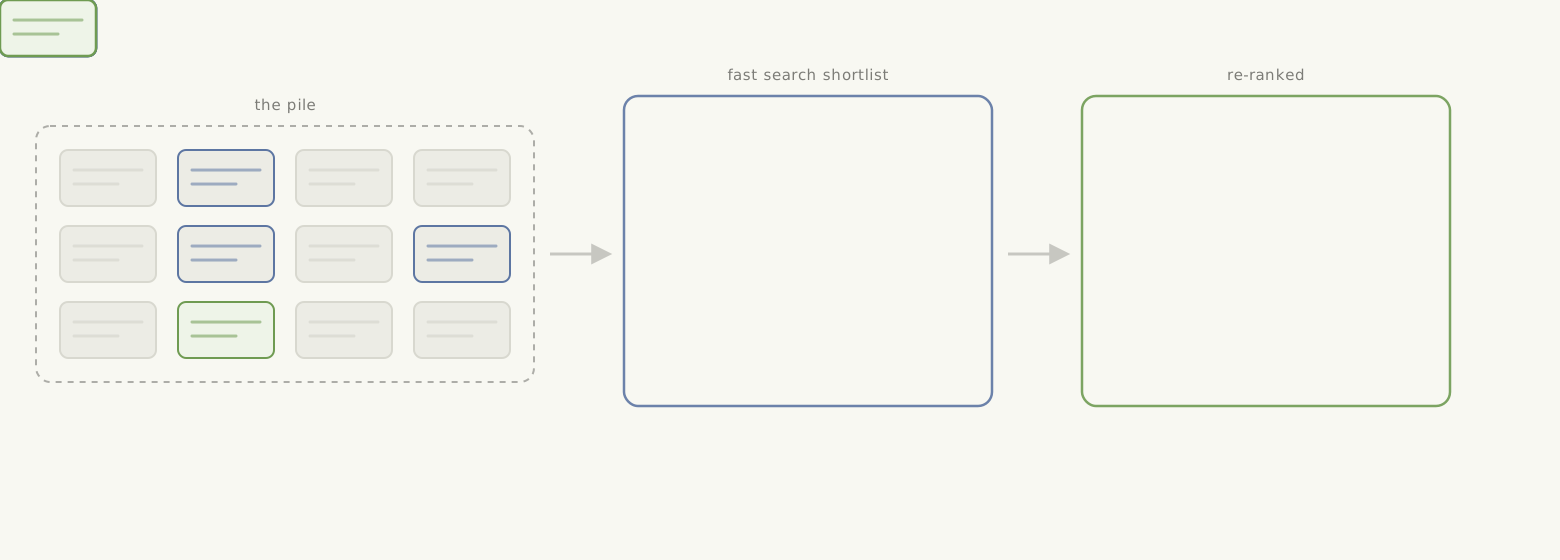
Este cookbook testa essa configuração em um conjunto de dados de decisões judiciais, em Re-ranking em um exemplo real abaixo.
O que é a busca rápida?
A busca rápida é qualquer método que possa comparar uma consulta contra todos os documentos em um grande corpus e retornar rapidamente uma lista curta classificada. Os métodos comuns incluem busca por palavras-chave, como BM25, e embeddings densos, que comparam trechos por significado. Os sistemas frequentemente combinam ambos os métodos.
O primeiro passo aqui é o BM25 e nada mais. O BM25 classifica os trechos com base nas palavras compartilhadas. Manter essa etapa simples mantém o foco no reclassificamento, que é o objetivo do cookbook. A escolha do método de busca rápida é uma questão secundária: o reclassificamento só vê os trechos que compõem a lista curta.
O que é reclassificação?
O re-ranking pega a lista rápida de busca já produzida e a organiza em uma ordem melhor. Em vez de comparar a consulta com todo o corpus de uma vez, ele compara a consulta com cada candidato na lista individualmente, e ordena a lista por essa pontuação.
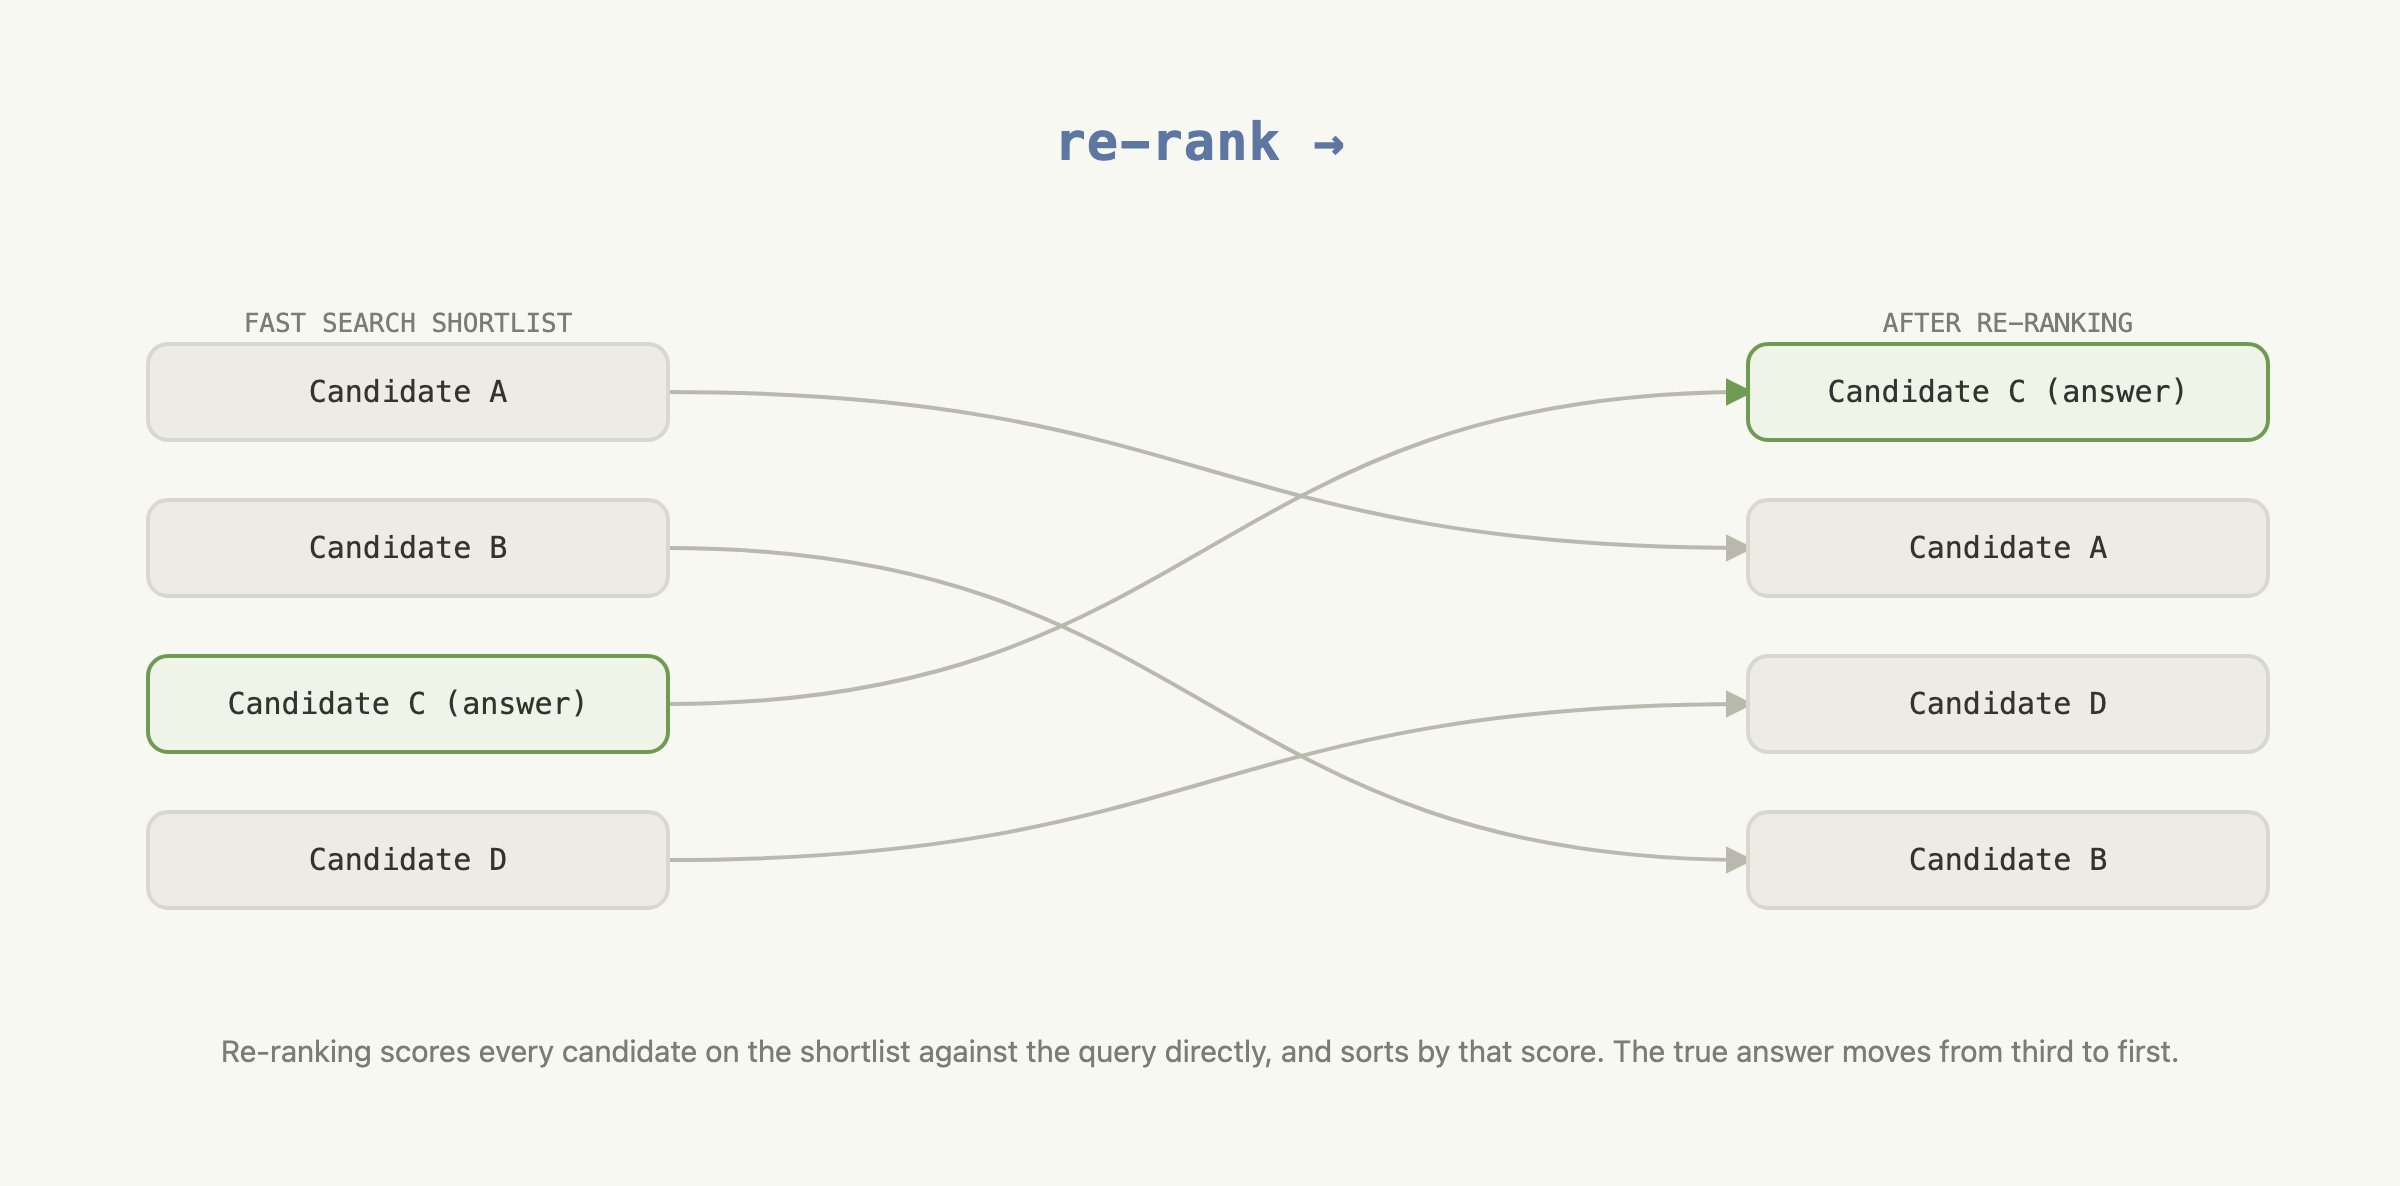
A pontuação pode vir de um modelo de linguagem. Forneça a consulta e um candidato juntos e pergunte o quão bem o candidato responde à consulta. O re-ranking então encontra a melhor correspondência na lista curta mesmo quando sua redação difere da da consulta.
Re-ranking com TypeSafe
Um re-ranker precisa de uma pontuação comparável para cada par consulta-candidato. Um modelo de linguagem de propósito geral pode produzir essas pontuações, ou classificar a lista curta inteira diretamente. Para a pontuação independente de pares, no entanto, você precisa definir uma escala de pontuação e solicitar ao modelo que aplique o mesmo padrão a cada candidato. Chamadas repetidas ainda podem produzir pontuações diferentes para o mesmo par, enquanto a geração de propósito geral adiciona tempo e custo a uma tarefa que só precisa de um número.
O que o TypeSafe retorna
Com o TypeSafe, a solicitação de pontuação pode permanecer como uma pergunta sim/não:
Could this candidate passage be from the cited precedent?Um simples sim ou não não seria suficiente para classificar 30 candidatos. Um Noul retorna um número entre 0 e 1, chamado de
noul. O noul é a estimativa da TypeSafe
de quão provável é que a resposta seja sim.
Os critérios da questão definem o que conta como verdadeiro e falso. O TypeSafe os aplica a cada par consulta-candidato e retorna o noul diretamente. Esse noul é a pontuação na qual o aplicativo ordena. Não é necessário inventar uma escala de pontuação para um modelo de propósito geral, e o TypeSafe foi construído para fazer essa pontuação repetida mais rápido, com menor custo e de forma mais consistente.
Em pseudocódigo simplificado, uma chamada de pontuação TypeSafe se parece com isto:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
O TypeSafe lê a consulta e um candidato juntos em relação àquela pergunta, e retorna um noul.
Você pode usar isso para reclassificar uma lista curta executando a mesma pergunta contra cada candidato nela, em seguida, classificando a lista curta pelo noul que cada chamada retorna, do mais alto para o mais baixo.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
O diagrama abaixo mostra como uma solicitação por candidato gera as pontuações usadas para reordenar a lista reduzida.
Direção do fluxo: ES-D
| Nó | Descrição | Grupo |
|---|---|---|
q |
excerto da consulta / um trecho de opinião, / citação removida | — |
sl |
lista curta da busca rápida / 30 trechos candidatos | — |
quest |
um Noul / este candidato poderia ser / do precedente citado? / correção de critérios verdadeiro e falso | — |
fan |
uma solicitação por candidato · nenhuma solicitação vê outra | uma solicitação por candidato · nenhuma solicitação vê outra |
sort |
classificar por Noul, / primeiro os mais altos | — |
out |
lista curta reclassificada / mesmos 30, melhor ordem | — |
| De | Condição | Para |
|---|---|---|
q |
— | fan |
sl |
— | fan |
quest |
— | fan |
fan |
— | sort |
Um exemplo de reclassificação
A busca rápida e o re-ranking agora são executados no CLERC, um conjunto de dados de recuperação jurídica. Este exemplo utiliza 3.565 trechos de decisões judiciais e 40 consultas.
Configuração
O primeiro passo instala os pacotes dos quais este tutorial depende.
bm25sedatasetsconstroem a lista curta de pesquisa rápida.typesafe-sdkecooksafetratam do reclassificamento e do cache da API.matplotlibgera os gráficos de resultados.
pip install bm25s datasets matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/O próximo bloco configura o cliente TypeSafe e as constantes que o restante do walkthrough
usa, como qual modelo TypeSafe chamar e quão grande uma lista curta de busca rápida é entregue ao
re-ranker. Chamar o TypeSafe requer um TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import msgspec
from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Classificando os trechos com busca rápida
O conjunto de dados utilizado aqui é um corpus de decisões judiciais dos EUA, com 170 linhas agrupadas. Cada linha é decomposta da seguinte forma:
- Consulta: um excerto de opinião com uma citação removida.
- Ouro: o trecho para o qual a citação removida apontava, a única resposta correta para a consulta.
- Candidatos: todos os outros trechos no corpus, cada um algo com o qual a consulta poderia ser correspondida por engano.
Dos 170 registros, 40 são selecionados para serem avaliados como consultas. Os outros 130 apenas aparecem como candidatos.
O próximo bloco de código constrói a lista reduzida, utilizando a técnica descrita acima:
- Carregue o corpus.
- Classifique-o contra cada consulta com BM25.
Ainda não há TypeSafe aqui, este é apenas o passo de pesquisa rápida.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)


def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]


@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}


def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}


def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None


SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"


def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)


ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)
A busca rápida provavelmente não classificará a passagem correta em primeiro lugar
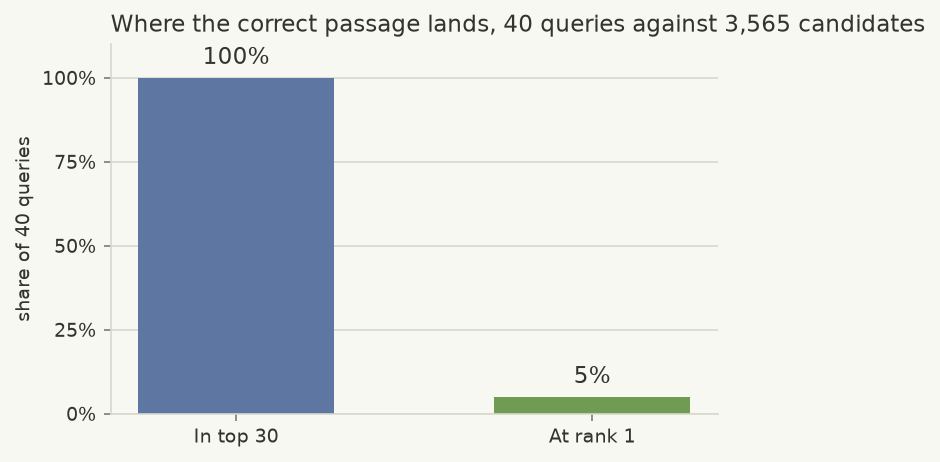
O gráfico mostra onde a busca rápida posiciona o trecho correto, entre 3.565 candidatos.
A busca rápida reduz com segurança o corpus a uma lista curta que contém a resposta correta. Ela contém a resposta correta para 100% das 40 consultas. Mas esse trecho raramente é o classificado em primeiro lugar na lista curta, apenas 5% das vezes.
O re-ranking abaixo apenas reordena os 30 candidatos que já estavam na lista curta. Ele não pode adicionar um trecho que a busca rápida não tenha selecionado. Aqui, a lista curta contém o trecho correto para todas as 40 consultas, portanto, o re-ranking pode focar em colocar cada um em uma posição melhor.
Reordenando com TypeSafe
Reavaliação das pontuações de cada candidato na lista reduzida em relação à sua consulta, classificando-os então por essa pontuação. A pergunta que o TypeSafe faz sobre cada par é se o candidato poderia ser o trecho ao qual a citação removida da consulta se refere.
O próximo bloco de código faz o seguinte:
- Defina essa pergunta.
- Faça-a uma vez por candidato em cada lista reduzida, 40 consultas vezes 30 candidatos, 1.200 chamadas no total, executadas em paralelo em vez de uma após a outra.
- Ordene cada lista reduzida pela pontuação que o TypeSafe retorna, produzindo o resultado reclassificado.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)


@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = msgspec.json.encode(is_cited_source).decode()
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}


def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)


chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.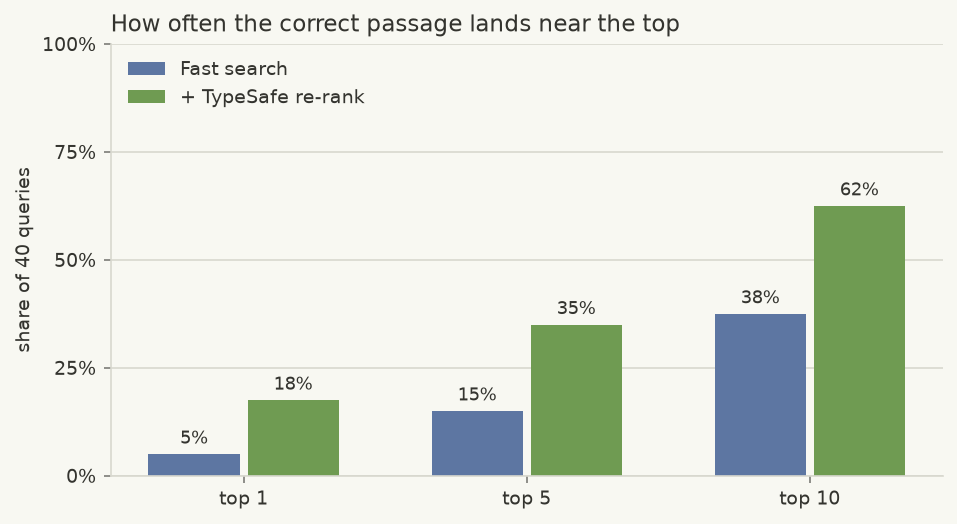
Re-ranking move a resposta correta para o topo
O gráfico compara a busca rápida com a busca rápida mais reclassificação, em três limiares. A reclassificação aproxima o trecho correto do topo em todos eles:
- Top 1 — 5% → 18%
- Top 5 — 15% → 35%
- Top 10 — 38% → 62%
A contagem de tokens e o custo relatados cobrem todas as 1.200 chamadas TypeSafe usadas para reclassificar as 40
Cada linha do CLERC contém um trecho correto e 20 trechos negativos. Este roteiro agrupa os trechos de 170 linhas em um único corpus compartilhado. Para cada uma das 40 consultas de avaliação, o BM25 seleciona 30 candidatos desse corpus completo, não apenas os 20 trechos negativos fornecidos com aquela linha. O TypeSafe então lê a consulta contra cada candidato selecionado e reclassifica esses 30 trechos.
Este roteiro fez uma pergunta por par para maior clareza. Um aplicativo real faria várias perguntas sobre o mesmo par em uma única chamada. Consulte o cookbook de perguntas paralelas e o Padrão Speculative Fan-Out para saber como.
O que vem a seguir
Os mesmos blocos de construção aparecem em outras partes da documentação da TypeSafe:
- Noul, para explicar como o TypeSafe transforma uma pergunta de sim/não em uma pontuação.
- Fan-Out Especulativo, para fazer várias perguntas sobre um único documento em uma única chamada.
- Pesquisa Linha a Linha, para outra maneira de pesquisar um corpus por significado em vez de palavras-chave.