 JevCode
alinhamento de entidades de grafos de conhecimento
Decide qual dos 450 pares candidatos de dois catálogos de cerveja descreve o mesmo produto. Uma pergunta do TypeSafe Score carrega toda a decisão, pois seus três níveis correspondem às três ações possíveis com um par: mesclá-lo, deixá-lo sem vínculo ou encaminhá-lo a um curador. Não há limiar a ser ajustado, um
Traduzido automaticamente do en, sem revisão. Apenas como referência rápida.

Um problema fundamental nos grafos de conhecimento é decidir se uma entidade que chega duplica uma existente, especialmente quando o que se tem à disposição é linguagem natural proveniente de fontes distintas. Dadas possíveis pares de duplicatas, um único TypeSafe Score decide se cada par é uma duplicata ou se merece uma análise mais detalhada por parte de um curador.
Suponha que duas fontes de dados descrevam conjuntos sobrepostos das mesmas coisas, e você precise saber qual entrada de um lado é a mesma coisa que qual entrada do outro. Um grafo de conhecimento chama essas entradas entidades, e mantém os fatos registrados sobre cada uma. Uma primeira passagem barata, mas grosseira, já comparou as duas fontes e selecionou 450 pares que valem a pena uma análise mais detalhada. O que resta é fazer uma avaliação crítica de cada par.
Mesclar duas entidades de forma inadequada é o erro mais custoso, já que cada fato sobre qualquer uma das entidades agora descreve a mesclada, e qualquer coisa vinculada a uma delas vem junto também. Desfazer isso depois significa descobrir de onde veio cada fato. Perder um par só deixa um duplicado, então a decisão exige uma terceira opção: pares que não são seguros para mesclar nem seguros para descartar.
O julgamento é uma questão Score com um nível para cada um dos três resultados:
- produto diferente — deixe as duas entidades desvinculadas
- relacionado, mas possivelmente não o mesmo — entregue a um curador para decidir
- mesmo produto — una-os
Usamos uma pergunta Score porque queremos anexar um rótulo semântico, os critérios de pontuação, diretamente a cada resultado, incluindo o resultado do meio. Uma pergunta Noul poderia realizar isso indiretamente por meio de limiarização em sua saída, e uma pergunta Choice perderia a relação ordenada dos três resultados.
Em seguida, para cada campo da entidade que queremos considerar, Noul perguntas sobre se
esses
campos correspondem podem acompanhar na mesma solicitação. Esses noul fornecem informações mais detalhadas
para o curador, se a pontuação não estiver nos níveis de “mesmo produto” nem
“diferente produto”.
Você acaba com um route() que recebe um par de candidatos e retorna um dos três resultados, sem nenhum limiar que você precisou ajustar aos seus próprios dados.
Direção do fluxo: ES-D
| Nó | Descrição | Grupo |
|---|---|---|
CALL |
um pedido, quatro perguntas | um pedido, quatro perguntas |
S |
Score: como se relacionam? / · produto diferente / · relacionados, mas possivelmente não o mesmo / · mesmo produto | um pedido, quatro perguntas |
N |
Nouls: um por campo comparado / · mesmo nome? / · mesma cervejaria? / · mesmo estilo? | um pedido, quatro perguntas |
| De | Condição | Para |
|---|---|---|
S |
— | N |
S |
— | R |
R |
diferente | DROP |
R |
igual | M |
R |
relacionado | Q |
Configuração
pip install matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/então defina TYPESAFE_API_KEY. Cada chamada é armazenada em cache no json_cache.json, que vem incluído
no cookbook, então re-renderizar reproduz os números publicados sem chamar a API. Exclua
esse arquivo para executar tudo novamente ao vivo.
Os números abaixo vieram de jev-1.12 em 2026-08-11.
import json
import os
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Noul, Score, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
MAX_WORKERS = 6  # small pool; the public endpoint rate-limits above roughly eight

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Carregue os pares candidatos
Os pares vêm de um conjunto de benchmark publicado, os dados Beer da coleção Magellan:
dois catálogos de cerveja raspados de sites diferentes, já reduzidos a 450 pares por aquela
primeira passagem grosseira. Cada entidade possui quatro campos: nome, cervejaria, estilo e teor
alcoólico. Cada par também carrega known_same_as, a resposta do próprio benchmark.
O texto é mantido exatamente como foi publicado, sem pré-processamento: entidades HTML que nunca foram convertidas de volta para caracteres, apóstrofes separados como palavras distintas, alguns caracteres decodificados incorretamente.
Uma solicitação é enviada por par, então o que você gasta segue o número de pares que foram passados para você, em vez do tamanho de qualquer uma das fontes.
PAIRS = json.loads(Path("candidate_pairs.json").read_text(encoding="utf-8"))
BY_ID = {pair["id"]: pair for pair in PAIRS}

print(f"{len(PAIRS)} candidate pairs. The first one, as the model will see it:")
print(json.dumps({k: PAIRS[0][k] for k in ("entity_a", "entity_b")}, indent=2)[:420])
450 candidate pairs. The first one, as the model will see it:
{
"entity_a": {
"name": "C N Red Imperial Red Ale",
"brewery": "Redwood Lodge",
"style": "American Amber / Red Ale",
"abv": "8.10 %"
},
"entity_b": {
"name": "Kinetic Infrared Imperial Red Ale",
"brewery": "Kinetic Brewing Company",
"style": "American Strong Ale",
"abv": "9.30 %"
}
}Faça uma pergunta Score e três perguntas Noul por par de candidatos
Ambas as entidades vão para um único estado, como entity_a e entity_b, então as perguntas são sobre o par e não sobre qualquer um dos lados por conta própria. Todos os quatro viajam em uma única solicitação.
As três descrições de nível abaixo constituem a decisão inteira: cada nível é um resultado. Não há constante de limiar em qualquer lugar deste arquivo. Você também pode escrever essas descrições antes de ter visto qualquer pontuação, o que não é verdade para um número que você precisa ajustar.
O nível intermediário é o que vale a pena escrever com cuidado. Aqui ele abrange variantes, edições especiais e nomes que podem razoavelmente referir-se a qualquer um dos produtos, para que esses alcancem um curador em vez de serem fundidos ou descartados.
OUTCOME nomeia os três resultados. O resultado da fusão é chamado assert sameAs porque
sameAs é a maneira padrão de registrar que duas entidades são a mesma coisa, e escrever
uma é como a fusão realmente acontece.
Três dos quatro campos recebem uma pergunta Noul: nome, cervejaria e estilo. O teor alcoólico
não recebe nenhuma, porque comparar dois números é aritmética; calcule-o no código se quiser.
Para usar isso em outro tipo de dados, você reescreve QUESTIONS e LEVELS. O único outro
código que conhece sobre cerveja são as duas funções que imprimem os resultados, que nomeiam os campos.
LEVELS = [
    "They describe two different products.",
    "They describe closely related products that may or may not be the same one: "
    "a variant, a special edition, or a name that could plausibly refer to either.",
    "They describe one and the same product.",
]
OUTCOME = {0: "leave unlinked", 1: "curator queue", 2: "assert sameAs"}

QUESTIONS = {
    "link_state": Score(
        instructions="How do the two entity descriptions relate as products?",
        criteria=LEVELS,
    ),
    "same_name": Noul(
        instructions="Do the two entities state the same beer name?",
    ),
    "same_brewery": Noul(
        instructions="Are the two entities from the same brewery?",
    ),
    "same_style": Noul(
        instructions="Do the two entities describe the same beer style?",
    ),
}


@json_cache
def score(pair_id: str) -> dict:
    """One request about one candidate pair -> the score plus the three noul answers."""
    pair = BY_ID[pair_id]
    response = client.system_one(
        state={"entity_a": pair["entity_a"], "entity_b": pair["entity_b"]},
        questions=QUESTIONS,
        model=TYPESAFE_MODEL,
    )
    link = response.answers["link_state"]
    return {
        "score": link.score,
        "probabilities": link.probabilities,
        "confidence": link.confidence,
        "properties": {
            k: response.answers[k].noul for k in QUESTIONS if k != "link_state"
        },
        # tokens and requests are the durable units; don't cache a derived cost
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


def route(score_value: float) -> str:
    """The whole decision rule: the nearest level names the outcome."""
    return OUTCOME[min(int(score_value + 0.5), len(LEVELS) - 1)]


def show(pair_id: str) -> None:
    pair, result = BY_ID[pair_id], score(pair_id)
    print(
        f"{pair_id}  score {result['score']:.2f}  confidence {result['confidence']:.2f}"
        f"  ->  {route(result['score'])}"
    )
    for side in ("entity_a", "entity_b"):
        e = pair[side]
        print(f"    {e['name'][:44]:<46}{e['brewery'][:30]:<32}{e['style'][:22]}")
    nouls = result["properties"]
    print(
        f"    name {nouls['same_name']:.2f}   brewery {nouls['same_brewery']:.2f}   "
        f"style {nouls['same_style']:.2f}"
    )
Quatro pares. c446 é um produto e c427 são dois. Os outros dois ficam no nível intermediário por motivos diferentes: c100 tem o mesmo nome e cervejaria, mas as fontes descrevem seu estilo de maneira diferente, enquanto c428 emparelha uma cerveja com uma variante dela à base de frutas e lúpulo.
for pair_id in ("c446", "c427", "c100", "c428"):
    show(pair_id)
    print()
c446 score 1.94 confidence 0.92 -> assert sameAs
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company American Barleywine
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company Barley Wine
name 0.97 brewery 0.99 style 0.81
c427 score 0.03 confidence 0.95 -> leave unlinked
Frost Quake Bourbon Barrel Aged Barley Wine Wellington County Brewery American Barleywine
Lompoc Bourbon Barrel Aged Proletariat Red A Lompoc Brewing Amber Ale
name 0.02 brewery 0.09 style 0.08
c100 score 1.30 confidence 0.27 -> curator queue
Belle Gueule Rousse Brasseurs R.J. American Amber / Red A
Belle Gueule Rousse Brasseurs RJ Amber Lager/Vienna
name 0.95 brewery 0.94 style 0.35
c428 score 1.10 confidence 0.77 -> curator queue
Ambleside Amber Ale Bridge Brewing Company American Amber / Red A
Bridge Ambleside Amber Ale - Pomegranate & G Bridge Brewing Company Amber Ale
name 0.63 brewery 0.98 style 0.74Encaminhe cada par de candidatos
# 450 candidate pairs, one request each; a small pool keeps a live run to a few minutes.
with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
    scored = list(pool.map(lambda pair: score(pair["id"]), PAIRS))

scores = [result["score"] for result in scored]
by_outcome: dict[str, list[str]] = {name: [] for name in OUTCOME.values()}
for pair, s in zip(PAIRS, scores):
    by_outcome[route(s)].append(pair["id"])

SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

BINS, TOP = 20, len(LEVELS) - 1
counts = [0] * BINS
for s in scores:
    counts[min(int(s / TOP * BINS), BINS - 1)] += 1
centers = [(i + 0.5) / BINS * TOP for i in range(BINS)]
queued = [c if route(x) == "curator queue" else 0 for c, x in zip(counts, centers)]
settled = [c if route(x) != "curator queue" else 0 for c, x in zip(counts, centers)]

fig, ax = plt.subplots(figsize=(7.2, 3.6), facecolor=SURFACE)
ax.set_facecolor(SURFACE)
for side in ("top", "right"):
    ax.spines[side].set_visible(False)
for side in ("left", "bottom"):
    ax.spines[side].set_color(AXIS)
ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
ax.set_axisbelow(True)
ax.grid(axis="y", color=GRID, linewidth=0.8)
ax.bar(
    centers, settled, width=TOP / BINS * 0.9, color=BLUE, label="settled automatically"
)
ax.bar(
    centers, queued, width=TOP / BINS * 0.9, color=ORANGE, label="sent to the curator"
)
for edge in (0.5, 1.5):
    ax.axvline(edge, color=INK2, linewidth=1, linestyle="--")
ax.set_xticks([0, 0.5, 1, 1.5, 2])
ax.set_xticklabels(["0\ndifferent", "0.5", "1\nrelated", "1.5", "2\nsame"])
ax.set_xlabel("score for the pair", color=INK2, fontsize=9)
ax.set_ylabel("candidate pairs", color=INK2, fontsize=9)
ax.set_title(
    f"{len(PAIRS)} candidate pairs, scored once each",
    loc="left",
    color=INK,
    fontsize=11,
)
ax.legend(frameon=False, labelcolor=INK2, fontsize=9)
display(fig)
plt.close(fig)

for name in ("assert sameAs", "curator queue", "leave unlinked"):
    n = len(by_outcome[name])
    print(f"{name:<16}{n:>5}  ({n / len(PAIRS):>5.1%})")
assert sameAs 40 ( 8.9%)
curator queue 50 (11.1%)
leave unlinked 360 (80.0%)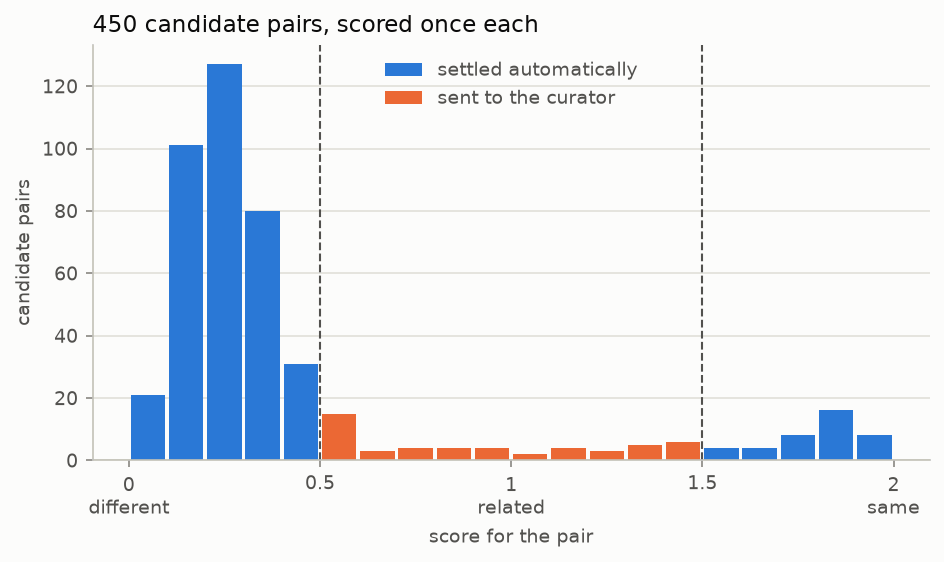
Os dois valores de pontuação em que route() altera sua resposta são os pontos de corte. A maioria dos pares se estabiliza: pontuação 360 abaixo do ponto de corte inferior e 40 acima do superior, sobrando 50 para o curador.
Neste conjunto, as pontuações não se encaixam perfeitamente nos números inteiros. A maioria fica perto de 0,25. Duas cervejas sem nada em comum ainda podem compartilhar um nome de estilo, e os nomes das suas cervejarias podem parecer semelhantes, então o modelo atribui parte de sua probabilidade ao nível intermediário, em vez de zero. O que determina se um par fica de um lado ou de outro de um ponto de corte é a sua posição relativa a esse ponto. A proximidade em relação a um nível não entra nessa decisão.
Os dois pontos de corte não estão igualmente congestionados. Nove pares situam-se a 0.1 do superior, em 1.5, que é o que decide o que é fundido no grafo. Quarenta e sete situam-se tão perto do inferior, em 0.5, que decide apenas se um curador vê o par. Nenhum dos números é algo que você ajusta. Ambos decorrem de como você formulou os níveis, e a formulação do nível do meio é o que move pares entre o curador e os pares que permanecem sem ligação.
Abra no playground
O link do playground abaixo abre c428, que obteve pontuação 1.10 e foi para o curador.
Ele combina Ambleside Amber Ale com Bridge Ambleside Amber Ale - Pomegranate & Galena
Hops: mesma cervejaria, mesmo teor alcoólico. Todas as quatro perguntas vêm junto.
playground_link = make_playground_link(
    {"entity_a": BY_ID["c428"]["entity_a"], "entity_b": BY_ID["c428"]["entity_b"]},
    QUESTIONS,
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this pair + questions in the TypeSafe playground]({playground_link})"
    )
)