 JevCode
지식 그래프 엔티티 정렬
두 개의 맥주 카탈로그에서 450개의 후보 쌍 중 동일한 제품을 설명하는 쌍을 결정합니다. 하나의 TypeSafe Score 질문이 전체 결정을 담당하며, 그 세 가지 수준은 쌍에 대해 수행할 수 있는 세 가지 작업, 즉 병합, 미연결 유지, 큐레이터에게 위임하는 것을 나타냅니다. 조정할 임계값은 존재하지 않습니다.
이 문서는 en에서 기계 번역되었으며 교정되지 않았습니다. 빠른 참고용으로만 사용하세요.

지식 그래프의 주요 문제 중 하나는 들어오는 엔티티가 기존 엔티티를 중복하는지, 특히 이질적인 소스의 자연어만 제공되는 상황에서 결정하는 것입니다. 잠재적 중복 쌍이 주어지면, 단일 TypeSafe Score는 각 쌍이 중복인지, 아니면 큐레이터의 더 면밀한 검토가 필요한지 여부를 결정합니다.
두 데이터 소스가 동일한 사물의 중복된 집합을 기술하고 있으며, 한쪽의 각 항목이 다른 쪽의 어떤 항목과 동일한 사물인지 파악해야 한다고 가정해 봅시다. 지식 그래프는 이러한 항목을 엔티티라고 부르며, 각 엔티티에 대해 기록된 사실을 저장합니다. 저렴하지만 대략적인 첫 번째 단계에서 두 소스를 이미 비교하여 더 면밀한 검토가 필요한 450개의 쌍을 선별했습니다. 남은 작업은 각 쌍에 대해 최종 판단을 내리는 것입니다.
두 엔티티를 부적절하게 병합하는 것은 더 비싼 실수입니다. 왜냐하면 두 엔티티 중 어느 쪽에 대한 사실도 이제 병합된 엔티티를 설명하게 되고, 어느 쪽에 연결된 모든 것도 함께 따라오기 때문입니다. 나중에 되돌리려면 각 사실이 어디에서 유래했는지 파악해야 합니다. 매칭을 놓치면 중복만 남으므로, 판단의 여지가 있는 경우 세 번째 옵션이 필요합니다. 즉, 병합해도 안전하지 않고 삭제해도 안전하지 않은 쌍들입니다.
결정은 세 가지 결과 각각에 대해 하나의 레벨을 가진 Score 질문입니다.
- 다른 제품 — 두 엔티티를 연결하지 않음
- 관련되지만 동일하지 않을 수 있음 — 큐레이터에게 위임하여 결정
- 동일한 제품 — 병합
우리는 각 결과(중간 결과 포함)에 점수 기준이라는 의미 레이블을 직접 연결하고자 하기 때문에 Score 질문을 사용합니다. Noul 질문은 대신 출력에 대한 임계값 처리를 통해 이를 간접적으로 수행할 수 있으며, Choice 질문은 세 결과 간의 순서 관계를 잃게 됩니다.
다음으로, 우리가 고려하려는 엔티티의 각 필드에 대해, Noul 해당 필드가 일치하는지에 대한 질문이 동일한 요청과 함께 전달될 수 있습니다. 이러한 노울은 점수가 “동일 제품” 또는 “다른 제품” 레벨 중 어느 쪽에도 속하지 않는 경우 큐레이터에게 더 자세한 정보를 제공합니다.
route()를 사용하면 후보 쌍 하나를 입력받아 세 가지 결과 중 하나를 반환하며, 자체 데이터에 맞춰 조정해야 하는 임계값은 필요 없습니다.
흐름 방향: LR
| 노드 | 설명 | 그룹 |
|---|---|---|
CALL |
하나의 요청, 네 가지 질문 | 하나의 요청, 네 가지 질문 |
S |
점수: 두 항목은 어떻게 관련되는가? / · 다른 제품 / · 관련은 있으나 반드시 동일한 것은 아님 / · 동일한 제품 | 하나의 요청, 네 가지 질문 |
N |
Noul: 비교된 필드당 하나 / · 동일한 이름인가? / · 동일한 양조장인가? / · 동일한 스타일인가? | 하나의 요청, 네 가지 질문 |
| From | Condition | To |
|---|---|---|
S |
— | N |
S |
— | R |
R |
다름 | DROP |
R |
동일 | M |
R |
관련 | Q |
설정
pip install matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/그다음으로 TYPESAFE_API_KEY을 설정합니다. 모든 호출은 쿡북과 함께 제공되는 json_cache.json에 캐싱되므로, 다시 렌더링하면 API 호출 없이 게시된 수치를 재생합니다. 모든 것을 실시간으로 다시 실행하려면 해당 파일을 삭제하세요.
아래 숫자는 2026-08-11 기준 jev-1.12의 데이터입니다.
import json
import os
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Noul, Score, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
MAX_WORKERS = 6  # small pool; the public endpoint rate-limits above roughly eight

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
후보 쌍 로드
이 쌍들은 공개된 벤치마크 세트에서 온 것으로, Magellan 컬렉션의 Beer 데이터입니다:
서로 다른 웹사이트에서 스크랩한 두 개의 맥주 카탈로그로, 이미 첫 번째 대략적인 단계에서 450개의 쌍으로 줄어든 상태입니다. 각 엔티티는 이름, 양조장, 스타일, 알코올 도수라는 네 가지 필드를 포함합니다. 각 쌍에는 벤치마크 자체의 답변인 known_same_as도 함께 포함됩니다.
문서는 게시된 그대로, 전처리 없이 유지됩니다: 문자로 다시 변환되지 않은 HTML 엔티티, 분리된 아포스트로피, 일부 문자가 잘못 디코딩된 경우.
한 쌍(pair)당 요청이 하나씩 전송되므로, 지출액은 소스(source)의 크기보다는 할당받은 쌍(pair)의 수에 따라 결정됩니다.
PAIRS = json.loads(Path("candidate_pairs.json").read_text(encoding="utf-8"))
BY_ID = {pair["id"]: pair for pair in PAIRS}

print(f"{len(PAIRS)} candidate pairs. The first one, as the model will see it:")
print(json.dumps({k: PAIRS[0][k] for k in ("entity_a", "entity_b")}, indent=2)[:420])
450 candidate pairs. The first one, as the model will see it:
{
"entity_a": {
"name": "C N Red Imperial Red Ale",
"brewery": "Redwood Lodge",
"style": "American Amber / Red Ale",
"abv": "8.10 %"
},
"entity_b": {
"name": "Kinetic Infrared Imperial Red Ale",
"brewery": "Kinetic Brewing Company",
"style": "American Strong Ale",
"abv": "9.30 %"
}
}후보 쌍마다 Score 질문 1개와 Noul 질문 3개를 물어보세요
두 엔티티는 entity_a와 entity_b로 단일 상태에 진입하므로, 질문은 각각의 개별 측면이 아닌 쌍에 관한 것입니다. 네 가지 모두 하나의 요청에 함께 포함됩니다.
아래의 세 단계 설명은 전체 의사결정의 전부를 구성합니다: 각 단계는 하나의 결과를 나타냅니다. 이 파일 어디에도 임계값 상수는 존재하지 않습니다. 숫자를 맞추기 위해 필요한 것과 달리, 이러한 설명은 점수를 단 하나도 확인하기 전에 작성할 수도 있습니다.
중간 레벨은 신중하게 작성할 가치가 있는 부분입니다. 여기서는 변형, 특별판, 그리고 두 제품 중 어느 쪽을 가리킬 가능성이 있는 명칭들을 다루므로, 이러한 항목들은 병합되거나 삭제되지 않고 큐레이터에게 전달됩니다.
OUTCOME은 세 가지 결과를 명명합니다. 병합 결과는 assert sameAs라고 불리는데, 이는 sameAs이 두 엔티티가 동일한 사물임을 기록하는 표준 방식이기 때문이며, 이를 작성하는 것이 병합이 실제로 이루어지는 방법입니다.
네 필드 중 세 필드(이름, 양조장, 스타일)는 Noul 질문을 받습니다. 알코올 도수는 해당되지 않습니다. 두 숫자를 비교하는 것은 산술 작업이기 때문이며, 원한다면 코드에서 계산하면 됩니다. 이 방식을 다른 종류의 데이터에 적용하려면 QUESTIONS과 LEVELS을 수정해야 합니다. 맥주와 관련된 지식을 가진 유일한 코드는 결과를 출력하는 두 함수이며, 이들은 필드명을 사용합니다.
LEVELS = [
    "They describe two different products.",
    "They describe closely related products that may or may not be the same one: "
    "a variant, a special edition, or a name that could plausibly refer to either.",
    "They describe one and the same product.",
]
OUTCOME = {0: "leave unlinked", 1: "curator queue", 2: "assert sameAs"}

QUESTIONS = {
    "link_state": Score(
        instructions="How do the two entity descriptions relate as products?",
        criteria=LEVELS,
    ),
    "same_name": Noul(
        instructions="Do the two entities state the same beer name?",
    ),
    "same_brewery": Noul(
        instructions="Are the two entities from the same brewery?",
    ),
    "same_style": Noul(
        instructions="Do the two entities describe the same beer style?",
    ),
}


@json_cache
def score(pair_id: str) -> dict:
    """One request about one candidate pair -> the score plus the three noul answers."""
    pair = BY_ID[pair_id]
    response = client.system_one(
        state={"entity_a": pair["entity_a"], "entity_b": pair["entity_b"]},
        questions=QUESTIONS,
        model=TYPESAFE_MODEL,
    )
    link = response.answers["link_state"]
    return {
        "score": link.score,
        "probabilities": link.probabilities,
        "confidence": link.confidence,
        "properties": {
            k: response.answers[k].noul for k in QUESTIONS if k != "link_state"
        },
        # tokens and requests are the durable units; don't cache a derived cost
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


def route(score_value: float) -> str:
    """The whole decision rule: the nearest level names the outcome."""
    return OUTCOME[min(int(score_value + 0.5), len(LEVELS) - 1)]


def show(pair_id: str) -> None:
    pair, result = BY_ID[pair_id], score(pair_id)
    print(
        f"{pair_id}  score {result['score']:.2f}  confidence {result['confidence']:.2f}"
        f"  ->  {route(result['score'])}"
    )
    for side in ("entity_a", "entity_b"):
        e = pair[side]
        print(f"    {e['name'][:44]:<46}{e['brewery'][:30]:<32}{e['style'][:22]}")
    nouls = result["properties"]
    print(
        f"    name {nouls['same_name']:.2f}   brewery {nouls['same_brewery']:.2f}   "
        f"style {nouls['same_style']:.2f}"
    )
네 쌍. c446는 하나의 제품이고 c427는 두 개다. 나머지 두 개는 서로 다른 이유로 중간 레벨에 속한다: c100는 동일한 이름과 양조장을 갖지만 출처들은 그 스타일을 다르게 서술하고, c428는 맥주와 그 과실 및 홋 변종을 짝지운다.
for pair_id in ("c446", "c427", "c100", "c428"):
    show(pair_id)
    print()
c446 score 1.94 confidence 0.92 -> assert sameAs
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company American Barleywine
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company Barley Wine
name 0.97 brewery 0.99 style 0.81
c427 score 0.03 confidence 0.95 -> leave unlinked
Frost Quake Bourbon Barrel Aged Barley Wine Wellington County Brewery American Barleywine
Lompoc Bourbon Barrel Aged Proletariat Red A Lompoc Brewing Amber Ale
name 0.02 brewery 0.09 style 0.08
c100 score 1.30 confidence 0.27 -> curator queue
Belle Gueule Rousse Brasseurs R.J. American Amber / Red A
Belle Gueule Rousse Brasseurs RJ Amber Lager/Vienna
name 0.95 brewery 0.94 style 0.35
c428 score 1.10 confidence 0.77 -> curator queue
Ambleside Amber Ale Bridge Brewing Company American Amber / Red A
Bridge Ambleside Amber Ale - Pomegranate & G Bridge Brewing Company Amber Ale
name 0.63 brewery 0.98 style 0.74모든 후보 쌍을 라우팅
# 450 candidate pairs, one request each; a small pool keeps a live run to a few minutes.
with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
    scored = list(pool.map(lambda pair: score(pair["id"]), PAIRS))

scores = [result["score"] for result in scored]
by_outcome: dict[str, list[str]] = {name: [] for name in OUTCOME.values()}
for pair, s in zip(PAIRS, scores):
    by_outcome[route(s)].append(pair["id"])

SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

BINS, TOP = 20, len(LEVELS) - 1
counts = [0] * BINS
for s in scores:
    counts[min(int(s / TOP * BINS), BINS - 1)] += 1
centers = [(i + 0.5) / BINS * TOP for i in range(BINS)]
queued = [c if route(x) == "curator queue" else 0 for c, x in zip(counts, centers)]
settled = [c if route(x) != "curator queue" else 0 for c, x in zip(counts, centers)]

fig, ax = plt.subplots(figsize=(7.2, 3.6), facecolor=SURFACE)
ax.set_facecolor(SURFACE)
for side in ("top", "right"):
    ax.spines[side].set_visible(False)
for side in ("left", "bottom"):
    ax.spines[side].set_color(AXIS)
ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
ax.set_axisbelow(True)
ax.grid(axis="y", color=GRID, linewidth=0.8)
ax.bar(
    centers, settled, width=TOP / BINS * 0.9, color=BLUE, label="settled automatically"
)
ax.bar(
    centers, queued, width=TOP / BINS * 0.9, color=ORANGE, label="sent to the curator"
)
for edge in (0.5, 1.5):
    ax.axvline(edge, color=INK2, linewidth=1, linestyle="--")
ax.set_xticks([0, 0.5, 1, 1.5, 2])
ax.set_xticklabels(["0\ndifferent", "0.5", "1\nrelated", "1.5", "2\nsame"])
ax.set_xlabel("score for the pair", color=INK2, fontsize=9)
ax.set_ylabel("candidate pairs", color=INK2, fontsize=9)
ax.set_title(
    f"{len(PAIRS)} candidate pairs, scored once each",
    loc="left",
    color=INK,
    fontsize=11,
)
ax.legend(frameon=False, labelcolor=INK2, fontsize=9)
display(fig)
plt.close(fig)

for name in ("assert sameAs", "curator queue", "leave unlinked"):
    n = len(by_outcome[name])
    print(f"{name:<16}{n:>5}  ({n / len(PAIRS):>5.1%})")
assert sameAs 40 ( 8.9%)
curator queue 50 (11.1%)
leave unlinked 360 (80.0%)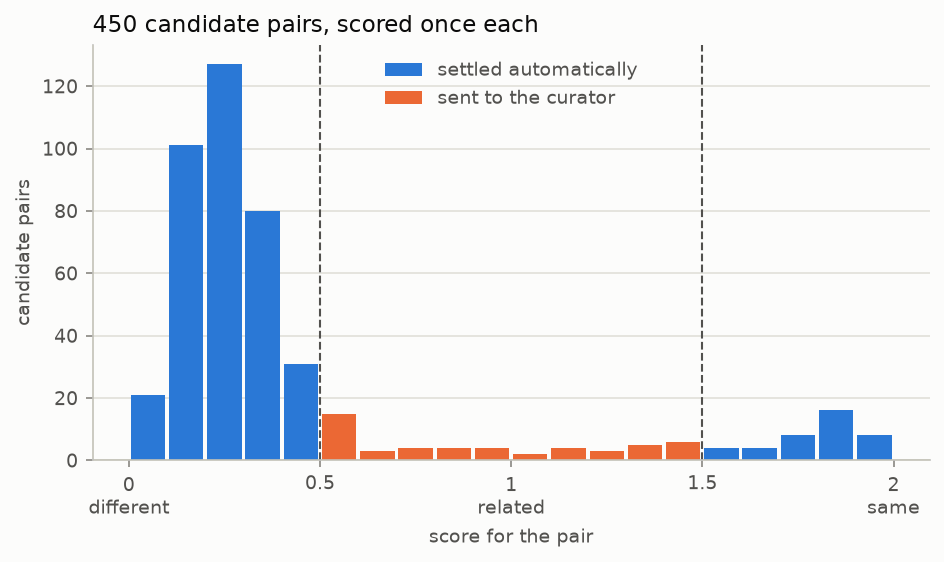
route()의 답변이 바뀌는 두 가지 점수 값이 컷 포인트입니다. 대부분의 쌍은 하단 컷 포인트 아래에서 점수 360, 상단 컷 포인트 위에서 점수 40으로 수렴하며, 큐레이터에게는 50이 남습니다.
이 세트에서는 점수가 정수 위에 깔끔하게 위치하지 않습니다. 대부분 0.25 근처에 모여 있습니다. 공통점이 전혀 없어 보이는 두 맥주라도 스타일 이름은 같을 수 있고, 양조장 이름도 비슷해 보일 수 있으므로, 모델은 확률의 일부를 중간 레벨에 할당합니다. 어떤 쌍이 컷포인트의 어느 쪽에 속하는지를 결정하는 요소는 무엇일까요? 레벨에서 얼마나 떨어져 있는지는 고려되지 않습니다.
두 가지 분기점은 동일하게 혼잡하지 않다. 아홉 쌍은 상단 분기점(1.5) 근처 0.1 이내에 위치하며, 이 분기점은 그래프에 병합될 대상을 결정한다. 사십일 쌍은 하단 분기점(0.5) 근처 0.1 이내에 위치하며, 이 분기점은 큐레이터가 해당 쌍을 보는지 여부를 결정한다. 두 숫자 모두 사용자가 조정하는 값이 아니다. 둘 다 레벨을 어떻게 기술했는지에 따라 도출되며, 중간 레벨의 기술 방식이 큐레이터와 연결되지 않은 쌍들 사이에서 쌍을 이동시킨다.
플레이그라운드에서 열기
아래 플레이그라운드 링크는 c428를 열며, 이는 1.10의 점수를 받고 큐레이터에게 전달되었습니다.
이것은 Ambleside Amber Ale과 Bridge Ambleside Amber Ale - Pomegranate & Galena
Hops를 페어링합니다: 같은 양조장, 같은 알코올 도수. 모든 네 가지 질문이 이에 따라 제공됩니다.
playground_link = make_playground_link(
    {"entity_a": BY_ID["c428"]["entity_a"], "entity_b": BY_ID["c428"]["entity_b"]},
    QUESTIONS,
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this pair + questions in the TypeSafe playground]({playground_link})"
    )
)