 JevCode
alineación de entidades de grafos de conocimiento
Decide cuál de los 450 pares candidatos de dos catálogos de cerveza describe el mismo producto. Una pregunta de Puntuación TypeSafe determina toda la decisión, ya que sus tres niveles corresponden a las tres acciones que puedes realizar con un par: fusionarlo, dejarlo sin vincular o asignarlo a un curador. No hay umbral que ajustar, un
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

Un problema clave en los grafos de conocimiento es decidir si una entidad entrante duplica a una existente, especialmente cuando lo único disponible es lenguaje natural procedente de fuentes dispares. Dadas las posibles parejas duplicadas, un único TypeSafe Score decide si cada pareja es un duplicado o si merece una mirada más atenta por parte de un curador.
Supongamos que dos fuentes de datos describen conjuntos superpuestos de las mismas cosas, y necesitas saber qué entrada de un lado corresponde a la misma cosa que la entrada del otro. Un grafo de conocimiento llama entidades a esas entradas, y almacena los hechos registrados sobre cada una. Una primera pasada barata pero aproximada ya ha comparado las dos fuentes y ha seleccionado 450 pares que merecen un examen más detenido. Lo que queda es tomar una decisión sobre cada par.
Fusionar dos entidades de forma inapropiada es el error más costoso, ya que cada hecho sobre cualquiera de las entidades ahora describe a la fusionada, y cualquier cosa vinculada a cualquiera de ellas también se incluye. Deshacerlo más tarde implica determinar de dónde provenía cada hecho. Perder un emparejamiento solo deja un duplicado, por lo que la decisión requiere una tercera opción: pares que no son seguros para fusionar ni seguros para descartar.
El juicio es una Score pregunta con un nivel para cada uno de los tres resultados:
- producto diferente — dejar las dos entidades sin enlazar
- relacionado, pero posiblemente no el mismo — pasarlo a un curador para que decida
- mismo producto — fusionarlos
Utilizamos una pregunta Score porque queremos adjuntar una etiqueta semántica, los criterios de puntuación, directamente a cada resultado, incluido el resultado intermedio. Una pregunta Noul podría lograr esto indirectamente mediante la umbralización de su salida, mientras que una pregunta Choice perdería la relación ordenada de los tres resultados.
A continuación, para cada campo de la entidad que deseamos considerar, Noul preguntas sobre si esos campos coinciden pueden viajar en la misma solicitud. Estos nouls proporcionan información más detallada para el curador, si la puntuación no se encuentra ni en los niveles de “mismo producto” ni de “producto diferente”.
Terminas con un route() que toma un par de candidatos y devuelve uno de los tres resultados, sin ningún umbral que tuviste que ajustar a tus propios datos.
Dirección del flujo: LR
| Nodo | Descripción | Grupo |
|---|---|---|
CALL |
una solicitud, cuatro preguntas | una solicitud, cuatro preguntas |
S |
Score: ¿cómo se relacionan? / · producto diferente / · relacionados, pero posiblemente no iguales / · mismo producto | una solicitud, cuatro preguntas |
N |
Nouls: uno por campo comparado / · ¿mismo nombre? / · ¿misma cervecería? / · ¿mismo estilo? | una solicitud, cuatro preguntas |
| De | Condición | A |
|---|---|---|
S |
— | N |
S |
— | R |
R |
diferente | DROP |
R |
igual | M |
R |
relacionado | Q |
Configuración
pip install matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/luego establece TYPESAFE_API_KEY. Cada llamada se almacena en caché en json_cache.json, que se incluye con el libro de recetas, por lo que volver a renderizar reproduce los números publicados sin llamar a la API. Elimina ese archivo para volver a ejecutar todo en tiempo real.
Los números de abajo provienen de jev-1.12 el 2026-08-11.
import json
import os
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Noul, Score, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
MAX_WORKERS = 6  # small pool; the public endpoint rate-limits above roughly eight

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Cargar los pares candidatos
Los pares provienen de un conjunto de referencia publicado, los datos de Beer de la colección Magellan:
dos catálogos de cerveza extraídos de diferentes sitios web, ya reducidos a 450 pares por esa
primera pasada aproximada. Cada entidad tiene cuatro campos: nombre, cervecería, estilo y contenido
alcohólico. Cada par también lleva known_same_as, la respuesta del propio benchmark.
El texto se deja exactamente como se publicó, sin preprocesamiento: entidades HTML que nunca se convirtieron de nuevo en caracteres, apóstrofes separados como palabras distintas, algunos caracteres decodificados incorrectamente.
Una solicitud se envía por cada par, por lo que lo que gastas depende del número de pares que te hayan asignado, en lugar del tamaño de cualquiera de las fuentes.
PAIRS = json.loads(Path("candidate_pairs.json").read_text(encoding="utf-8"))
BY_ID = {pair["id"]: pair for pair in PAIRS}

print(f"{len(PAIRS)} candidate pairs. The first one, as the model will see it:")
print(json.dumps({k: PAIRS[0][k] for k in ("entity_a", "entity_b")}, indent=2)[:420])
450 candidate pairs. The first one, as the model will see it:
{
"entity_a": {
"name": "C N Red Imperial Red Ale",
"brewery": "Redwood Lodge",
"style": "American Amber / Red Ale",
"abv": "8.10 %"
},
"entity_b": {
"name": "Kinetic Infrared Imperial Red Ale",
"brewery": "Kinetic Brewing Company",
"style": "American Strong Ale",
"abv": "9.30 %"
}
}Haz una pregunta Score y tres preguntas Noul por par de candidatos
Ambas entidades van a un único estado, como entity_a y entity_b, por lo que las preguntas se refieren al par y no a ninguno de los lados por separado. Los cuatro viajan en una única solicitud.
Las tres descripciones de nivel que aparecen a continuación constituyen la decisión completa: cada nivel es un resultado. No hay ninguna constante de umbral en ningún lugar de este archivo. También puedes escribir estas descripciones antes de haber visto una sola puntuación, lo cual no es cierto para un número que debes ajustar.
El nivel intermedio es el que merece una redacción cuidadosa. Aquí se abordan variantes, ediciones especiales y nombres que podrían referirse con plausibilidad a cualquiera de los productos, de modo que estos llegan a un curador en lugar de ser fusionados o descartados.
OUTCOME nombra los tres resultados. El resultado de la fusión se llama assert sameAs porque
sameAs es la forma estándar de registrar que dos entidades son lo mismo, y escribir
uno es cómo ocurre realmente la fusión.
Tres de los cuatro campos reciben una pregunta Noul: nombre, cervecería y estilo. El contenido alcohólico
no recibe ninguna, porque comparar dos números es aritmética; calcúlalo en el código si quieres que aparezca.
Para usar esto en otro tipo de datos, reescribe QUESTIONS y LEVELS. El único otro
código que conoce la cerveza son las dos funciones que imprimen los resultados, las cuales nombran los campos.
LEVELS = [
    "They describe two different products.",
    "They describe closely related products that may or may not be the same one: "
    "a variant, a special edition, or a name that could plausibly refer to either.",
    "They describe one and the same product.",
]
OUTCOME = {0: "leave unlinked", 1: "curator queue", 2: "assert sameAs"}

QUESTIONS = {
    "link_state": Score(
        instructions="How do the two entity descriptions relate as products?",
        criteria=LEVELS,
    ),
    "same_name": Noul(
        instructions="Do the two entities state the same beer name?",
    ),
    "same_brewery": Noul(
        instructions="Are the two entities from the same brewery?",
    ),
    "same_style": Noul(
        instructions="Do the two entities describe the same beer style?",
    ),
}


@json_cache
def score(pair_id: str) -> dict:
    """One request about one candidate pair -> the score plus the three noul answers."""
    pair = BY_ID[pair_id]
    response = client.system_one(
        state={"entity_a": pair["entity_a"], "entity_b": pair["entity_b"]},
        questions=QUESTIONS,
        model=TYPESAFE_MODEL,
    )
    link = response.answers["link_state"]
    return {
        "score": link.score,
        "probabilities": link.probabilities,
        "confidence": link.confidence,
        "properties": {
            k: response.answers[k].noul for k in QUESTIONS if k != "link_state"
        },
        # tokens and requests are the durable units; don't cache a derived cost
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


def route(score_value: float) -> str:
    """The whole decision rule: the nearest level names the outcome."""
    return OUTCOME[min(int(score_value + 0.5), len(LEVELS) - 1)]


def show(pair_id: str) -> None:
    pair, result = BY_ID[pair_id], score(pair_id)
    print(
        f"{pair_id}  score {result['score']:.2f}  confidence {result['confidence']:.2f}"
        f"  ->  {route(result['score'])}"
    )
    for side in ("entity_a", "entity_b"):
        e = pair[side]
        print(f"    {e['name'][:44]:<46}{e['brewery'][:30]:<32}{e['style'][:22]}")
    nouls = result["properties"]
    print(
        f"    name {nouls['same_name']:.2f}   brewery {nouls['same_brewery']:.2f}   "
        f"style {nouls['same_style']:.2f}"
    )
Cuatro pares. c446 es un producto y c427 son dos. Los otros dos se sitúan en el nivel intermedio por razones distintas: c100 tiene el mismo nombre y cervecería, pero las fuentes describen su estilo de manera diferente, mientras que c428 empareja una cerveza con una variante de esta a base de fruta y lúpulo.
for pair_id in ("c446", "c427", "c100", "c428"):
    show(pair_id)
    print()
c446 score 1.94 confidence 0.92 -> assert sameAs
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company American Barleywine
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company Barley Wine
name 0.97 brewery 0.99 style 0.81
c427 score 0.03 confidence 0.95 -> leave unlinked
Frost Quake Bourbon Barrel Aged Barley Wine Wellington County Brewery American Barleywine
Lompoc Bourbon Barrel Aged Proletariat Red A Lompoc Brewing Amber Ale
name 0.02 brewery 0.09 style 0.08
c100 score 1.30 confidence 0.27 -> curator queue
Belle Gueule Rousse Brasseurs R.J. American Amber / Red A
Belle Gueule Rousse Brasseurs RJ Amber Lager/Vienna
name 0.95 brewery 0.94 style 0.35
c428 score 1.10 confidence 0.77 -> curator queue
Ambleside Amber Ale Bridge Brewing Company American Amber / Red A
Bridge Ambleside Amber Ale - Pomegranate & G Bridge Brewing Company Amber Ale
name 0.63 brewery 0.98 style 0.74Enruta cada par de candidatos
# 450 candidate pairs, one request each; a small pool keeps a live run to a few minutes.
with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
    scored = list(pool.map(lambda pair: score(pair["id"]), PAIRS))

scores = [result["score"] for result in scored]
by_outcome: dict[str, list[str]] = {name: [] for name in OUTCOME.values()}
for pair, s in zip(PAIRS, scores):
    by_outcome[route(s)].append(pair["id"])

SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

BINS, TOP = 20, len(LEVELS) - 1
counts = [0] * BINS
for s in scores:
    counts[min(int(s / TOP * BINS), BINS - 1)] += 1
centers = [(i + 0.5) / BINS * TOP for i in range(BINS)]
queued = [c if route(x) == "curator queue" else 0 for c, x in zip(counts, centers)]
settled = [c if route(x) != "curator queue" else 0 for c, x in zip(counts, centers)]

fig, ax = plt.subplots(figsize=(7.2, 3.6), facecolor=SURFACE)
ax.set_facecolor(SURFACE)
for side in ("top", "right"):
    ax.spines[side].set_visible(False)
for side in ("left", "bottom"):
    ax.spines[side].set_color(AXIS)
ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
ax.set_axisbelow(True)
ax.grid(axis="y", color=GRID, linewidth=0.8)
ax.bar(
    centers, settled, width=TOP / BINS * 0.9, color=BLUE, label="settled automatically"
)
ax.bar(
    centers, queued, width=TOP / BINS * 0.9, color=ORANGE, label="sent to the curator"
)
for edge in (0.5, 1.5):
    ax.axvline(edge, color=INK2, linewidth=1, linestyle="--")
ax.set_xticks([0, 0.5, 1, 1.5, 2])
ax.set_xticklabels(["0\ndifferent", "0.5", "1\nrelated", "1.5", "2\nsame"])
ax.set_xlabel("score for the pair", color=INK2, fontsize=9)
ax.set_ylabel("candidate pairs", color=INK2, fontsize=9)
ax.set_title(
    f"{len(PAIRS)} candidate pairs, scored once each",
    loc="left",
    color=INK,
    fontsize=11,
)
ax.legend(frameon=False, labelcolor=INK2, fontsize=9)
display(fig)
plt.close(fig)

for name in ("assert sameAs", "curator queue", "leave unlinked"):
    n = len(by_outcome[name])
    print(f"{name:<16}{n:>5}  ({n / len(PAIRS):>5.1%})")
assert sameAs 40 ( 8.9%)
curator queue 50 (11.1%)
leave unlinked 360 (80.0%)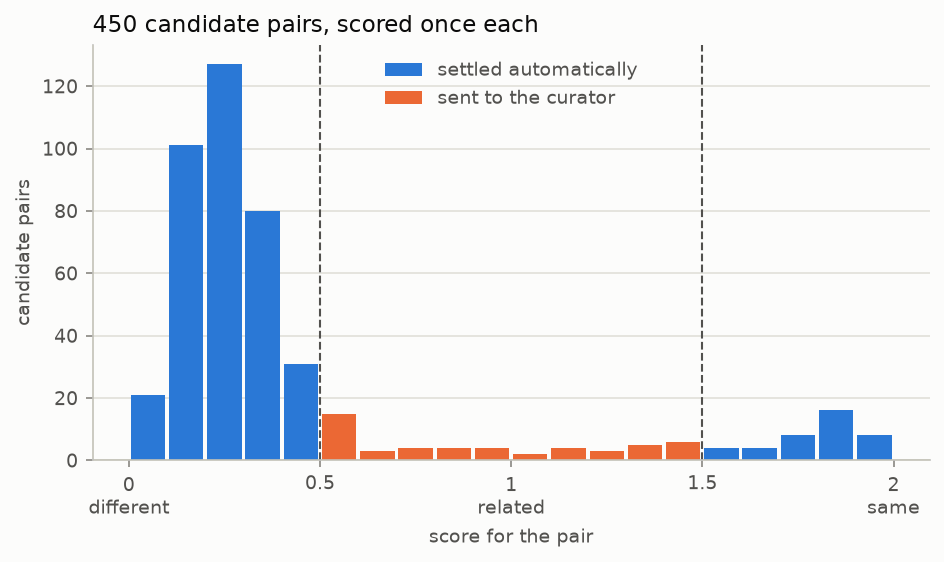
Los dos valores de puntuación donde route() cambia su respuesta son los puntos de corte. La mayoría de los pares se estabilizan: 360 de puntuación por debajo del punto de corte inferior y 40 por encima del superior, dejando 50 para el curador.
En este conjunto, las puntuaciones no se ajustan limpiamente a los números enteros. La mayoría se sitúa cerca de 0.25. Dos cervezas sin nada en común podrían compartir aún así un nombre de estilo, y los nombres de sus cervecerías podrían parecerse, por lo que el modelo asigna parte de su probabilidad al nivel intermedio en lugar de ninguna. Lo que decide si un par cae en un lado u otro del punto de corte es su posición relativa a ese punto. Qué tan cerca se encuentra de un nivel no entra en consideración.
Los dos puntos de corte no están igualmente concurridos. Nueve pares se encuentran dentro de 0.1 del superior, en 1.5, que es el que decide qué se fusiona en el grafo. Cuarenta y siete se encuentran tan cerca del inferior, en 0.5, que solo decide si un curador ve el par. Ninguno de los números es algo que ajustes. Ambos derivan de cómo redactaste los niveles, y la redacción del nivel intermedio es lo que mueve los pares entre el curador y los pares que quedan sin enlazar.
Ábrelo en el playground
El enlace del playground a continuación abre c428, que obtuvo una puntuación de 1.10 y pasó al curador.
Empareja Ambleside Amber Ale con Bridge Ambleside Amber Ale - Pomegranate & Galena
Hops: misma cervecería, mismo contenido alcohólico. Las cuatro preguntas vienen con ello.
playground_link = make_playground_link(
    {"entity_a": BY_ID["c428"]["entity_a"], "entity_b": BY_ID["c428"]["entity_b"]},
    QUESTIONS,
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this pair + questions in the TypeSafe playground]({playground_link})"
    )
)