 JevCode
Sugerencia de habilidad
Selecciona a lo sumo una habilidad para el turno de un agente entre las 182 del catálogo de Hermes de Nous Research: una solicitud TypeSafe clasifica todas las habilidades y pregunta si el turno necesita alguna en absoluto; una segunda lee correctamente las tres principales y puede rechazarlas todas. El nombre del ganador se escribe en una sola línea de la configuración del agente
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

Los agentes eligen habilidades truncándolas y cargándolas todas en el mensaje del sistema, lo que aumenta los costos, degrada el rendimiento de la selección de habilidades e induce una degradación del contexto para el resto de la sesión. Abordamos esto mediante dos solicitudes TypeSafe por turno, una para clasificar las habilidades y otra para verificar la elección, reduciendo en más de la mitad las cargas incorrectas de habilidades.
Un agente con un amplio catálogo de habilidades toma su decisión con casi ninguna información. El catálogo llega a él como un índice: una línea por habilidad, con la descripción truncada para que el texto completo no sature la conversación. Hermes, el framework de agentes utilizado aquí, lo recorta a 60 caracteres por defecto. Por ejemplo, a ese ancho, la habilidad que edita .pptx archivos se lee casi igual que la que redacta archivos. Si se le pide un pitch deck, el agente podría cargar el incorrecto. En un turno donde ninguna habilidad encaja en absoluto, aún así podría cargar una, porque una lista de nombres invita a adivinar.
Este libro de recetas deja las descripciones intactas y utiliza una divulgación progresiva, leyendo todas las 182 habilidades de forma económica y luego leyendo tres de ellas en detalle. Dos solicitudes TypeSafe se realizan antes de la decisión sobre qué habilidad cargar, si es que se carga alguna. La primera clasifica cada habilidad del roster frente al turno del usuario y responde si el turno necesita una habilidad en absoluto. La segunda vuelve a leer solo las tres principales, ahora con la descripción completa de cada habilidad y el inicio de sus instrucciones, y tiene libertad para rechazar todas ellas.
El nombre del ganador se inserta en una línea adicional del prompt del sistema del agente para esa ronda:
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user
actually asked for.
</skill_relevance>
El agente mantiene su índice completo y su propio juicio, y esa única línea solo le indica qué
entrada examinar primero. La lista en sí nunca cambia, por lo que cualquier caché de prefijos sobre ella
sigue siendo válida. En 488 solicitudes contra claude-haiku-4-5-20251001, utilizando habilidades del
roster de Hermes:
| carga la habilidad incorrecta | carga una cuando no encaja nada | |
|---|---|---|
| agente solo, con solo su lista | 16.8% | 9.8% |
| agente con una sugerencia de TypeSafe | 7.3% | 4.0% |
| agente al que se le da la respuesta correcta | 2.5% | 1.2% |
La tercera fila muestra que el piso para cometer errores no es cero, porque un agente que tiene la habilidad correcta aún no siempre la carga, y ningún método de selección, por bueno que sea, supera eso.
Terminas con una función suggest() que devuelve como máximo un nombre de habilidad, un suggestion_block() que la envuelve para la indicación del sistema, y el arnés que generó la tabla anterior, listo para apuntar a tu propia lista.
Dirección del flujo: LR
| Nodo | Descripción | Grupo |
|---|---|---|
C1 |
Llamada 1 - revisar rápidamente las 182 habilidades | Llamada 1 - revisar rápidamente las 182 habilidades |
Q1 |
Elección: ¿qué habilidad encaja? / las 182, una línea cada una | Llamada 1 - revisar rápidamente las 182 habilidades |
N1 |
Nouls: ¿se necesita una habilidad en absoluto? / · ¿actuar sobre su material? / · ¿seguir pasos escritos? / · o simplemente hablar? | Llamada 1 - revisar rápidamente las 182 habilidades |
C2 |
Llamada 2 - leer esas 3 adecuadamente | Llamada 2 - leer esas 3 adecuadamente |
Q2 |
Elección: ¿cuál de las 3? / con detalles reales ahora | Llamada 2 - leer esas 3 adecuadamente |
N2 |
Nouls: ¿realmente hace cada una / lo que se espera? | Llamada 2 - leer esas 3 adecuadamente |
| De | Condición | A |
|---|---|---|
Q1 |
— | N1 |
Q2 |
— | N2 |
C1 |
top 3 | C2 |
C1 |
nada / aplica | STOP |
C2 |
ninguno encaja | STOP |
C2 |
un ganador | OUT |
Configuración
- Instala el cliente TypeSafe, el cliente Anthropic y los ayudantes compartidos de la cookbook.
- Configura una clave de API de TypeSafe, y una clave de Anthropic para el agente que se está midiendo.
pip install anthropic matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/
export TYPESAFE_API_KEY=your-key-here
export ANTHROPIC_API_KEY=your-key-here
Nota: Los bloques de código a continuación son un único script, en orden. Para seguir el ejemplo, colócalos en un solo archivo en el orden indicado.
Resultados de caché
JsonCache guarda el resultado de cada llamada, indexado por sus entradas, por lo que volver a ejecutar reproduce los
números de abajo en lugar de llamar a ninguna API. Elimina json_cache.json para ejecutar en vivo. La
publicación utilizó jev-1.12 y claude-haiku-4-5-20251001, renderizado el 2026-07-31.
import json
import os
from collections import defaultdict
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
from time import perf_counter

import anthropic
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.ticker import PercentFormatter
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
AGENT_MODEL = (
    "claude-haiku-4-5-20251001"  # the agent under test, pinned so scores are stable
)

SHORTLIST = 3  # candidates carried from the first request into the second
EXCERPT_CHARS = (
    700  # SKILL.md characters each candidate brings; the roster file stores 1600
)
GATE_THRESHOLD = (
    0.30  # mean of the three request nouls, below which nothing is suggested
)
FITS_THRESHOLD = (
    0.30  # a shortlist whose best "does this fit" noul is under this is dropped
)
WORKERS = 8  # small pool: enough to keep a live run to minutes, gentle on rate limits

assert EXCERPT_CHARS <= 1600, (
    "the shipped roster file stores 1600 body characters per skill"
)

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
agent = anthropic.Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY", "cache-only"))
json_cache = JsonCache(Path("json_cache.json"))
Paso 1: cargar el roster
hermes_roster.json contiene las 182 habilidades de
NousResearch/hermes-agent (MIT) en un
commit fijado. Cada registro contiene el nombre y la categoría de una habilidad, la descripción tal como la muestra el índice, la descripción completa y el inicio de su SKILL.md.
El índice a continuación, y las instrucciones anteriores en el prompt, están copiados de Hermes.
ROSTER = json.loads(Path("hermes_roster.json").read_text(encoding="utf-8"))
BY_NAME = {skill["name"]: skill for skill in ROSTER}

# Verbatim from hermes-agent agent/prompt_builder.py:build_skills_system_prompt.
PREAMBLE = (
    "## Skills (mandatory)\n"
    "Before replying, scan the skills below. If a skill matches or is even partially relevant "
    "to your task, you MUST load it with skill_view(name) and follow its instructions. "
    "Err on the side of loading — it is always better to have context you don't need "
    "than to miss critical steps, pitfalls, or established workflows. "
    "Skills contain specialized knowledge — API endpoints, tool-specific commands, "
    "and proven workflows that outperform general-purpose approaches. Load the skill "
    "even if you think you could handle the task with basic tools like web_search or terminal. "
    "Skills also encode the user's preferred approach, conventions, and quality standards "
    "for tasks like code review, planning, and testing — load them even for tasks you "
    "already know how to do, because the skill defines how it should be done here.\n"
    "Whenever the user asks you to configure, set up, install, enable, disable, modify, "
    "or troubleshoot Hermes Agent itself — its CLI, config, models, providers, tools, "
    "skills, voice, gateway, plugins, or any feature — load the `hermes-agent` skill "
    "first. It has the actual commands (e.g. `hermes config set …`, `hermes tools`, "
    "`hermes setup`) so you don't have to guess or invent workarounds.\n"
    "If a skill has issues, fix it with skill_manage(action='patch').\n"
    "After difficult/iterative tasks, offer to save as a skill. "
    "If a skill you loaded was missing steps, had wrong commands, or needed "
    "pitfalls you discovered, update it before finishing.\n"
    "\n"
)
FOOTER = "\n\nOnly proceed without loading a skill if genuinely none are relevant to the task."
IDENTITY = (
    "You are Hermes, a capable AI assistant with access to tools and a library "
    "of skills. You help the user with coding, research, and everyday tasks.\n\n"
)


def render_index() -> str:
    """The body of <available_skills>: skills grouped by category, both sorted by name."""
    by_category = defaultdict(list)
    for skill in ROSTER:
        by_category[skill["category"]].append(skill)
    lines = []
    for category in sorted(by_category):
        lines.append(f"  {category}:")
        for skill in sorted(by_category[category], key=lambda s: s["name"]):
            lines.append(f"    - {skill['name']}: {skill['description']}")
    return "\n".join(lines)


CATALOG_PROMPT = (
    IDENTITY
    + PREAMBLE
    + "<available_skills>\n"
    + render_index()
    + "\n</available_skills>"
    + FOOTER
)

widths = [len(skill["description"]) for skill in ROSTER]
print(f"{len(ROSTER)} skills in {len({s['category'] for s in ROSTER})} categories")
print(f"roster prompt: {len(CATALOG_PROMPT):,} characters")
print(
    f"index description: {sum(widths) / len(widths):.0f} characters on average, "
    f"{max(widths)} at most"
)
print("\none category, as the agent reads it:")
index_lines = render_index().splitlines()
start = index_lines.index("  apple:")
end = next(
    i
    for i in range(start + 1, len(index_lines))
    if not index_lines[i].startswith("    ")
)
print("\n".join(index_lines[start:end]))
182 skills in 33 categories
roster prompt: 16,089 characters
index description: 54 characters on average, 60 at most
one category, as the agent reads it:
apple:
- apple-notes: Manage Apple Notes via memo CLI: create, search, edit.
- apple-reminders: Apple Reminders via remindctl: add, list, complete.
- findmy: Track Apple devices/AirTags via FindMy.app on macOS.
- imessage: Send and receive iMessages/SMS via the imsg CLI on macOS.Paso 2: evaluar al agente según sus propios criterios
requests.json contiene 488 solicitudes de turno único, 315 de ellas cubiertas por exactamente una habilidad
y las otras 173 no cubiertas por ninguna.
Las solicitudes cubiertas fueron escritas por Claude Sonnet 5 desde SKILL.md propio de cada habilidad, por lo que las etiquetas son confiables y las solicitudes son más fáciles que las que envían los usuarios.
Los 173 restantes fueron escritos para castigar las conjeturas: 85 peticiones cotidianas, 42 preguntas técnicas que ninguna habilidad atiende (explicar qué es una mónada), y 46 que solicitan algo específico para lo cual el listado no tiene ninguna habilidad, como publicar esto en Mastodon en un listado que cubre X y nada más.
La puntuación lee únicamente la primera respuesta del agente. Ambas cifras son tasas de error, por lo que un valor más bajo es mejor en cada caso:
- carga errónea: de las solicitudes cubiertas, la proporción en la que la primera
skill_viewllamada no fue la habilidad que la cubría. Una vuelta que no cargó nada en absoluto cuenta como un fallo. - carga innecesaria: de las solicitudes no cubiertas, la proporción en la que el agente llamó a
skill_viewen absoluto.
REQUESTS = json.loads(Path("requests.json").read_text(encoding="utf-8"))
POSITIVES = [p for p in REQUESTS if p["gold"]]
NEGATIVES = [p for p in REQUESTS if not p["gold"]]

print(
    f"{len(REQUESTS)} requests: {len(POSITIVES)} covered by a skill "
    f"({len({p['gold'] for p in POSITIVES})} distinct skills), {len(NEGATIVES)} covered by none"
)
print(f"\ncovered   [{POSITIVES[0]['gold']}]  {POSITIVES[0]['text']}")
print(f"uncovered  {NEGATIVES[0]['text']}")
488 requests: 315 covered by a skill (171 distinct skills), 173 covered by none
covered [1password] I've got a config.yaml with `{{ op://app-prod/db/password }}` placeholders in it — can you set up my project to pull the real values in at runtime instead of hardcoding them?
uncovered Add these three cards to our Trello backlog.La sugerencia va en su propio bloque del prompt del sistema, después del roster en lugar de dentro de él, para que el texto del roster sea idéntico en cada turno y mantener el caché de prefijos.
El agente tiene un conjunto mínimo de herramientas, que incluye skill_view para cargar una habilidad usando un nombre en texto libre. El nombre debe coincidir exactamente con la habilidad para que la carga sea correcta.
# Verbatim from hermes-agent tools/skills_tool.py:SKILL_VIEW_SCHEMA.
SKILL_VIEW_DESCRIPTION = (
    "Skills allow for loading information about specific tasks and workflows, as "
    "well as scripts and templates. Load a skill's full content or access its "
    "linked files (references, templates, scripts). First call returns SKILL.md "
    "content plus a 'linked_files' dict showing available references/templates/"
    "scripts. To access those, call again with file_path parameter."
)
TOOLS = [
    {
        "name": "skill_view",
        "description": SKILL_VIEW_DESCRIPTION,
        "input_schema": {
            "type": "object",
            "properties": {
                "name": {"type": "string", "description": "The skill name."}
            },
            "required": ["name"],
        },
    },
    {
        "name": "terminal",
        "description": "Run a shell command on the user's machine and return its output.",
        "input_schema": {
            "type": "object",
            "properties": {"command": {"type": "string"}},
            "required": ["command"],
        },
    },
    {
        "name": "read_file",
        "description": "Read a file from the user's filesystem.",
        "input_schema": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
    {
        "name": "web_search",
        "description": "Search the web and return result snippets.",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    },
]


@json_cache
def run_turn(model: str, arm: str, request: str, suggestion: str) -> dict:
    """One measured turn. ``arm`` is in the key so each arm samples independently."""
    system = [
        {"type": "text", "text": CATALOG_PROMPT, "cache_control": {"type": "ephemeral"}}
    ]
    if suggestion:
        system.append({"type": "text", "text": suggestion})  # after the breakpoint
    response = agent.messages.create(
        model=model,
        max_tokens=1024,
        system=system,
        tools=TOOLS,
        messages=[{"role": "user", "content": request}],
    )
    usage = response.usage
    return {
        "loaded": [
            str(block.input.get("name", ""))
            for block in response.content
            if block.type == "tool_use" and block.name == "skill_view"
        ],
        "input_tokens": usage.input_tokens or 0,
        "output_tokens": usage.output_tokens or 0,
    }


def summarise(turns: dict[str, dict]) -> dict[str, float]:
    """Two failure rates: wrong loads on covered requests, needless ones on uncovered."""
    hits = [turns[p["text"]]["loaded"][:1] == [p["gold"]] for p in POSITIVES]
    over = [bool(turns[p["text"]]["loaded"]) for p in NEGATIVES]
    return {
        # both metrics are errors, so the two columns read the same direction
        "wrong_load": 1 - sum(hits) / len(hits),
        "needless_load": sum(over) / len(over),
    }


def run_arm(arm: str, suggestions: dict[str, str]) -> dict[str, dict]:
    """One measured turn per request, in a small pool. 488 calls."""
    texts = [request["text"] for request in REQUESTS]
    with ThreadPoolExecutor(max_workers=WORKERS) as pool:
        turns = pool.map(
            lambda t: run_turn(AGENT_MODEL, arm, t, suggestions.get(t, "")), texts
        )
        return dict(zip(texts, turns))
El agente se ejecuta primero con únicamente su lista de roles, tal como funciona hoy en día. Sus dos tasas de error son la línea base contra la que mide el resto del libro de recetas.
baseline = run_arm("baseline", {})
base_scores = summarise(baseline)
print(
    f"wrong loads    {base_scores['wrong_load']:.1%}   ({len(POSITIVES)} covered requests)"
)
print(
    f"needless loads {base_scores['needless_load']:.1%}   ({len(NEGATIVES)} uncovered requests)"
)

# where the wrong loads land: a neighbour of the right skill, or somewhere unrelated?
misses = [
    (p["gold"], baseline[p["text"]]["loaded"][0])
    for p in POSITIVES
    if baseline[p["text"]]["loaded"] and baseline[p["text"]]["loaded"][0] != p["gold"]
]
same_category = sum(
    1
    for gold, got in misses
    if got in BY_NAME and BY_NAME[got]["category"] == BY_NAME[gold]["category"]
)
print(
    f"\nof {len(misses)} wrong first picks, {same_category} came from the right skill's own "
    f"category"
)
wrong loads 16.8% (315 covered requests)
needless loads 9.8% (173 uncovered requests)
of 36 wrong first picks, 10 came from the right skill's own categoryLas cargas erróneas terminan en la categoría propia de la habilidad correcta con mucha más frecuencia de lo que el azar indicaría, por lo que la parte difícil es distinguir algunos similares entre sí. El agente ya está buscando en el lugar aproximadamente correcto.
Paso 3: clasificar todo el plantel
Una solicitud conlleva dos tipos de pregunta:
whiches una pregunta deChoicesobre los 182 nombres de habilidades, con la descripción del índice como criterio de cada opción (el mismo texto que recibe el agente). Sus probabilidades son el ranking.- tres preguntas de
Noulsobre la solicitud, impresas a continuación, preguntando cada una de una manera diferente si desea que se realice una acción en lugar de dar una explicación.prose_sufficescuenta a la inversa. Su media decide si sugerir algo o no, y por debajo de 0.30 no se sugiere nada.
Ambos se envían en una sola solicitud, por lo que la clasificación y la verificación cuestan un solo ida y vuelta.
Escribe estas tres para preguntar si se desea realizar una acción. Una pregunta sobre la materia no separará explicar qué es una mónada de una solicitud que requiere una habilidad, ya que ambas son software.
Una sola Choice pregunta mantiene cómodamente una lista de este tamaño. Unas pocas veces más grande y la dividirías en fragmentos y clasificarías cada uno, luego ejecutarías este mismo paso de lista corta sobre los ganadores.
CHOICE_INSTRUCTIONS = (
    "Which of these skills, if any, is the right one to load to help with the "
    "user's latest request?"
)
GATE_QUESTIONS = {
    "acts_on_user_system": (
        "Is the assistant being asked to act on the user's files, accounts, devices, "
        "or online services, rather than only to explain or advise?"
    ),
    "would_follow_documented_procedure": (
        "Would a careful expert answering this consult a specific documented procedure "
        "or set of commands, rather than answering from general understanding?"
    ),
    "prose_suffices": (
        "Could a knowledgeable generalist fully satisfy this request in prose, with "
        "no tools, no documentation, and no access to the user's files or accounts?"
    ),
}
INVERTED = {"prose_suffices"}  # a yes here points away from needing a skill


def build_state(request: str) -> dict:
    return {"request": request, "recent_context": ""}


@json_cache
def rank_wide(request: str) -> dict:
    """Request 1: rank all 182 skills, and score the request for whether a skill applies."""
    questions = {
        "which": Choice(
            instructions=CHOICE_INSTRUCTIONS,
            criteria={skill["name"]: skill["description"] for skill in ROSTER},
        )
    }
    for key, text in GATE_QUESTIONS.items():
        questions[f"gate::{key}"] = Noul(instructions=text)
    started = perf_counter()
    response = client.system_one(
        state=build_state(request), questions=questions, model=TYPESAFE_MODEL
    )
    ranked = sorted(
        response.answers["which"].probabilities.items(), key=lambda kv: -kv[1]
    )
    values = {
        key.removeprefix("gate::"): answer.noul
        for key, answer in response.answers.items()
        if key.startswith("gate::")
    }
    oriented = [(1.0 - v) if k in INVERTED else v for k, v in values.items()]
    return {
        "ranked": ranked[
            :12
        ],  # more than any shortlist needs, and keeps the cache small
        "gate": sum(oriented) / len(oriented),
        "values": values,
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


DEMO = [
    "Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so it syncs"
    " to my phone? Just write it up in whatever editor pops up.",
    "Can you put together a pitch deck skeleton (cover, situation overview, comps, precedent"
    " transactions, DCF, LBO) as a .pptx, using our firm-template.pptx for branding and"
    " footnoting each valuation number back to the cell it came from in the model?",
    "Post this announcement to my Mastodon account.",
]
for request in DEMO:
    wide = rank_wide(request)
    verdict = "suggest" if wide["gate"] >= GATE_THRESHOLD else "stay quiet"
    print(f'"{request[:78]}"')
    print(f"  needs a skill {wide['gate']:.2f} -> {verdict}   ({wide['seconds']}s)")
    for name, probability in wide["ranked"][:SHORTLIST]:
        print(f"    {probability:.3f}  {name:<38}{BY_NAME[name]['description']}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
needs a skill 0.75 -> suggest (0.31s)
0.990 apple-notes Manage Apple Notes via memo CLI: create, search, edit.
0.010 computer-use Drive the user's desktop in the background — clicking, ty...
0.000 concept-diagrams Generate flat, minimal educational SVG visuals as HTML.
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
needs a skill 0.76 -> suggest (0.16s)
0.700 powerpoint Create, read, edit .pptx decks, slides, notes, templates.
0.300 pptx-author Build PowerPoint decks headless with python-pptx.
0.000 chroma Embedding database for RAG and semantic search.
"Post this announcement to my Mastodon account."
needs a skill 0.78 -> suggest (0.16s)
0.550 xurl X/Twitter via xurl CLI: raw post search, posting, DM, media.
0.140 computer-use Drive the user's desktop in the background — clicking, ty...
0.080 openhands Delegate coding to OpenHands CLI (model-agnostic, LiteLLM).La solicitud de Notes.app es inequívoca, y su primera opción es la correcta. Nada que pueda hacer un ranking salvará la de Mastodon: las tres preguntas indican que se necesita una habilidad, porque publicar en una cuenta es una acción, y con una habilidad para publicar en X y ninguna para Mastodon, la habilidad más cercana gana de todos modos.
Esto deja la baraja. Ambos líderes tienen .pptx habilidades, y en 60 caracteres la pregunta amplia de Choice
coloca la habilidad de edición por delante de la de autoría, para una solicitud sobre
autorar una presentación.
Paso 4: reordenar los tres primeros
Tres opciones dejan espacio para la descripción completa más la apertura de cada habilidad propia
SKILL.md, por lo que la segunda solicitud plantea la misma pregunta a una evidencia mejor:
whiches una preguntaChoicesobre la lista corta, con ese texto más largo como criterio de cada opción.fits::{name}es una preguntaNoulpor candidato: ¿hace esta habilidad la cosa específica que pide la solicitud? Cada una se responde por separado, por lo que todas pueden devolver valores bajos, y una lista corta cuyo máximo esté por debajo de 0,30 se elimina por completo.
RERANK_INSTRUCTIONS = (
    "Exactly one of these skills is the right one to load for the user's latest "
    "request. Which one? Read what each actually does, not just its name."
)


def rerank_criteria(names: tuple[str, ...], excerpt: int) -> dict[str, str]:
    return {
        name: f"{BY_NAME[name]['description_full']} — {BY_NAME[name]['body'][:excerpt]}"
        for name in names
    }


def rerank_questions(names: tuple[str, ...], excerpt: int) -> dict:
    questions = {
        "which": Choice(
            instructions=RERANK_INSTRUCTIONS, criteria=rerank_criteria(names, excerpt)
        )
    }
    for name in names:
        questions[f"fits::{name}"] = Noul(
            instructions=(
                f"Does the skill '{name}' do the specific thing the user's request asks "
                f"for? It is described as: {BY_NAME[name]['description_full']}"
            )
        )
    return questions


@json_cache
def rerank(request: str, names: tuple[str, ...], excerpt: int) -> dict:
    """Request 2: the same Choice over a shortlist, plus one absolute noul per candidate."""
    started = perf_counter()
    response = client.system_one(
        state=build_state(request),
        questions=rerank_questions(names, excerpt),
        model=TYPESAFE_MODEL,
    )
    return {
        "winner": response.answers["which"].choice,
        "fits": {
            key.removeprefix("fits::"): answer.noul
            for key, answer in response.answers.items()
            if key.startswith("fits::")
        },
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


for request in DEMO:
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        print(f'"{request[:78]}"\n  scored too low, nothing suggested\n')
        continue
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    best = max(result["fits"].values())
    verdict = result["winner"] if best >= FITS_THRESHOLD else "nothing fits"
    print(f'"{request[:78]}"')
    print(f"  was {shortlist[0]} -> {verdict}   ({result['seconds']}s)")
    for name in shortlist:
        print(f"    fits {result['fits'][name]:.2f}  {name}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
was apple-notes -> apple-notes (0.12s)
fits 0.60 apple-notes
fits 0.54 computer-use
fits 0.01 concept-diagrams
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
was powerpoint -> pptx-author (0.09s)
fits 0.73 powerpoint
fits 0.38 pptx-author
fits 0.02 chroma
"Post this announcement to my Mastodon account."
was xurl -> xurl (0.09s)
fits 0.56 xurl
fits 0.38 computer-use
fits 0.05 openhandsLos dos .pptx habilidades se separan una vez que cada una aporta su propio texto: la solicitud de la baraja cambia
a la habilidad de autoría.
Los fits noul y la Choice discrepan en esto: los noul puntúan más alto la habilidad de edición, mientras que la Choice elige la de autoría. Están decidiendo cosas distintas. La Choice resuelve cuál habilidad, y los noul resuelven si decir algo o no.
La solicitud de Mastodon supera ambas comprobaciones: su mejor fits noul supera 0.30, por lo que la receta sugiere la habilidad X para una solicitud sobre Mastodon. La mayoría de las solicitudes similares son detectadas.
La segunda pasada solo puede rechazar lo que le entrega el ranking amplio, y en este caso fueron tres casos cercanos.
La función siguiente es la receta completa: dos solicitudes y dos umbrales, con como máximo un nombre de habilidad que se devuelva.
Para apuntarlo a tu propia lista, reemplaza hermes_roster.json. Cada pregunta anterior lee name, description, description_full y body de ese archivo, y nada más
conoce a Hermes.
def suggest(request: str) -> tuple[str, ...]:
    """At most one skill name for a request, or () for "nothing here applies"."""
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        return ()
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    if max(result["fits"].values()) < FITS_THRESHOLD:
        return ()
    return (result["winner"],)


def suggestion_block(names: tuple[str, ...]) -> str:
    """What gets appended after the roster, in the suggestion.

    This string is a measured input rather than prose: it goes to the agent, so it is part
    of every graded turn's cache key. Editing a word here silently invalidates the shipped
    results and costs a live re-run to restore them.
    """
    body = (
        f"Relevant to the current request: {', '.join(names)}. Ignore this if it does not "
        "fit what the user actually asked for."
        if names
        else "No skill in the roster appears relevant to this request."
    )
    return f"\n\n<skill_relevance>\n{body}\n</skill_relevance>"


print(suggestion_block(suggest(DEMO[1])))
print(suggestion_block(suggest(DEMO[2])))
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>


<skill_relevance>
Relevant to the current request: xurl. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>
Paso 5: medir la sugerencia
Cada una de las 488 solicitudes se envía al agente tres veces, un turno medido cada una. Las ejecuciones difieren únicamente en lo que se le dice al agente:
| lo que va en el prompt del sistema | |
|---|---|
| agente solo | nada |
| agente con una sugerencia | lo que suggest() devolvió |
| agente con la respuesta | el nombre de la habilidad que cubre, o “nothing applies” cuando no hay ninguna |
El tercero no es alcanzable; es el techo contra el que se miden los otros dos.
La redacción de esa sugerencia cumple dos funciones. Indica que la sugerencia puede ignorarse, porque insistir más logra la conformidad incluso en sugerencias erróneas, y una errónea es peor que ninguna. Y un turno sin nada que sugerir aún envía una frase que lo indica; no enviar nada en absoluto dejaría sin oposición la instrucción del roster de “decantarse por cargar”.
texts = [request["text"] for request in REQUESTS]
with ThreadPoolExecutor(max_workers=WORKERS) as pool:  # up to 488 x 2 TypeSafe requests
    suggested = dict(zip(texts, pool.map(suggest, texts)))
WIDE = {text: rank_wide(text) for text in texts}  # all cache hits now; reused below

arms = {
    "baseline": {},
    "TypeSafe": {
        request["text"]: suggestion_block(suggested[request["text"]])
        for request in REQUESTS
    },
    "oracle": {
        request["text"]: suggestion_block((request["gold"],) if request["gold"] else ())
        for request in REQUESTS
    },
}
scores = {
    arm: summarise(run_arm(arm, suggestions)) for arm, suggestions in arms.items()
}

print(f"{'run':<10}{'wrong loads':>13}{'needless loads':>16}")
for arm, row in scores.items():
    print(f"{arm:<10}{row['wrong_load']:>13.1%}{row['needless_load']:>16.1%}")


def fewer(metric: str) -> str:
    """The plain ratio between the two arms' error rates."""
    return f"{scores['baseline'][metric] / scores['TypeSafe'][metric]:.1f}x fewer"


print(
    f"\nbaseline -> TypeSafe:  {fewer('wrong_load')} wrong loads, "
    f"{fewer('needless_load')} needless ones"
)
run wrong loads needless loads
baseline 16.8% 9.8%
TypeSafe 7.3% 4.0%
oracle 2.5% 1.2%
baseline -> TypeSafe: 2.3x fewer wrong loads, 2.4x fewer needless onesmoved = [
(
baseline[p["text"]]["loaded"][:1] == [p["gold"]],
run_turn(AGENT_MODEL, "TypeSafe", p["text"], arms["TypeSafe"][p["text"]])[
"loaded"
][:1]
== [p["gold"]],
)
for p in POSITIVES
]
print(
f"of {len(POSITIVES)} covered requests: {sum(not b and a for b, a in moved)} the suggestion "
f"fixed, {sum(b and not a for b, a in moved)} it broke"
)of 315 covered requests: 37 the suggestion fixed, 7 it brokeLa sugerencia corrige muchas más peticiones de las que rompe, pero sí rompe algunas que el agente ya tenía bien por su cuenta. Una sugerencia errónea pero confiable es más persuasiva que no ofrecer ninguna sugerencia, que es el precio de colocarla delante del turno.
SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

ARM_COLOR = {"baseline": BLUE, "TypeSafe": ORANGE, "oracle": MUTED}


def style(ax):
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)


panels = [
    ("wrong_load", f"wrong loads\n{len(POSITIVES)} covered requests"),
    ("needless_load", f"needless loads\n{len(NEGATIVES)} uncovered requests"),
]
names = list(scores)
fig, axes = plt.subplots(1, 2, figsize=(8.4, 3.6), facecolor=SURFACE)
for ax, (metric, title) in zip(axes, panels):
    style(ax)
    ax.grid(axis="y", color=GRID, linewidth=0.8)
    values = [scores[arm][metric] for arm in names]
    bars = ax.bar(
        names,
        values,
        0.58,
        color=[ARM_COLOR[arm] for arm in names],
        # the oracle is a ceiling, not a competitor: gray, and hatched so it never depends
        # on colour alone
        hatch=["", "", "///"],
        edgecolor=SURFACE,
        linewidth=1.2,
    )
    ax.bar_label(
        bars,
        labels=[f"{v:.1%}" for v in values],
        padding=3,
        color=INK2,
        fontsize=9,
    )
    ax.set_title(title, loc="left", color=INK2, fontsize=9.5)
    ax.set_ylim(0, max(values) * 1.28)
    ax.yaxis.set_major_formatter(PercentFormatter(xmax=1, decimals=0))
    ax.set_ylabel("% of those requests - lower is better", color=INK2, fontsize=9)
fig.suptitle(
    f"Hermes' {len(ROSTER)}-skill roster, {len(REQUESTS)} requests, {AGENT_MODEL}",
    x=0.02,
    ha="left",
    color=INK,
    fontsize=11,
)
fig.tight_layout()
display(fig)
plt.close(fig)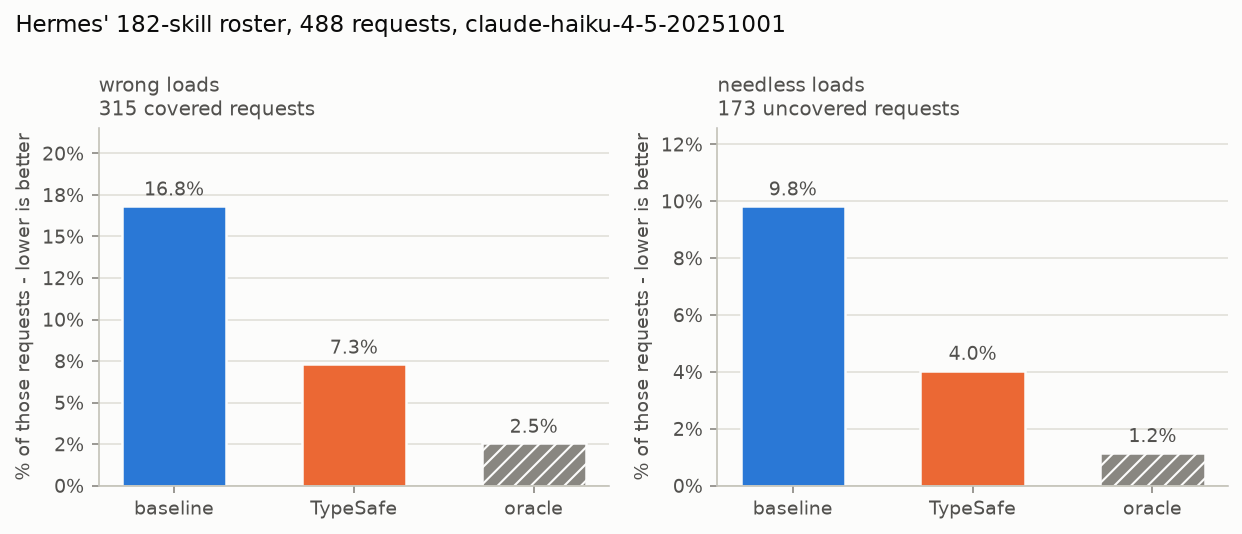
Lo que muestran los resultados
- Las cargas erróneas disminuyeron del 16,8 % al 7,3 % y las innecesarias del 9,8 % al 4,0 %, lo que explica la mayor parte de la brecha entre adivinar a partir de un índice truncado y recibir la respuesta directamente.
- Algunas peticiones que el agente acertaba por sí mismo pasan a fallar cuando se adjunta una sugerencia. Los conteos aparecen arriba.
Copia esta forma cuando un agente tuyo lleve un roster grande: una clasificación barata de todo, luego una mirada cercana a dos o tres. Cada paso puede volver con las manos vacías.
Ábrelo en el playground
Genera un enlace de playground para la solicitud del mazo del paso 4, utilizando la descripción completa y el fragmento del cuerpo de cada candidato como sus criterios.
demo_shortlist = tuple(name for name, _ in rank_wide(DEMO[1])["ranked"][:SHORTLIST])
playground_link = make_playground_link(
    build_state(DEMO[1]),
    rerank_questions(demo_shortlist, EXCERPT_CHARS),
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open the shortlist + questions in the TypeSafe playground]({playground_link})"
    )
)
Abre la lista corta + preguntas en el playground de TypeSafe →
Qué sigue
La misma forma aparece en otros lugares: Enrutamiento de Intención para el enrutamiento a un controlador en lugar de una habilidad, Confianza para seleccionar los dos umbrales, y Expansión Especulativa para colocar cada pregunta en una sola solicitud.