 JevCode
Extracción de valores preanalizados
Utiliza expresiones regulares para encontrar candidatos de correos electrónicos, números de teléfono y cantidades, luego tiene TypeSafe seleccionar el intervalo solicitado para que el código pueda normalizar un valor literal.
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

Una expresión regular encuentra los valores candidatos, TypeSafe selecciona el que la pregunta solicita, y el código lo copia textualmente.
El par find y pick de aquí es uno que puedes señalar en tus propios documentos, y tres casos trabajados muestran su uso: la dirección que un remitente quiere que se le envíe el recibo, un número de teléfono como +14155550177, y el total de una factura como 1315.50 USD marcado como un cargo.
TypeSafe selecciona una de las opciones que le proporcionas, por lo que los candidatos deben encontrarse primero. Una expresión regular los encuentra, TypeSafe selecciona uno y el código copia la selección, en tres pasos:
- Una expresión regular encuentra los valores candidatos en el texto. Ajústala para que sobreencuentre.
- TypeSafe selecciona qué candidato es el que pregunta la pregunta, y lee cualquier atributo que el código necesite más adelante (moneda, país, si un importe es un crédito o un cargo).
- El código copia el valor seleccionado y lo normaliza.
Dado que TypeSafe solo elige entre los fragmentos que encontró la expresión regular, el valor que obtienes es uno de esos fragmentos, copiado sin cambios. No puede inventar un valor ni transponer un dígito.
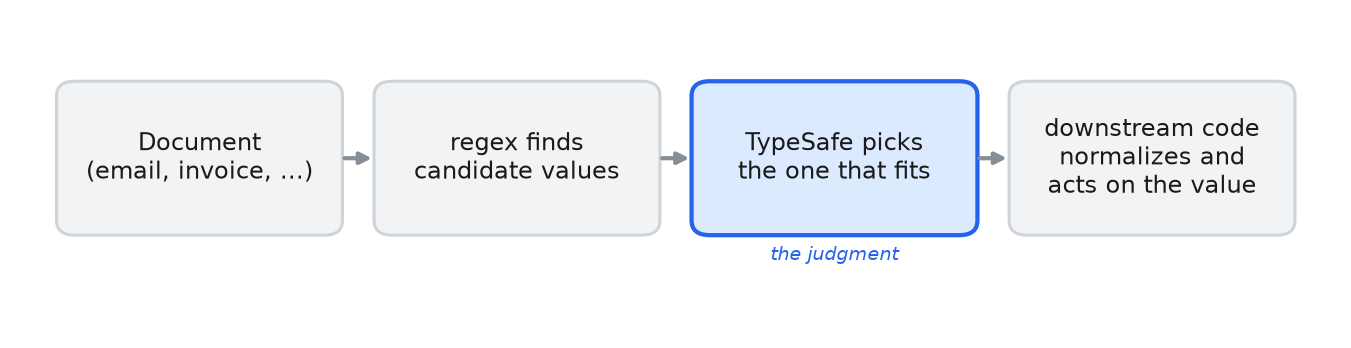
La expresión regular encuentra valores candidatos en el documento, TypeSafe selecciona uno y el código posterior lo normaliza y actúa en consecuencia.
Configuración
pip install ipython phonenumbers "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/luego establece TYPESAFE_API_KEY.
import os
import re
from decimal import Decimal
from pathlib import Path

import phonenumbers
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
NONE = "none"  # the escape hatch on every selection: "none of the candidates fits"

# base_url defaults to https://api.typesafe.ai/ ; the env override points at another deployment.
ts = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # cached re-renders need no key
    base_url=os.environ.get("TYPESAFE_BASE_URL"),
    timeout=30.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Ayudantes
find ejecuta una expresión regular ajustada para sobre-encontrar y deduplica las coincidencias. pick es una
Choice pregunta cuyas opciones son los fragmentos que find devuelve, por lo que su respuesta es uno de
esos fragmentos copiado exactamente, o none cuando ningún candidato encaja. classify es una
Choice pregunta sobre un conjunto fijo de etiquetas, utilizada aquí para la moneda y el
país.
is_true es un Noul, utilizado aquí para preguntar si un importe es un crédito.
Cada llamada se almacena en json_cache.json, por lo que volver a renderizar no realiza llamadas a la API.
EMAIL_RE = re.compile(r"[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}")
PHONE_RE = re.compile(r"\(?\+?\d[\d\s()\-.]{6,}\d")
MONEY_RE = re.compile(r"[$€£¥]\s?\d[\d,]*(?:\.\d{2})?")


def find(pattern: re.Pattern, text: str) -> list[str]:
    """Code-side candidate finder: recall-tuned regex, deduped, in document order."""
    seen: set[str] = set()
    out: list[str] = []
    for match in pattern.findall(text):
        span = match.strip()
        if span and span not in seen:
            seen.add(span)
            out.append(span)
    return out


@json_cache
def pick(document: str, candidates: list[str], question: str) -> dict:
    """TypeSafe selects which found span plays the role. Returns {choice, confidence}.

    The options ARE the candidate spans, so ``choice`` is a verbatim copy of one of them (or the
    ``none`` hatch) - the model chooses, code owns the string."""
    criteria = {c: None for c in candidates} | {
        NONE: "None of these is the requested value."
    }
    answer = ts.system_one(
        state=document,
        questions={"pick": Choice(instructions=question, criteria=criteria)},
        model=TYPESAFE_MODEL,
    ).answers["pick"]
    return {"choice": answer.choice, "confidence": answer.confidence}


@json_cache
def classify(document: str, question: str, options: list[str]) -> dict:
    """A small Choice over a fixed label set (currency, country, ...). Returns {choice, confidence}."""
    answer = ts.system_one(
        state=document,
        questions={
            "q": Choice(instructions=question, criteria={o: None for o in options})
        },
        model=TYPESAFE_MODEL,
    ).answers["q"]
    return {"choice": answer.choice, "confidence": answer.confidence}


@json_cache
def is_true(document: str, question: str) -> float:
    """A yes/no Noul. Returns P(yes)."""
    return (
        ts.system_one(
            state=document,
            questions={"q": Noul(instructions=question)},
            model=TYPESAFE_MODEL,
        )
        .answers["q"]
        .noul
    )
Correo: elige la dirección correcta según el rol
Cuatro direcciones en los encabezados. El cuerpo solicita que el recibo se envíe a una dirección personal en lugar del alias de facturación To:, por lo que la respuesta depende de leer el cuerpo.
Dos preguntas aquí: qué dirección recibe el recibo y cuál envió el mensaje.
EMAIL_DOC = """From: Dana Whit <[email protected]>
To: [email protected]
Cc: [email protected]
Reply-To: [email protected]

Hi team - please don't use the billing alias for this one. Send my receipt to my
personal address instead. Thanks, Dana."""

emails = find(EMAIL_RE, EMAIL_DOC)
receipt = pick(
    EMAIL_DOC, emails, "Which email address does the sender want their receipt sent to?"
)
sender = pick(
    EMAIL_DOC, emails, "Which email address did this message come from (the From line)?"
)

print("candidates :", emails)
# code copies the picked value verbatim and normalizes (lowercase); it never re-types it
print(
    f"receipt -> : {receipt['choice'].lower():<28} (conf {receipt['confidence']:.2f})"
)
print(f"sender  -> : {sender['choice'].lower():<28} (conf {sender['confidence']:.2f})")
candidates : ['[email protected]', '[email protected]', '[email protected]', '[email protected]']
receipt -> : [email protected] (conf 0.98)
sender -> : [email protected] (conf 1.00)receipt es la dirección de Gmail personal en la línea Reply-To:, que es lo que pide el cuerpo; sender es la que está en la línea From. Ambas son copias de coincidencias de regex, convertidas a minúsculas en el código.
Teléfono: selecciona el móvil, normaliza a E.164
Tres números, ninguno de ellos con código de país. TypeSafe selecciona el móvil y lee el país a partir del texto; phonenumbers combina esas dos respuestas en E.164, el formato internacional que comienza con un + y el código de país.
PHONE_DOC = """Reach our San Francisco office at these numbers: main desk (415) 555-0199,
billing fax (415) 555-0142, and my direct cell (415) 555-0177. Call the cell if it's urgent."""

phones = find(PHONE_RE, PHONE_DOC)
mobile = pick(PHONE_DOC, phones, "Which of these is the direct mobile / cell number?")
region = classify(
    PHONE_DOC,
    "In what country is this office located?",
    ["US", "GB", "DE", "FR", "CA", "AU"],
)

# code copies the picked value and normalizes it with the model-supplied country
parsed = phonenumbers.parse(mobile["choice"], region["choice"])
e164 = phonenumbers.format_number(parsed, phonenumbers.PhoneNumberFormat.E164)

print("candidates :", phones)
print(f"mobile  -> : {mobile['choice']}  (conf {mobile['confidence']:.2f})")
print(f"country -> : {region['choice']}  (conf {region['confidence']:.2f})")
print(f"E.164   -> : {e164}")
candidates : ['(415) 555-0199', '(415) 555-0142', '(415) 555-0177']
mobile -> : (415) 555-0177 (conf 1.00)
country -> : US (conf 0.90)
E.164 -> : +14155550177Nada en los dígitos indica cuál es el número de móvil ni en qué país se encuentra; lo hacen las palabras que los rodean. TypeSafe lee esas palabras y phonenumbers formatea el número seleccionado como +14155550177.
Dinero: elige la cantidad, clasifica la moneda, indica si es crédito o cargo
Una factura con cuatro importes. TypeSafe selecciona el total adeudado y el crédito, lee la moneda y marca cada importe seleccionado como un cargo o un crédito. El código copia cada cadena seleccionada y la analiza en un Decimal.
MONEY_DOC = """Invoice INV-2087.
Subtotal: $1,200.00
Sales tax: $115.50
Total due: $1,315.50
A $50.00 courtesy credit from last month has already been applied."""

amounts = find(MONEY_RE, MONEY_DOC)
currency = classify(
    MONEY_DOC,
    "What currency are these amounts in?",
    ["USD", "EUR", "GBP", "JPY", "CAD"],
)
total = pick(MONEY_DOC, amounts, "Which amount is the total the customer must pay?")
credit = pick(
    MONEY_DOC, amounts, "Which amount is the courtesy credit that was applied?"
)


def to_decimal(value: str) -> Decimal:
    """Copy the picked value and parse the number in code (US grouping/decimal here)."""
    return Decimal(re.sub(r"[^\d.]", "", value))


for label, chosen in [("total due", total), ("credit", credit)]:
    is_credit = is_true(
        MONEY_DOC,
        f"Is the amount {chosen['choice']} a credit or refund to the customer, not a charge?",
    )
    kind = "credit" if is_credit > 0.5 else "charge"
    print(
        f"{label:<10}: {chosen['choice']:<10} -> {to_decimal(chosen['choice'])} {currency['choice']} "
        f"({kind}, P(credit)={is_credit:.2f})"
    )
print("\ncandidates :", amounts)
total due : $1,315.50 -> 1315.50 USD (charge, P(credit)=0.01)
credit : $50.00 -> 50.00 USD (credit, P(credit)=0.99)
candidates : ['$1,200.00', '$115.50', '$1,315.50', '$50.00']El total adeudado es $1,315.50 y el crédito es $50.00, ambos en USD. El crédito-o-cargo
Noul responde 0.01 sobre el total y 0.99 sobre el crédito, por lo que el código conoce el
signo de cada Decimal que analiza.
to_decimalasume que la coma separa los miles y el punto es el separador decimal. Eso vale para$1,315.50; en€1.315,50es al revés. Haz una preguntaNoulsobre qué convención usa el documento, y ramifica el código en consecuencia.
Ábrelo en el playground de TypeSafe
Un enlace compartido que abre el hilo de correo electrónico en el navegador, con la pregunta de recibo en él y las cuatro direcciones que la expresión regular encontró entre sus opciones.
receipt_criteria = {e: None for e in emails} | {
    NONE: "None of these is the requested value."
}
playground_link = make_playground_link(
    EMAIL_DOC,
    {
        "receipt": Choice(
            instructions="Which email address does the sender want their receipt sent to?",
            criteria=receipt_criteria,
        )
    },
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this thread + selection in the TypeSafe playground]({playground_link})"
    )
)
Abre este hilo + la selección en el playground de TypeSafe →
Dos límites
- Una pregunta
Choicepermite como máximo 255 opciones. Con más candidatos que eso, estrecha en dos etapas: selecciona la sección primero, luego el fragmento dentro de ella. - Encontrar los candidatos es la parte que requiere trabajo. Los correos electrónicos, los números de teléfono y las cantidades tienen expresiones regulares que los cubren; un nombre no, por lo que sus candidatos deben provenir de una lista que ya tengas, o de un reconocedor de entidades nombradas o de un LLM que los proponga. TypeSafe luego selecciona el que la pregunta solicita.