 JevCode
Extração de valor pré-analisado
Utiliza expressões regulares para encontrar candidatos a e-mails, números de telefone e valores, e então o TypeSafe seleciona o span solicitado para que o código possa normalizar um valor literal.
Traduzido automaticamente do en, sem revisão. Apenas como referência rápida.

Uma regex encontra os valores candidatos, o TypeSafe escolhe aquele que a pergunta pede, e o código o copia literalmente.
O par find e pick aqui é algo que você pode apontar em seus próprios documentos, e três casos trabalhados mostram seu uso: o endereço que um remetente deseja que seu recibo seja enviado, um número de telefone como +14155550177 e o total de uma fatura como 1315.50 USD sinalizado como uma cobrança.
O TypeSafe escolhe uma das opções que você lhe fornece, então os candidatos precisam ser encontrados primeiro. Uma regex os encontra, o TypeSafe escolhe um, e o código copia a escolha, em três etapas:
- Uma regex encontra os valores candidatos no texto. Ajuste-a para encontrar em excesso.
- O TypeSafe seleciona qual candidato a pergunta está buscando e extrai qualquer atributo que o código precise posteriormente (moeda, país, se um valor é um crédito ou um débito).
- O código copia o valor selecionado e o normaliza.
Como o TypeSafe só escolhe entre os trechos que a expressão regular encontrou, o valor que você recebe é um desses trechos, copiado sem alterações. Ele não pode inventar um valor nem transpor um dígito.
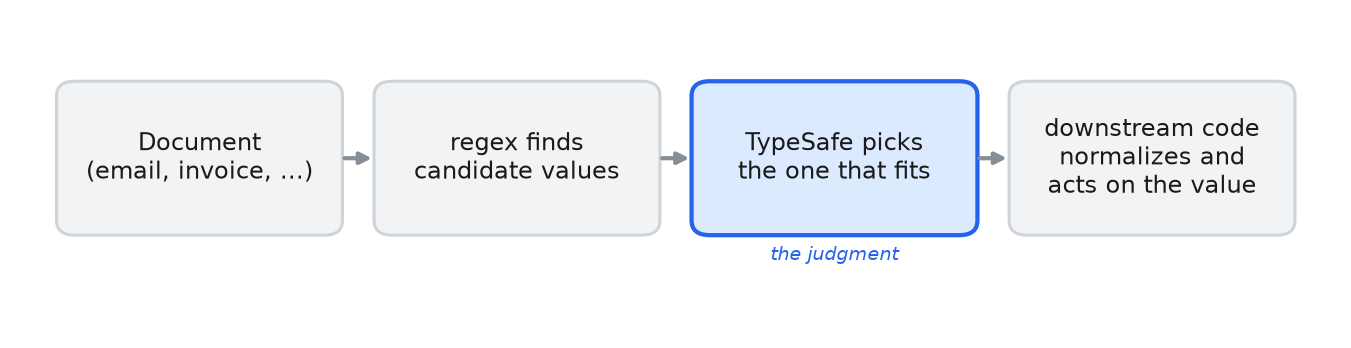
A regex encontra valores candidatos no documento, o TypeSafe escolhe um e o código downstream normaliza-o e age com base nele.
Configuração
pip install ipython phonenumbers "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/então defina TYPESAFE_API_KEY.
import os
import re
from decimal import Decimal
from pathlib import Path

import phonenumbers
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
NONE = "none"  # the escape hatch on every selection: "none of the candidates fits"

# base_url defaults to https://api.typesafe.ai/ ; the env override points at another deployment.
ts = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # cached re-renders need no key
    base_url=os.environ.get("TYPESAFE_BASE_URL"),
    timeout=30.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Ajudantes
find executa uma regex ajustada para superdetectar e remove duplicatas das correspondências. pick é uma
Choice pergunta cujas opções são os trechos que find retorna, então sua resposta é um desses
trechos copiados exatamente, ou none quando nenhum candidato se encaixa. classify é uma
Choice pergunta sobre um conjunto fixo de rótulos, usada aqui para a moeda e o
país.
is_true é um Noul, usado aqui para perguntar se um valor é um crédito.
Cada chamada é armazenada em cache em json_cache.json, portanto, o novo renderização não realiza chamadas de API.
EMAIL_RE = re.compile(r"[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}")
PHONE_RE = re.compile(r"\(?\+?\d[\d\s()\-.]{6,}\d")
MONEY_RE = re.compile(r"[$€£¥]\s?\d[\d,]*(?:\.\d{2})?")


def find(pattern: re.Pattern, text: str) -> list[str]:
    """Code-side candidate finder: recall-tuned regex, deduped, in document order."""
    seen: set[str] = set()
    out: list[str] = []
    for match in pattern.findall(text):
        span = match.strip()
        if span and span not in seen:
            seen.add(span)
            out.append(span)
    return out


@json_cache
def pick(document: str, candidates: list[str], question: str) -> dict:
    """TypeSafe selects which found span plays the role. Returns {choice, confidence}.

    The options ARE the candidate spans, so ``choice`` is a verbatim copy of one of them (or the
    ``none`` hatch) - the model chooses, code owns the string."""
    criteria = {c: None for c in candidates} | {
        NONE: "None of these is the requested value."
    }
    answer = ts.system_one(
        state=document,
        questions={"pick": Choice(instructions=question, criteria=criteria)},
        model=TYPESAFE_MODEL,
    ).answers["pick"]
    return {"choice": answer.choice, "confidence": answer.confidence}


@json_cache
def classify(document: str, question: str, options: list[str]) -> dict:
    """A small Choice over a fixed label set (currency, country, ...). Returns {choice, confidence}."""
    answer = ts.system_one(
        state=document,
        questions={
            "q": Choice(instructions=question, criteria={o: None for o in options})
        },
        model=TYPESAFE_MODEL,
    ).answers["q"]
    return {"choice": answer.choice, "confidence": answer.confidence}


@json_cache
def is_true(document: str, question: str) -> float:
    """A yes/no Noul. Returns P(yes)."""
    return (
        ts.system_one(
            state=document,
            questions={"q": Noul(instructions=question)},
            model=TYPESAFE_MODEL,
        )
        .answers["q"]
        .noul
    )
Email: escolha o endereço certo por função
Quatro endereços nos cabeçalhos. O corpo pede que o recibo seja enviado para um endereço pessoal em vez do To: alias de cobrança, então a resposta depende de ler o corpo.
Duas perguntas aqui: qual endereço recebe o recibo e qual enviou a mensagem.
EMAIL_DOC = """From: Dana Whit <[email protected]>
To: [email protected]
Cc: [email protected]
Reply-To: [email protected]

Hi team - please don't use the billing alias for this one. Send my receipt to my
personal address instead. Thanks, Dana."""

emails = find(EMAIL_RE, EMAIL_DOC)
receipt = pick(
    EMAIL_DOC, emails, "Which email address does the sender want their receipt sent to?"
)
sender = pick(
    EMAIL_DOC, emails, "Which email address did this message come from (the From line)?"
)

print("candidates :", emails)
# code copies the picked value verbatim and normalizes (lowercase); it never re-types it
print(
    f"receipt -> : {receipt['choice'].lower():<28} (conf {receipt['confidence']:.2f})"
)
print(f"sender  -> : {sender['choice'].lower():<28} (conf {sender['confidence']:.2f})")
candidates : ['[email protected]', '[email protected]', '[email protected]', '[email protected]']
receipt -> : [email protected] (conf 0.98)
sender -> : [email protected] (conf 1.00)receipt é o endereço Gmail pessoal na linha Reply-To:, que é o que o corpo solicita; sender é o da linha From. Ambos são cópias de correspondências de regex, convertidos para minúsculas no código.
Telefone: selecione o móvel, normalizar para E.164
Três números, nenhum deles com código de país. O TypeSafe seleciona o móvel e lê o país a partir do texto; phonenumbers combina essas duas respostas em E.164, o formato internacional que começa com um + e o código do país.
PHONE_DOC = """Reach our San Francisco office at these numbers: main desk (415) 555-0199,
billing fax (415) 555-0142, and my direct cell (415) 555-0177. Call the cell if it's urgent."""

phones = find(PHONE_RE, PHONE_DOC)
mobile = pick(PHONE_DOC, phones, "Which of these is the direct mobile / cell number?")
region = classify(
    PHONE_DOC,
    "In what country is this office located?",
    ["US", "GB", "DE", "FR", "CA", "AU"],
)

# code copies the picked value and normalizes it with the model-supplied country
parsed = phonenumbers.parse(mobile["choice"], region["choice"])
e164 = phonenumbers.format_number(parsed, phonenumbers.PhoneNumberFormat.E164)

print("candidates :", phones)
print(f"mobile  -> : {mobile['choice']}  (conf {mobile['confidence']:.2f})")
print(f"country -> : {region['choice']}  (conf {region['confidence']:.2f})")
print(f"E.164   -> : {e164}")
candidates : ['(415) 555-0199', '(415) 555-0142', '(415) 555-0177']
mobile -> : (415) 555-0177 (conf 1.00)
country -> : US (conf 0.90)
E.164 -> : +14155550177Nenhum dos dígitos indica qual é o número de celular ou em que país ele está; são as palavras ao redor que dizem isso. O TypeSafe lê essas palavras, e phonenumbers formata o número escolhido como +14155550177.
Dinheiro: escolha o valor, classifique a moeda, sinalize crédito versus débito
Uma fatura com quatro valores. O TypeSafe seleciona o total devido e o crédito, lê a moeda e sinaliza cada valor selecionado como uma cobrança ou um crédito. O código copia cada string selecionada e a analisa em um Decimal.
MONEY_DOC = """Invoice INV-2087.
Subtotal: $1,200.00
Sales tax: $115.50
Total due: $1,315.50
A $50.00 courtesy credit from last month has already been applied."""

amounts = find(MONEY_RE, MONEY_DOC)
currency = classify(
    MONEY_DOC,
    "What currency are these amounts in?",
    ["USD", "EUR", "GBP", "JPY", "CAD"],
)
total = pick(MONEY_DOC, amounts, "Which amount is the total the customer must pay?")
credit = pick(
    MONEY_DOC, amounts, "Which amount is the courtesy credit that was applied?"
)


def to_decimal(value: str) -> Decimal:
    """Copy the picked value and parse the number in code (US grouping/decimal here)."""
    return Decimal(re.sub(r"[^\d.]", "", value))


for label, chosen in [("total due", total), ("credit", credit)]:
    is_credit = is_true(
        MONEY_DOC,
        f"Is the amount {chosen['choice']} a credit or refund to the customer, not a charge?",
    )
    kind = "credit" if is_credit > 0.5 else "charge"
    print(
        f"{label:<10}: {chosen['choice']:<10} -> {to_decimal(chosen['choice'])} {currency['choice']} "
        f"({kind}, P(credit)={is_credit:.2f})"
    )
print("\ncandidates :", amounts)
total due : $1,315.50 -> 1315.50 USD (charge, P(credit)=0.01)
credit : $50.00 -> 50.00 USD (credit, P(credit)=0.99)
candidates : ['$1,200.00', '$115.50', '$1,315.50', '$50.00']O total devido é $1.315,50 e o crédito é $50,00, ambos em USD. O crédito-ou-carga
Noul responde 0,01 no total e 0,99 no crédito, então o código conhece o
sinal de cada Decimal que analisa.
to_decimalassume que a vírgula agrupa milhares e o ponto é o separador decimal. Isso vale para$1,315.50; em€1.315,50é o contrário. Faça uma perguntaNoulsobre qual convenção o documento usa e faça a ramificação no código.
Abra no playground TypeSafe
Um link de compartilhamento que abre o encadeamento de e-mails no navegador, com a pergunta de recibo nele e os quatro endereços que a regex encontrou entre suas opções.
receipt_criteria = {e: None for e in emails} | {
    NONE: "None of these is the requested value."
}
playground_link = make_playground_link(
    EMAIL_DOC,
    {
        "receipt": Choice(
            instructions="Which email address does the sender want their receipt sent to?",
            criteria=receipt_criteria,
        )
    },
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this thread + selection in the TypeSafe playground]({playground_link})"
    )
)
Abra este tópico + a seleção no playground TypeSafe →
Dois limites
- Uma pergunta
Choicepermite no máximo 255 opções. Com mais candidatos do que isso, reduza em duas etapas: selecione a seção primeiro, depois o trecho dentro dela. - Encontrar os candidatos é a parte que exige trabalho. E-mails, números de telefone e valores têm expressões regulares que os cobrem; um nome não, então seus candidatos precisam vir de uma lista que você já possui, ou de um reconhecedor de entidades nomeadas ou de um LLM que os propõe. TypeSafe então escolhe aquele que a pergunta solicita.