 JevCode
Chamada de função
Transforma solicitações de negociação em linguagem natural em chamadas a funções tipadas comuns, mapeando nomes de funções e argumentos de conjunto fechado para perguntas TypeSafe com consciência de confiança.
Traduzido automaticamente do en, sem revisão. Apenas como referência rápida.

Quando você pede um “latte gelado de aveia grande, sem adoçante”, o barista não anota sua frase. Ele marca quatro opções em um copo. Este livro de receitas faz o mesmo para uma API de negociação: uma frase entra, e sai um nome de função e seus argumentos como enums avaliados, cada um com uma confiança.
"plot rolling correlation between nvda and spy for the past month"
    rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo')   confidence 0.91

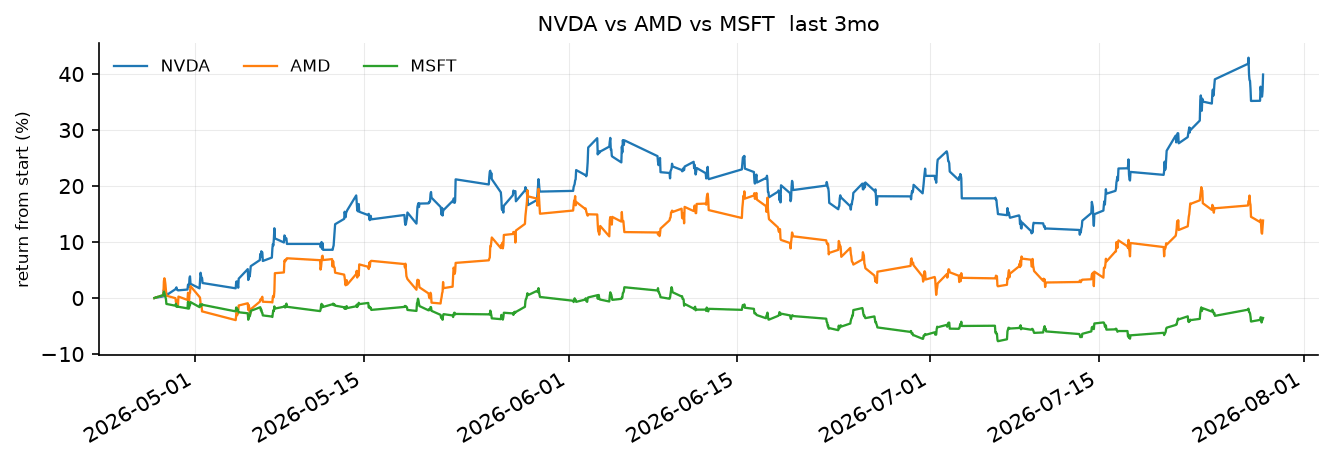
"compare nvda amd and msft over the past three months"
    compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo')      confidence 0.94

"show me apple daily with volume"
    plot_price(symbol='AAPL', resolution='1d', include_volume=True)     confidence 0.75

"what tickers do you have"
    list_symbols()                                                     confidence 1.00
Essas chamadas vão para dez funções comuns em um assistente de negociação. Seus argumentos recebem valores de listas fixas, então eles são Literals já:
def plot_price(
    symbol: Literal["SPY", "NVDA", "AMD", "AAPL", "MSFT", "TSLA"],
    style: Literal["line", "candles"] = "line",
    resolution: Literal["1m", "5m", "15m", "1h", "1d"] = "15m",
    window: Literal["1d", "1w", "1mo", "3mo"] = "1w",
    include_volume: bool = False,
    moving_average: Literal["9", "20", "50"] | None = None,
    log_scale: bool = False,
): ...
Um argumento cujos valores provêm de uma lista fixa é um conjunto fechado. Quando ele assume um valor
desssa lista, ele recebe uma pergunta Choice sobre exatamente esses valores, então o que
chega à função é um valor que a função aceita. Você deixa as funções de lado. O que
você adiciona é uma especificação que diz em palavras simples o que cada argumento significa. No final, você tem um
Dispatcher que você pode apontar para suas próprias funções.
Configuração
pip install ipython polars matplotlib numpy "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Defina TYPESAFE_API_KEY. Dois módulos ficam ao lado deste arquivo. trader.py contém as dez
funções, além de um cliente TypeSafe que lê respostas de um cache, então o re-renderização reproduz
os números abaixo sem chamar a API. dispatch.py contém o código que lê uma
assinatura e uma especificação e faz a chamada.
import json
from pathlib import Path

from cooksafe import make_playground_link
from dispatch import ROUTE, Dispatcher, closed_sets
from IPython.display import Markdown, display
from trader import TOOLS, client, load

TYPESAFE_MODEL = "jev-1.12"
print(f"{len(TOOLS)} functions over {load().height:,} one-minute bars")
10 functions over 156,780 one-minute barsEncontre os conjuntos fechados nas assinaturas
As dicas de tipo já indicam quais argumentos vêm de uma lista fixa e o que há em cada
lista. closed_sets lê uma assinatura e organiza esses argumentos em três formas: uma
escolha (um Literal, ou seja, um valor da lista), um conjunto (um list[Literal[...]],
ou seja, qualquer número deles) ou um flag (um bool, ou seja, ligado ou desligado). Todas as dez funções são
definidas em trader.py.
for name, fn in TOOLS.items():
    shapes = closed_sets(fn)
    print(
        f"  {name:<20}{len(shapes)}  "
        + ", ".join(f"{a}:{s}" for a, (s, _) in shapes.items())
    )
print(
    f"\n{sum(len(closed_sets(fn)) for fn in TOOLS.values())} fillable arguments in total"
)
list_symbols 0
market_summary 1 window:choice
plot_price 7 symbol:choice, style:choice, resolution:choice, window:choice, include_volume:flag, moving_average:choice, log_scale:flag
intraday_pattern 3 symbol:choice, window:choice, metric:choice
compare_returns 3 symbols:set, window:choice, normalize:flag
rolling_correlation 4 symbol:choice, benchmark:choice, window:choice, resolution:choice
summary_stats 2 symbol:choice, window:choice
volatility 3 symbol:choice, window:choice, annualized:flag
top_movers 2 window:choice, direction:choice
drawdown 3 symbol:choice, window:choice, plot:flag
28 fillable arguments in totaltop_movers mostra o que é omitido. De seus três argumentos, dois são conjuntos fechados. O
terceiro, limit, é um int, portanto nunca recebe uma pergunta e mantém seu padrão de 3. Texto
livre, números e datas funcionam da mesma forma: sem pergunta, e o padrão da função permanece.
Escreva a especificação
O Literal fornece as strings "1mo" e "3mo". Ele não diz que um usuário digitando “este trimestre” significa o segundo. A especificação diz isso. Ela mantém uma pergunta por argumento, uma linha por opção, uma descrição por função e mais uma pergunta que escolhe entre as funções. Ela reside em spec.json, e um LLM pode escrevê-la para você a partir das assinaturas.
SPEC = json.loads(Path("spec.json").read_text())
for argument in ("style", "moving_average"):
    print(
        json.dumps(
            {argument: SPEC["functions"]["plot_price"]["arguments"][argument]}, indent=2
        )
    )
{
"style": {
"question": "Does the user want a plain line or candles?",
"stated": "Does the user say how the chart should be drawn, such as a line, candles, or OHLC bars?",
"options": {
"line": "a simple line through the closing prices",
"candles": "a candlestick or OHLC chart, showing each bar's open, high, low and close"
}
}
}
{
"moving_average": {
"question": "How many bars should the moving average cover - nine, twenty, or fifty?",
"stated": "Does the user ask for a moving average or a smoothed line over the candles?",
"options": {
"9": "a nine-bar moving average, a fast one",
"20": "a twenty-bar moving average",
"50": "a fifty-bar moving average, a slow one"
}
}
}As chaves de opção são as strings que a função recebe, portanto nada precisa mapear um rótulo de volta para um argumento depois. stated torna um argumento opcional. É uma segunda pergunta sim/não perguntando se o comando diz algo sobre esse argumento em tudo. Quando a resposta é não, a chamada omite esse argumento e o padrão próprio da função se aplica.
Um argumento de conjunto recebe sua pergunta uma vez por membro, com {} substituindo o nome do membro. "Does the user want {} in the comparison?" torna-se uma pergunta por ticker.
Escreva cada pergunta sobre a ideia em vez das palavras que um usuário pode escolher, porque a correspondência é baseada no significado: “is amd tracking nvidia lately” atinge rolling_correlation mesmo que nem tracking nem lately apareçam em spec.json. Evite nomear uma pergunta com base em seu parâmetro - "Which resolution?" não fornece ao comando nada contra o qual fazer a correspondência.
Transforme a especificação em perguntas
Dispatcher compila as perguntas a partir da especificação uma vez. Cada comando é então uma solicitação
carregando a escolha da função e os argumentos de todas as funções, e o despachante lê
apenas as respostas da função escolhida.
assistant = Dispatcher(SPEC, TOOLS, client)
print(f"{len(assistant.questions)} questions per command, among them:")
for qid in (
    "__tool__",
    "plot_price.style",
    "plot_price.style?",
    "compare_returns.symbols.NVDA",
):
    question = assistant.questions[qid]
    print(f"  {qid:<30}{question['type']:<8}{str(question['instructions'])[:64]}")
54 questions per command, among them:
__tool__ choice What is the user asking the trading assistant to do?
plot_price.style choice Does the user want a plain line or candles?
plot_price.style? noul Does the user say how the chart should be drawn, such as a line,
compare_returns.symbols.NVDA noul Does the user want NVDA in the comparison?Execute catorze comandos
Um pedido ocupa uma linha, e seu confidence é o julgamento menos certo por trás
daquela chamada.
COMMANDS = [
    "show nvda 1h",
    "plot rolling correlation between nvda and spy for the past month",
    "when during the day does nvda trade the most",
    "what moved today",
    "what tickers do you have",
    "how did the market do this week",
    "candles for tesla with a 20 period moving average",
    "compare nvda amd and msft over the past three months",
    "how volatile is tsla",
    "biggest losers today",
    "worst drawdown for nvda this quarter, and chart it please",
    "spy stats for the last month",
    "show me apple daily with volume",
    "is amd tracking nvidia lately",
]

CALLS = {command: assistant(command) for command in COMMANDS}
for command, call in CALLS.items():
    print(f'  "{command}"')
    print(
        f"      {str(call):<66}confidence {call.confidence:.2f}"
        f"   tool {call.tool.probability:.2f}"
    )
"show nvda 1h"
plot_price(symbol='NVDA', resolution='1h') confidence 0.78 tool 1.00
"plot rolling correlation between nvda and spy for the past month"
rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo') confidence 0.91 tool 1.00
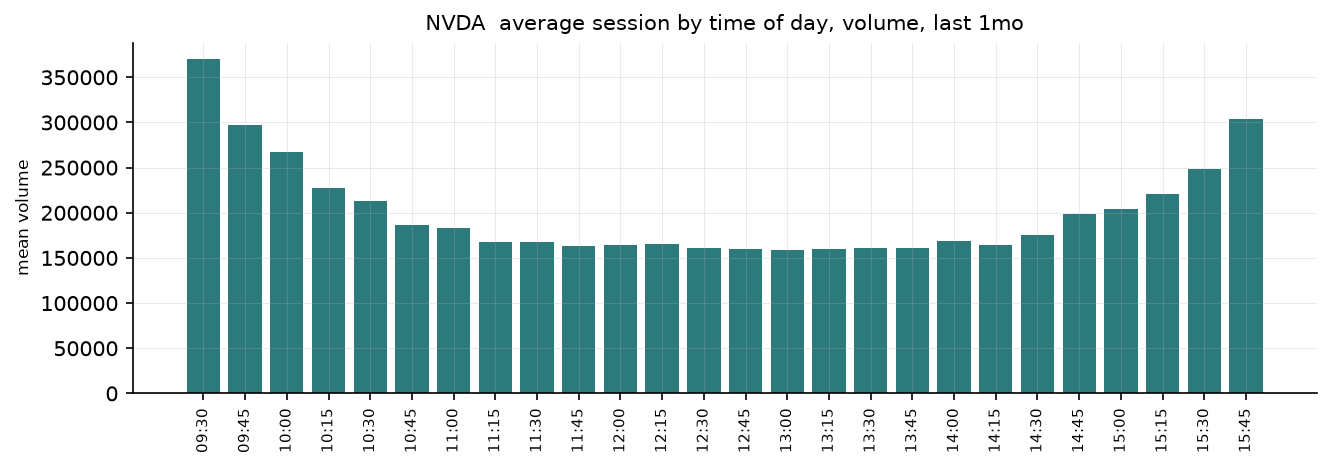
"when during the day does nvda trade the most"
intraday_pattern(symbol='NVDA') confidence 0.53 tool 1.00
"what moved today"
top_movers(window='1d', direction='gainers') confidence 0.90 tool 0.90
"what tickers do you have"
list_symbols() confidence 1.00 tool 1.00
"how did the market do this week"
market_summary(window='1w') confidence 0.96 tool 0.99
"candles for tesla with a 20 period moving average"
plot_price(symbol='TSLA', style='candles', moving_average='20') confidence 0.69 tool 0.97
"compare nvda amd and msft over the past three months"
compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo') confidence 0.94 tool 1.00
"how volatile is tsla"
volatility(symbol='TSLA') confidence 0.96 tool 1.00
"biggest losers today"
top_movers(window='1d', direction='losers') confidence 0.98 tool 0.98
"worst drawdown for nvda this quarter, and chart it please"
drawdown(symbol='NVDA', window='3mo', plot=True) confidence 0.84 tool 0.84
"spy stats for the last month"
summary_stats(symbol='SPY', window='1mo') confidence 0.88 tool 0.88
"show me apple daily with volume"
plot_price(symbol='AAPL', resolution='1d', include_volume=True) confidence 0.75 tool 0.85
"is amd tracking nvidia lately"
rolling_correlation(symbol='AMD', benchmark='NVDA') confidence 0.82 tool 0.82Ambos os comandos longos saíram conforme solicitado. “plot rolling correlation between nvda and spy for the past month” preencheu quatro argumentos a partir de uma única frase. Dois deles, symbol e benchmark, extraem dos mesmos seis tickers, e cada ticker foi alocado no argumento correto porque as perguntas especificam os papéis: o que está sendo medido, mencionado primeiro contra o segundo mencionado, a referência. “compare nvda amd and msft over the past three months” colocou três tickers no conjunto e deixou os outros três de fora.
Executando três deles:
for command in (
    "plot rolling correlation between nvda and spy for the past month",
    "compare nvda amd and msft over the past three months",
    "when during the day does nvda trade the most",
):
    print(f'"{command}"  ->  {CALLS[command]}')
    display(CALLS[command].run())
"plot rolling correlation between nvda and spy for the past month" -> rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo')
"compare nvda amd and msft over the past three months" -> compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo')
"when during the day does nvda trade the most" -> intraday_pattern(symbol='NVDA')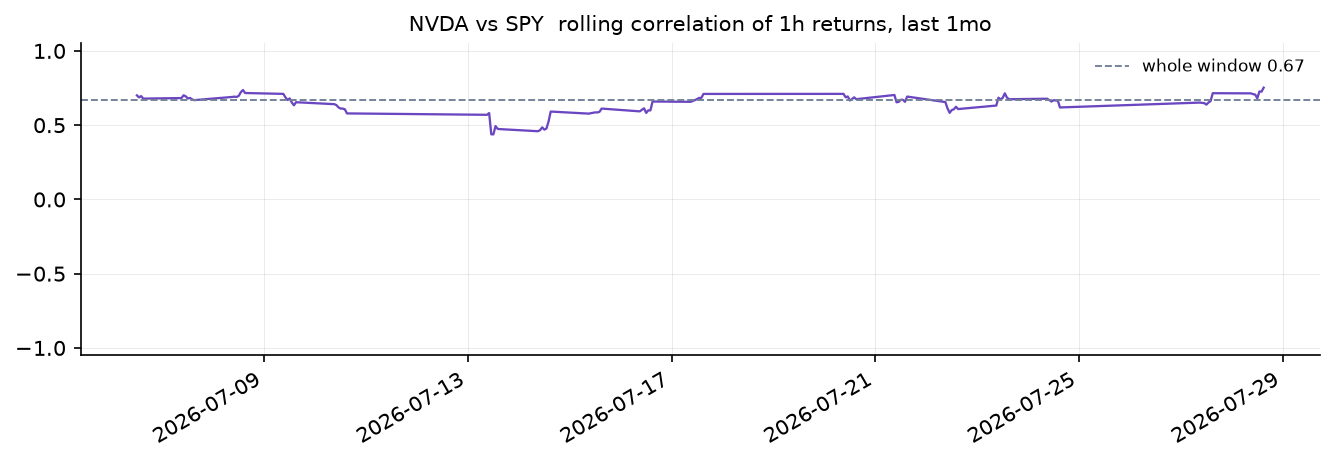
E aqueles que respondem em texto:
for command in ("how did the market do this week", "biggest losers today"):
    print(f'"{command}"  ->  {CALLS[command]}')
    print(CALLS[command].run(), "\n")
"how did the market do this week" -> market_summary(window='1w')
the board over 1w
NVDA 254.12 9.62% 389,465,563
AMD 184.20 1.51% 182,740,497
AAPL 258.71 0.97% 223,818,998
SPY 664.86 0.40% 138,617,365
MSFT 451.35 0.26% 113,427,173
TSLA 320.22 -0.97% 266,317,023
"biggest losers today" -> top_movers(window='1d', direction='losers')
top 3 losers over 1d
AMD -0.57% -> 184.20
MSFT 0.67% -> 451.35
AAPL 1.40% -> 258.71 Leia a confiança
confidence relata a avaliação menos certa na chamada, em vez do produto
de todas elas, já que um único argumento errado é suficiente para estragar o resultado. Um produto responde a uma
pergunta diferente (“está tudo certo em cada parte”), e ele diminui à medida que a função recebe mais
argumentos, independentemente de uma única avaliação ser instável.
De onde veio esse número, argumento por argumento:
call = CALLS["is amd tracking nvidia lately"]
print(f'"is amd tracking nvidia lately"  ->  {call}   confidence {call.confidence:.2f}')
for name, argument in call.arguments.items():
    top = sorted(argument.distribution.items(), key=lambda kv: -kv[1])[:3]
    shown = "omitted, default stands" if argument.omitted else repr(argument.value)
    print(
        f"  {name:<12}{shown:<26}p {argument.probability:.2f}   "
        + "  ".join(f"{k} {v:.2f}" for k, v in top)
    )
print(f"  weakest argument: {call.weakest().name}")
"is amd tracking nvidia lately" -> rolling_correlation(symbol='AMD', benchmark='NVDA') confidence 0.82
symbol 'AMD' p 0.87 AMD 0.87 NVDA 0.13 AAPL 0.00
benchmark 'NVDA' p 0.78 NVDA 0.92 AMD 0.08 AAPL 0.00
window omitted, default stands p 0.96
resolution omitted, default stands p 0.99
weakest argument: benchmarkwindow e resolution estão ambos omitidos aqui, porque “recentemente” não especifica há quanto tempo
ou em quais barras, então rolling_correlation segue seus padrões próprios de um mês e barras
horárias. É para isso que serve a pergunta stated. Sem ela, a escolha teria de nomear
alguma janela, e teria nomeado uma com confiança.
Abra-o no playground
O link abaixo contém um comando e as perguntas para a função que ele escolheu: a escolha
entre as dez descrições de função, e os quatro argumentos de rolling_correlation. Edite o
comando lá e os argumentos mudam junto com ele.
COMMAND = "plot rolling correlation between nvda and spy for the past month"
picked = CALLS[COMMAND]
playground_link = make_playground_link(
    COMMAND,
    {ROUTE: assistant.questions[ROUTE]}
    | {q: v for q, v in assistant.questions.items() if q.startswith(f"{picked.name}.")},
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open the command and its questions in the TypeSafe playground]({playground_link})"
    )
)