 JevCode
Classificação usando confiança
Classificar os relatórios anuais da SEC em 75 grupos de indústrias, com uma única escolha para cada, e então ler a própria confiança da resposta para decidir se o grupo é reportado ou se a divisão mais ampla acima dele é reportada.
Traduzido automaticamente do en, sem revisão. Apenas como referência rápida.

Todas as empresas que apresentam um relatório anual à SEC descrevem seu próprio negócio nele.
Classificamos essas descrições sob a Classificação Industrial Padrão: 75 grupos de
indústria, uma Choice pergunta por documento.
A maioria dos registros é simples. Um banco regional é um banco regional. Alguns não são: uma empresa que acabou de vender um de seus dois segmentos, ou uma startup que descreve um negócio que planeja entrar, em vez de um que opera. O modelo precisa escolher um grupo de qualquer maneira, e a resposta para um caso difícil não se parece em nada com a resposta para um caso fácil. Distinguir casos difíceis dos fáceis é normalmente onde o custo incide: um segundo modelo, chamadas extras, revisão humana.
A Choice já te diz isso. Junto com a opção vencedora, ela retorna confidence, alto quando quase toda a probabilidade se concentrou em uma única opção e baixo quando se espalhou por várias. Esse único número separa as respostas que você pode confiar das que não pode.
O que fazer com uma resposta não confiável depende dos seus rótulos. Os rótulos SIC formam uma hierarquia: os grupos industriais se agrupam em divisões mais amplas. Isso torna uma resposta praticamente gratuita. Quando o modelo não tem certeza do grupo, informe a divisão à qual ele pertence. O rótulo amplo decorre do mais específico, portanto não há uma segunda chamada.
Em 60 registros, um limiar de confiança de 0,9 os divide ao meio. A metade confiante está certa 90% das vezes; a outra metade, 40%. Reportado um nível acima, esse 40% se torna 70%. Terminamos com uma função classify() que retorna um rótulo mais o quão específico ela é, em um pedido por documento.
Direção do fluxo: ES-D
| Nó | Descrição | Grupo |
|---|---|---|
doc |
Item 1 ‘Negócios’ / de um 10-K | — |
request |
uma solicitação | uma solicitação |
q |
Escolha / 75 grupos industriais | uma solicitação |
sure |
confiança / ≥ 0,9? | — |
grp |
relatar o grupo industrial / ex. 28 | — |
div |
relatar sua divisão / ex. manufatura | — |
| De | Condição | Para |
|---|---|---|
doc |
— | request |
sure |
sim | grp |
sure |
não | div |
Configuração
pip install ipython matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/então defina TYPESAFE_API_KEY. Cada chamada de API é armazenada em cache em json_cache.json, que acompanha o cookbook, portanto, o re-renderização reproduz os números publicados sem chamar a API.
Exclua esse arquivo para executar tudo novamente ao vivo.
Os números abaixo vieram de jev-1.12 em 12/08/2026.
import json
from collections import defaultdict
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, TypeSafeClient

matplotlib.use("Agg")  # headless render

import os  # noqa: E402

TYPESAFE_MODEL = "jev-1.12"
CONFIDENT = 0.9  # above this the group is reported; below it, the division

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Construa os dois níveis da taxonomia
sic_codes.tsv é a lista setorial que a SEC publica para que os declarantes escolham seus próprios códigos, obtida em 2026-08-10: 444 códigos de quatro dígitos, cada um com um título de indústria. Os dígitos formam uma hierarquia. Os dois primeiros são o grupo principal (75 deles aqui, de 01 produção agrícola a 99 não classificável), e faixas fixas de grupos principais compõem as dez divisões, a divisão mais ampla do SIC.
Ambos os níveis saem desse único arquivo, sem nenhum modelo envolvido: agrupe os códigos pelos seus dois primeiros dígitos e, em seguida, mapeie esses dígitos para uma divisão.
DIVISIONS = [
    (1, 9, "agriculture, forestry and fishing"),
    (10, 14, "mining"),
    (15, 17, "construction"),
    (20, 39, "manufacturing"),
    (40, 49, "transportation, communications and utilities"),
    (50, 51, "wholesale trade"),
    (52, 59, "retail trade"),
    (60, 67, "finance, insurance and real estate"),
    (70, 89, "services"),
    (91, 99, "public administration"),
]

INDUSTRIES: dict[str, str] = {}
for line in Path("sic_codes.tsv").read_text().splitlines()[1:]:
    code, _office, title = line.split("\t")
    INDUSTRIES[code] = title.lower()

GROUPS: dict[str, list[str]] = defaultdict(list)
for code in sorted(INDUSTRIES):
    GROUPS[code[:2]].append(code)


def division(group: str) -> str:
    number = int(group)
    return next(name for low, high, name in DIVISIONS if low <= number <= high)


print(
    f"{len(INDUSTRIES)} industries -> {len(GROUPS)} major groups -> {len(DIVISIONS)} divisions"
)
print(
    f"  group 35 = {division('35')} / {', '.join(INDUSTRIES[c] for c in GROUPS['35'][:3])} ..."
)
444 industries -> 75 major groups -> 10 divisions
group 35 = manufacturing / engines & turbines, farm machinery & equipment, lawn & garden tractors & home lawn & gardens equip ...Uma pergunta do Choice precisa de algo para descrever cada opção, e o próprio nome de um grupo nem sempre está presente: 42 dos 75 carregam um título genérico na lista da SEC, e os demais não carregam nenhum. Portanto, cada grupo é descrito pelas indústrias que ele contém, que é exatamente o que alguém que lê o documento compararia de qualquer maneira.
MAX_NAMED = (
    8  # industries listed per group; enough to characterise it without a wall of text
)


def describe(group: str) -> str:
    umbrella = INDUSTRIES.get(f"{group}00")
    inside = [INDUSTRIES[c] for c in GROUPS[group] if c != f"{group}00"][:MAX_NAMED]
    listed = "; ".join(inside)
    return (
        f"{umbrella} — includes: {listed}"
        if umbrella and listed
        else (umbrella or listed)
    )


print(f"group 20: {describe('20')[:150]}")
print(f"\ngroup 65: {describe('65')[:150]}")
group 20: food and kindred products — includes: meat packing plants; sausages & other prepared meat products; poultry slaughtering and processing; dairy product
group 65: real estate — includes: real estate operators (no developers) & lessors; operators of nonresidential buildings; operators of apartment buildings; lessOs registros
filings.jsonl contém 60 relatórios anuais (10-K), cada um reduzido ao Item 1 “Negócios”, a seção onde uma empresa descreve o que faz, que é a única parte relevante para um código de indústria. Eles abrangem 1993–2024 e variam de 700 a 2.200 palavras. Cada um traz o código SIC escolhido pelo declarante, além do número de acesso para consultá-lo no EDGAR.
De onde vem esse rótulo importa antes de qualquer número de precisão. É autorreferido: quem preparou o registro o escolheu uma vez, e ele fica desatualizado quando uma empresa vende o negócio que os nomes de código e mantém o código. Esses 60 foram filtrados para registros cujos seu próprio texto suporta o código que carregam, então os números aqui medem a receita em vez de o estado dos metadados do EDGAR.
FILINGS = [json.loads(line) for line in Path("filings.jsonl").read_text().splitlines()]
example = FILINGS[7]
print(
    f"{len(FILINGS)} filings, {sum(f['words'] for f in FILINGS) // len(FILINGS)} words on average"
)
print(f"\n{example['id']} (filed {example['year']}, accession {example['accession']}):")
print(f"  {example['text'][:230]}...")
print(f"  filer's code: {example['sic']} {INDUSTRIES[example['sic']]}")
60 filings, 1438 words on average
1389870_2008 (filed 2008, accession 0001079974-09-000155):
Item 1. DESCRIPTION OF BUSINESS. NARRATIVE DESCRIPTION OF THE BUSINESS Across America Financial Services, Inc. is a corporation which was formed under the laws of the State of Colorado on December 1, 2005. Until March 23, 2007, we...
filer's code: 6163 loan brokersFaça uma pergunta do tipo Choice e leia a confiança
Uma Choice pergunta cujas opções são os 75 grupos. Toda a taxonomia cabe em uma única solicitação: um Choice funciona de forma confiável até aproximadamente 240 opções, e 75 está bem dentro desse limite.
A resposta retorna com choice, o grupo vencedor; probabilities, o peso em cada
um dos 75; e confidence, que indica quão concentrada era essa distribuição. A receita lê
confidence em vez da própria probabilidade do vencedor. Um vencedor com 0,45 e um segundo colocado com
0,44, e um vencedor com 0,45 com o restante do peso espalhado de forma dispersa, são situações
diferentes, e confidence é o que as separa.
QUESTION = (
    "Which broad industry does this company operate in? Judge the company's own operations "
    "as this filing describes them."
)


def questions() -> dict:
    return {
        "group": Choice(
            instructions=QUESTION,
            criteria={group: describe(group) for group in sorted(GROUPS)},
        )
    }


@json_cache
def ask(filing_id: str, text: str) -> dict:
    response = client.system_one(
        state=text, questions=questions(), model=TYPESAFE_MODEL
    )
    answer = response.answers["group"]
    return {
        "group": answer.choice,
        "confidence": answer.confidence,
        "probabilities": dict(answer.probabilities),
    }
Retorne o grupo quando tiver certeza, sua divisão quando não
As quatro linhas abaixo são a receita completa. Com confiança de 0,9 ou superior, a resposta é reportada como um grupo setorial; abaixo disso, a mesma resposta é reportada como a divisão que esse grupo integra.
Cada registro ainda retorna com um rótulo utilizável. Um que o modelo não conseguiu classificar com confiança retorna um nível acima, em vez de ser descartado ou encaminhado adiante. Se uma divisão for muito ampla para que sua aplicação possa agir, este é o ramo onde você o entrega a uma pessoa.
def classify(filing: dict) -> dict:
    answer = ask(filing["id"], filing["text"])
    sure = answer["confidence"] >= CONFIDENT
    return {
        "level": "group" if sure else "division",
        "label": answer["group"] if sure else division(answer["group"]),
        "confidence": answer["confidence"],
        "group": answer["group"],
    }


def show(filing: dict) -> None:
    result = classify(filing)
    named = describe(result["group"]).split(" — ")[0][:46]
    print(
        f"  {filing['id']:>13}  conf {result['confidence']:.2f}  -> {result['level']:<8} "
        f"{result['label']:<14} (group {result['group']}: {named})"
    )


print("three filings the model was sure about:")
for f in sorted(FILINGS, key=lambda f: -ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
print("\nthree it was not:")
for f in sorted(FILINGS, key=lambda f: ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
three filings the model was sure about:
310158_1996 conf 1.00 -> group 28 (group 28: chemicals & allied products)
33416_1998 conf 1.00 -> group 63 (group 63: life insurance; accident & health insurance; h)
352541_1996 conf 1.00 -> group 49 (group 49: electric, gas & sanitary services)
three it was not:
1372167_2013 conf 0.22 -> division manufacturing (group 38: search, detection, navagation, guidance, aeron)
1398633_2009 conf 0.23 -> division wholesale trade (group 50: wholesale-durable goods)
46653_1999 conf 0.29 -> division services (group 87: services-engineering, accounting, research, ma)As confianças alinham-se com a dificuldade de classificação de cada registro. Os três com 1,00 são um fabricante farmacêutico, uma seguradora de vida e uma empresa de serviços públicos; todos os três são holding companies no papel, mas cada uma tem um negócio dominante que o registro nomeia explicitamente. Os três na parte inferior são mais difíceis por razões que você pode ler no texto. Dois são empresas em estágio de desenvolvimento descrevendo um negócio que pretendem iniciar (Nevaeh “pretende operar como desenvolvedora de software”, Barricode foi “organizada para entrar na indústria de software de segurança de computador”), e o terceiro tinha dois segmentos e vendeu um deles semanas antes do registro. Esses três retornam como uma divisão em vez de um grupo.
classify() é a receita completa. Aponte ask() para seus próprios documentos e reescreva
describe() para sua própria taxonomia, e o resto se aplica automaticamente.
O que a resposta mais ampla proporciona
Tod as 60 inscrições, pontuadas contra o código escolhido por cada declarante, sob ambas as políticas: nomear um grupo sempre, ou reportar a divisão sempre que a confiança cair abaixo de 0,9.
def correct(filing: dict, result: dict) -> bool:
    gold_group = filing["sic"][:2]
    if result["level"] == "group":
        return result["label"] == gold_group
    return result["label"] == division(gold_group)


results = [(f, classify(f)) for f in FILINGS]
sure = [(f, r) for f, r in results if r["level"] == "group"]
unsure = [(f, r) for f, r in results if r["level"] == "division"]

forced = sum(r["group"] == f["sic"][:2] for f, r in results)
broadened = sum(correct(f, r) for f, r in results)

print(f"forced to name a group every time      {forced}/{len(results)} right")
print(
    f"  of those, the {len(sure)} it was sure about  "
    f"{sum(r['group'] == f['sic'][:2] for f, r in sure)}/{len(sure)} right"
)
print(
    f"  and the {len(unsure)} it was not           "
    f"{sum(r['group'] == f['sic'][:2] for f, r in unsure)}/{len(unsure)} right"
)
print(
    f"\nletting it answer coarsely when unsure  {broadened}/{len(results)} useful answers"
)
forced to name a group every time 39/60 right
of those, the 30 it was sure about 27/30 right
and the 30 it was not 12/30 right
letting it answer coarsely when unsure 48/60 useful answersOnde o modelo estava seguro, o grupo que nomeou está certo nove vezes em dez. Onde não estava, nomear um grupo estava errado mais frequentemente do que certo, em 40%. Relatar essas mesmas respostas como uma divisão as eleva para 70%.
O gráfico coloca as duas políticas lado a lado, divididas pela certeza do modelo.
labels = ["sure\n(group reported)", "unsure\n(division reported)"]
forced_split = [
    sum(r["group"] == f["sic"][:2] for f, r in sure) / len(sure),
    sum(r["group"] == f["sic"][:2] for f, r in unsure) / len(unsure),
]
broad_split = [
    sum(correct(f, r) for f, r in sure) / len(sure),
    sum(correct(f, r) for f, r in unsure) / len(unsure),
]

fig, ax = plt.subplots(figsize=(7, 3.6))
x = range(len(labels))
ax.bar(
    [i - 0.19 for i in x],
    forced_split,
    0.38,
    label="always name a group",
    color="#c8ccd4",
)
ax.bar(
    [i + 0.19 for i in x],
    broad_split,
    0.38,
    label="answer broadly when unsure",
    color="#3b6ea5",
)
for i, (a, b) in enumerate(zip(forced_split, broad_split)):
    ax.text(i - 0.19, a + 0.02, f"{a:.0%}", ha="center", fontsize=9)
    ax.text(i + 0.19, b + 0.02, f"{b:.0%}", ha="center", fontsize=9)
ax.set_xticks(list(x))
ax.set_xticklabels(
    [f"{lab}\nn={n}" for lab, n in zip(labels, [len(sure), len(unsure)])]
)
ax.set_ylabel("labels that are right")
ax.set_ylim(0, 1.12)
ax.set_title("Where the broader answer helps: the filings it was unsure about")
ax.legend(frameon=False, loc="upper right")
ax.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
display(fig)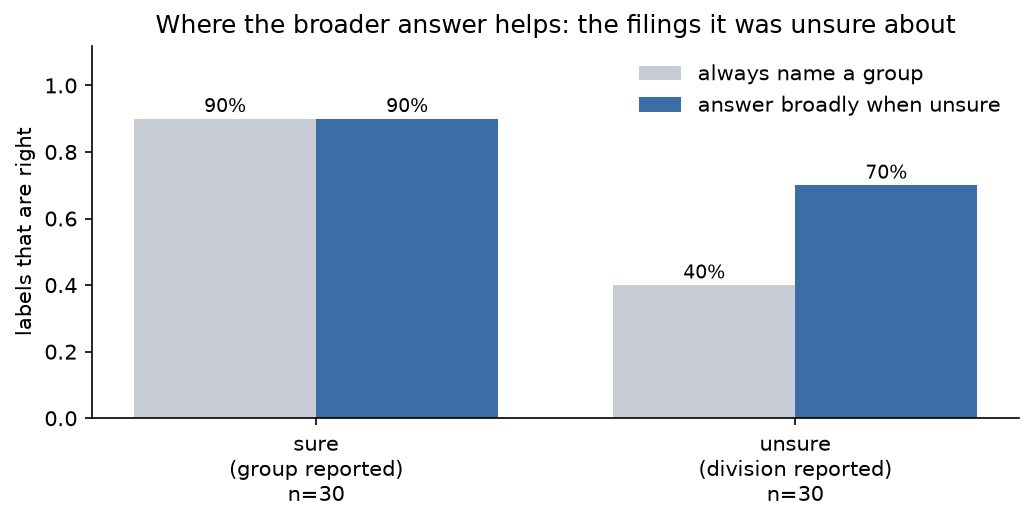
Abra no playground
Este link de compartilhamento contém um registro e a pergunta de 75 opções, permitindo que você visualize a distribuição e a confiança que ela gera sem precisar escrever nenhum código.
playground_link = make_playground_link(
    example["text"], questions(), models=[TYPESAFE_MODEL]
)
display(
    Markdown(
        f"🔗 [Open the filing + question in the TypeSafe playground]({playground_link})"
    )
)