 JevCode
Klassifizierung mit Konfidenz
Klassifiziere SEC-Jahresberichte in 75 Industriegruppen mit jeweils einem Choice, und lies dann das eigene Konfidenzniveau der Antwort, um zu entscheiden, ob diese Gruppe oder die darüberliegende breitere Division gemeldet wird.
Maschinell aus en übersetzt, nicht lektoriert. Nur als Kurzreferenz geeignet.

Jede Firma, die einen Jahresbericht bei der SEC einreicht, beschreibt darin ihr eigenes Geschäft. Wir klassifizieren diese Beschreibungen unter der Standard Industrial Classification: 75 Industrie gruppen, eine Choice Frage pro Dokument.
Die meisten Einreichungen sind einfach. Eine Regionalbank ist eine Regionalbank. Einige sind es nicht: ein Unternehmen, das gerade eines seiner beiden Segmente verkauft hat, oder ein Startup, das ein Geschäft beschreibt, das es betreten will, anstatt eines, das es betreibt. Das Modell muss unabhängig davon eine Gruppe auswählen, und die Antwort für einen schwierigen Fall sieht nicht anders aus als die Antwort für einen einfachen Fall. Die Unterscheidung zwischen schwierigen und einfachen Fällen ist normalerweise dort, wo die Kosten entstehen: ein zweites Modell, zusätzliche Aufrufe, menschliche Überprüfung.
Ein Choice sagt es dir bereits. Neben der siegreichen Option gibt er confidence zurück, hoch, wenn fast die gesamte Wahrscheinlichkeit auf einer Option liegt, und niedrig, wenn sie sich auf mehrere verteilt. Diese eine Zahl trennt die Antworten, denen du vertrauen kannst, von denen, denen du es nicht kannst.
Was man mit einer nicht vertrauenswürdigen Antwort macht, hängt von Ihren Labels ab. SIC-Labels bilden eine Hierarchie: Industriegruppen werden zu weiteren Abteilungen zusammengefasst. Das macht eine Antwort nahezu kostenlos. Wenn das Modell sich der Gruppe nicht sicher ist, melden Sie die Abteilung, der es angehört. Das breite Label ergibt sich aus dem schmalen, also gibt es keinen zweiten Aufruf.
Über 60 Einreichungen hinweg teilt ein Konfidenz-Schwellenwert von 0,9 sie in zwei Hälften. Die sichere Hälfte liegt zu 90 % richtig; die andere Hälfte zu 40 %. Auf einer Ebene höher berichtet, wird diese 40 % zu 70 %. Wir enden mit einer classify()-Funktion, die ein Label sowie die Spezifität zurückgibt, bei einer Anfrage pro Dokument.
Flussrichtung: LR
| Knoten | Beschreibung | Gruppe |
|---|---|---|
doc |
Artikel 1 ‘Business’ / aus einem 10-K | — |
request |
eine Anfrage | eine Anfrage |
q |
Choice / 75 Industriegruppen | eine Anfrage |
sure |
Vertrauen / ≥ 0,9? | — |
grp |
melden Sie die Industriegruppe / z.B. 28 | — |
div |
melden Sie ihre Abteilung / z.B. Fertigung | — |
| Von | Bedingung | Zu |
|---|---|---|
doc |
— | request |
sure |
ja | grp |
sure |
nein | div |
Setup
pip install ipython matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/dann TYPESAFE_API_KEY festlegen. Jeder API-Aufruf wird in json_cache.json zwischengespeichert, das mit dem Kochbuch ausgeliefert wird, sodass das erneute Rendern die veröffentlichten Zahlen abspielt, ohne die API aufzurufen. Löschen Sie diese Datei, um alles live neu auszuführen.
Die untenstehenden Zahlen stammen von jev-1.12 am 2026-08-12.
import json
from collections import defaultdict
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, TypeSafeClient

matplotlib.use("Agg")  # headless render

import os  # noqa: E402

TYPESAFE_MODEL = "jev-1.12"
CONFIDENT = 0.9  # above this the group is reported; below it, the division

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Erstellen Sie die beiden Ebenen der Taxonomie
sic_codes.tsv ist die Branchenliste, die die SEC für Meldepflichtige veröffentlicht, aus der sie ihren eigenen Code auswählen können, abgerufen am 2026-08-10: 444 vierstellige Codes, jeweils mit einem Branchen-Titel. Die Ziffern bilden eine Hierarchie. Die ersten beiden stellen die Hauptgruppe dar (75 davon hier, von 01 landwirtschaftliche Produktion bis 99 nicht klassifizierbar), und feste Bereiche von Hauptgruppen bilden die zehn Abteilungen, die breiteste Unterteilung des SIC.
Beide Ebenen stammen aus dieser einen Datei ohne Beteiligung eines Modells: Gruppieren Sie die Codes nach ihren ersten beiden Ziffern und weisen Sie diese Ziffern dann einer Division zu.
DIVISIONS = [
    (1, 9, "agriculture, forestry and fishing"),
    (10, 14, "mining"),
    (15, 17, "construction"),
    (20, 39, "manufacturing"),
    (40, 49, "transportation, communications and utilities"),
    (50, 51, "wholesale trade"),
    (52, 59, "retail trade"),
    (60, 67, "finance, insurance and real estate"),
    (70, 89, "services"),
    (91, 99, "public administration"),
]

INDUSTRIES: dict[str, str] = {}
for line in Path("sic_codes.tsv").read_text().splitlines()[1:]:
    code, _office, title = line.split("\t")
    INDUSTRIES[code] = title.lower()

GROUPS: dict[str, list[str]] = defaultdict(list)
for code in sorted(INDUSTRIES):
    GROUPS[code[:2]].append(code)


def division(group: str) -> str:
    number = int(group)
    return next(name for low, high, name in DIVISIONS if low <= number <= high)


print(
    f"{len(INDUSTRIES)} industries -> {len(GROUPS)} major groups -> {len(DIVISIONS)} divisions"
)
print(
    f"  group 35 = {division('35')} / {', '.join(INDUSTRIES[c] for c in GROUPS['35'][:3])} ..."
)
444 industries -> 75 major groups -> 10 divisions
group 35 = manufacturing / engines & turbines, farm machinery & equipment, lawn & garden tractors & home lawn & gardens equip ...Eine Choice-Frage benötigt etwas, um jede Option zu beschreiben, und der Eigenname einer Gruppe ist nicht immer vorhanden: 42 der 75 tragen einen Oberbegriff in der Liste der SEC, und die anderen tragen keinen. Daher wird jede Gruppe durch die Branchen innerhalb dieser Gruppe beschrieben, was jemand, der die Einreichung liest, sowieso abgleichen würde.
MAX_NAMED = (
    8  # industries listed per group; enough to characterise it without a wall of text
)


def describe(group: str) -> str:
    umbrella = INDUSTRIES.get(f"{group}00")
    inside = [INDUSTRIES[c] for c in GROUPS[group] if c != f"{group}00"][:MAX_NAMED]
    listed = "; ".join(inside)
    return (
        f"{umbrella} — includes: {listed}"
        if umbrella and listed
        else (umbrella or listed)
    )


print(f"group 20: {describe('20')[:150]}")
print(f"\ngroup 65: {describe('65')[:150]}")
group 20: food and kindred products — includes: meat packing plants; sausages & other prepared meat products; poultry slaughtering and processing; dairy product
group 65: real estate — includes: real estate operators (no developers) & lessors; operators of nonresidential buildings; operators of apartment buildings; lessDie Einreichungen
filings.jsonl enthält 60 Jahresberichte (10-K), die jeweils auf Abschnitt 1 „Business“ gekürzt wurden, den Abschnitt, in dem ein Unternehmen beschreibt, was es tut; dies ist der einzige Teil, der für einen Industriecode relevant ist. Sie umfassen den Zeitraum 1993–2024 und reichen von 700 bis 2.200 Wörtern. Jeder enthält den SIC-Code, den der Einreicher gewählt hat, sowie die Zugangsnummer zur Suche auf EDGAR.
Woher dieses Label stammt, ist vor jeder Genauigkeitszahl entscheidend. Es wird selbst angegeben: Wer auch immer den Antrag vorbereitet hat, hat ihn einmal ausgewählt, und er veraltet, wenn ein Unternehmen das Geschäft verkauft, dessen Codenamen es trägt, und die Codenamen behält. Diese 60 wurden auf Anträge reduziert, deren eigener Text den von ihnen getragenen Code unterstützt, sodass die Zahlen hier das Rezept messen und nicht den Zustand von EDGARS Metadaten.
FILINGS = [json.loads(line) for line in Path("filings.jsonl").read_text().splitlines()]
example = FILINGS[7]
print(
    f"{len(FILINGS)} filings, {sum(f['words'] for f in FILINGS) // len(FILINGS)} words on average"
)
print(f"\n{example['id']} (filed {example['year']}, accession {example['accession']}):")
print(f"  {example['text'][:230]}...")
print(f"  filer's code: {example['sic']} {INDUSTRIES[example['sic']]}")
60 filings, 1438 words on average
1389870_2008 (filed 2008, accession 0001079974-09-000155):
Item 1. DESCRIPTION OF BUSINESS. NARRATIVE DESCRIPTION OF THE BUSINESS Across America Financial Services, Inc. is a corporation which was formed under the laws of the State of Colorado on December 1, 2005. Until March 23, 2007, we...
filer's code: 6163 loan brokersStelle eine Choice-Frage und lies das Vertrauen ab
Eine Choice Frage, deren Optionen die 75 Gruppen sind. Die gesamte Taxonomie passt in eine Anfrage: Ein Choice funktioniert zuverlässig bis zu etwa 240 Optionen, und 75 liegt weit innerhalb dieses Bereichs.
Die Antwort kommt mit choice, die gewinnende Gruppe; probabilities, das Gewicht auf jedem
der 75; und confidence, das angibt, wie konzentriert diese Verteilung war. Das Rezept liest
confidence statt der eigenen Wahrscheinlichkeit des Gewinners. Ein Gewinner bei 0.45 mit einem
Zweiten bei 0.44 und ein Gewinner bei 0.45, wobei das restliche Gewicht dünn verteilt ist, sind unterschiedliche
Situationen, und confidence ist das, was sie trennt.
QUESTION = (
    "Which broad industry does this company operate in? Judge the company's own operations "
    "as this filing describes them."
)


def questions() -> dict:
    return {
        "group": Choice(
            instructions=QUESTION,
            criteria={group: describe(group) for group in sorted(GROUPS)},
        )
    }


@json_cache
def ask(filing_id: str, text: str) -> dict:
    response = client.system_one(
        state=text, questions=questions(), model=TYPESAFE_MODEL
    )
    answer = response.answers["group"]
    return {
        "group": answer.choice,
        "confidence": answer.confidence,
        "probabilities": dict(answer.probabilities),
    }
Gib die Gruppe zurück, wenn du sicher bist, ihre Abteilung, wenn nicht
Die vier Zeilen unten sind das gesamte Rezept. Bei einem Konfidenzwert von 0,9 oder höher wird die Antwort als Industriegruppe gemeldet; darunter wird dieselbe Antwort als die Abteilung gemeldet, in der diese Gruppe angesiedelt ist.
Jede Einreichung kommt mit einem verwertbaren Label zurück. Eine, die das Modell nicht sicher klassifizieren konnte, kommt eine Ebene höher zurück, anstatt verworfen oder weitergeleitet zu werden. Wenn eine Aufteilung für Ihre Anwendung zu grob ist, um darauf zu reagieren, ist dies der Zweig, an den Sie sie an eine Person übergeben.
def classify(filing: dict) -> dict:
    answer = ask(filing["id"], filing["text"])
    sure = answer["confidence"] >= CONFIDENT
    return {
        "level": "group" if sure else "division",
        "label": answer["group"] if sure else division(answer["group"]),
        "confidence": answer["confidence"],
        "group": answer["group"],
    }


def show(filing: dict) -> None:
    result = classify(filing)
    named = describe(result["group"]).split(" — ")[0][:46]
    print(
        f"  {filing['id']:>13}  conf {result['confidence']:.2f}  -> {result['level']:<8} "
        f"{result['label']:<14} (group {result['group']}: {named})"
    )


print("three filings the model was sure about:")
for f in sorted(FILINGS, key=lambda f: -ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
print("\nthree it was not:")
for f in sorted(FILINGS, key=lambda f: ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
three filings the model was sure about:
310158_1996 conf 1.00 -> group 28 (group 28: chemicals & allied products)
33416_1998 conf 1.00 -> group 63 (group 63: life insurance; accident & health insurance; h)
352541_1996 conf 1.00 -> group 49 (group 49: electric, gas & sanitary services)
three it was not:
1372167_2013 conf 0.22 -> division manufacturing (group 38: search, detection, navagation, guidance, aeron)
1398633_2009 conf 0.23 -> division wholesale trade (group 50: wholesale-durable goods)
46653_1999 conf 0.29 -> division services (group 87: services-engineering, accounting, research, ma)Die Konfidenzwerte stimmen damit überein, wie schwer jede Einreichung zu klassifizieren ist. Die drei mit 1.00 sind ein pharmazeutischer Hersteller, eine Lebensversicherung und ein Versorgungsunternehmen; alle drei sind auf dem Papier Holdinggesellschaften, aber jede hat ein dominantes Geschäftsgebiet, das die Einreichung offen benennt. Die drei am unteren Ende sind aus Gründen schwieriger, die Sie im Text nachlesen können. Zwei sind Entwicklungsunternehmen, die ein Geschäft beschreiben, das sie starten beabsichtigen (Nevaeh “beabsichtigt, als Softwareentwickler zu operieren”), Barricode wurde “organisiert, um in die Computer-Sicherheitssoftware-Branche einzutreten”), und das dritte hatte zwei Segmente und verkaufte eines davon Wochen vor der Einreichung. Diese drei kommen als Abteilung statt als Gruppe zurück.
classify() ist das gesamte Rezept. Zeige ask() auf deine eigenen Dokumente und schreibe
describe() für deine eigene Taxonomie um, und der Rest wird übernommen.
Was die umfassendere Antwort bringt
Alle 60 Einreichungen, bewertet gegen den von jedem Einreicher gewählten Code, unter beiden Richtlinien: Nenne eine Gruppe jedes Mal, oder melde die Aufteilung, sobald das Vertrauen unter 0,9 fällt.
def correct(filing: dict, result: dict) -> bool:
    gold_group = filing["sic"][:2]
    if result["level"] == "group":
        return result["label"] == gold_group
    return result["label"] == division(gold_group)


results = [(f, classify(f)) for f in FILINGS]
sure = [(f, r) for f, r in results if r["level"] == "group"]
unsure = [(f, r) for f, r in results if r["level"] == "division"]

forced = sum(r["group"] == f["sic"][:2] for f, r in results)
broadened = sum(correct(f, r) for f, r in results)

print(f"forced to name a group every time      {forced}/{len(results)} right")
print(
    f"  of those, the {len(sure)} it was sure about  "
    f"{sum(r['group'] == f['sic'][:2] for f, r in sure)}/{len(sure)} right"
)
print(
    f"  and the {len(unsure)} it was not           "
    f"{sum(r['group'] == f['sic'][:2] for f, r in unsure)}/{len(unsure)} right"
)
print(
    f"\nletting it answer coarsely when unsure  {broadened}/{len(results)} useful answers"
)
forced to name a group every time 39/60 right
of those, the 30 it was sure about 27/30 right
and the 30 it was not 12/30 right
letting it answer coarsely when unsure 48/60 useful answersWo das Modell sicher war, ist die von ihm genannte Gruppe neun von zehn Mal richtig. Wo es nicht sicher war, war die Nennung einer Gruppe häufiger falsch als richtig, bei 40 %. Die Berichterstattung über dieselben Antworten als Division bringt sie auf 70 %.
Die Grafik stellt die beiden Richtlinien nebeneinander aufgeteilt, je nachdem, ob das Modell sich sicher war.
labels = ["sure\n(group reported)", "unsure\n(division reported)"]
forced_split = [
    sum(r["group"] == f["sic"][:2] for f, r in sure) / len(sure),
    sum(r["group"] == f["sic"][:2] for f, r in unsure) / len(unsure),
]
broad_split = [
    sum(correct(f, r) for f, r in sure) / len(sure),
    sum(correct(f, r) for f, r in unsure) / len(unsure),
]

fig, ax = plt.subplots(figsize=(7, 3.6))
x = range(len(labels))
ax.bar(
    [i - 0.19 for i in x],
    forced_split,
    0.38,
    label="always name a group",
    color="#c8ccd4",
)
ax.bar(
    [i + 0.19 for i in x],
    broad_split,
    0.38,
    label="answer broadly when unsure",
    color="#3b6ea5",
)
for i, (a, b) in enumerate(zip(forced_split, broad_split)):
    ax.text(i - 0.19, a + 0.02, f"{a:.0%}", ha="center", fontsize=9)
    ax.text(i + 0.19, b + 0.02, f"{b:.0%}", ha="center", fontsize=9)
ax.set_xticks(list(x))
ax.set_xticklabels(
    [f"{lab}\nn={n}" for lab, n in zip(labels, [len(sure), len(unsure)])]
)
ax.set_ylabel("labels that are right")
ax.set_ylim(0, 1.12)
ax.set_title("Where the broader answer helps: the filings it was unsure about")
ax.legend(frameon=False, loc="upper right")
ax.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
display(fig)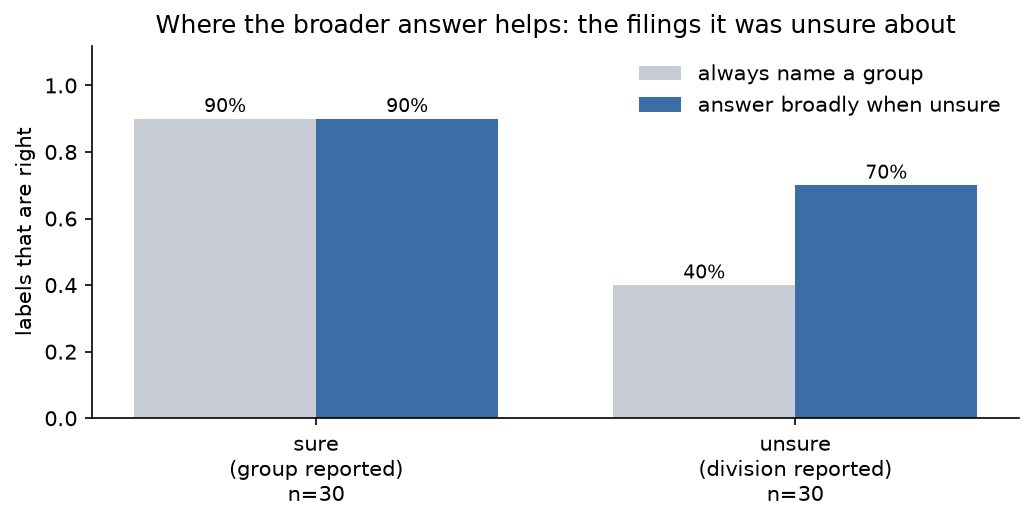
Öffnen Sie es im Playground
Dieser Freigabelink enthält eine Einreichung und die Frage mit 75 Optionen, sodass Sie die Verteilung und das daraus resultierende Konfidenzniveau sehen können, ohne Code schreiben zu müssen.
playground_link = make_playground_link(
    example["text"], questions(), models=[TYPESAFE_MODEL]
)
display(
    Markdown(
        f"🔗 [Open the filing + question in the TypeSafe playground]({playground_link})"
    )
)