 JevCode
Wissensgraph-Entitätsabgleich
Entscheidet, welche von 450 Kandidatenpaaren aus zwei Bierkatalogen dasselbe Produkt beschreiben. Eine einzige Frage vom Typ „TypeSafe Score“ trägt die gesamte Entscheidung, da ihre drei Stufen genau die drei möglichen Aktionen für ein Paar darstellen: Zusammenführen, unverknüpft lassen oder einem Kurator zur Prüfung übergeben. Es gibt keinen anzupassenden Schwellenwert, ein
Maschinell aus en übersetzt, nicht lektoriert. Nur als Kurzreferenz geeignet.

Ein zentrales Problem bei Wissensgraphen besteht darin, zu entscheiden, ob ein eingehender Entität eine bestehende dupliziert, insbesondere wenn aus unterschiedlichen Quellen lediglich natürliche Sprache verfügbar ist. Für potenzielle Duplikatpaare trifft eine einzelne TypeSafe Score die Entscheidung, ob jedes Paar ein Duplikat ist oder ob es einer genaueren Prüfung durch einen Kurator bedarf.
Nehmen wir an, zwei Datenquellen beschreiben überlappende Mengen derselben Dinge, und Sie müssen wissen, welcher Eintrag auf der einen Seite demselben Ding entspricht wie welcher Eintrag auf der anderen Seite. Ein Wissensgraph bezeichnet diese Einträge als Entitäten und speichert die über jeden einzelnen dokumentierten Fakten. Eine kostengünstige, aber grobe erste Auswertung hat die beiden Quellen bereits verglichen und 450 Paare identifiziert, die einer genaueren Betrachtung wert sind. Was noch fehlt, ist die individuelle Beurteilung jedes Paares.
Das unangemessene Zusammenführen zweier Entitäten ist der teurere Fehler, da jede Tatsache über entweder Entität nun die zusammengeführte beschreibt und alles, was mit einer verknüpft ist, ebenfalls mitgenommen wird. Das spätere Rückgängigmachen bedeutet, herauszufinden, welche Tatsache von woher stammt. Das Verpassen eines Matches hinterlässt nur ein Duplikat, daher erfordert die Urteilsbildung eine dritte Option: Paare, die weder sicher zum Zusammenführen noch sicher zum Löschen sind.
Die Beurteilung ist eine Score-Frage mit einer Stufe für jedes der drei Ergebnisse:
- unterschiedliches Produkt — lasse die beiden Entitäten unverknüpft
- verwandt, aber möglicherweise nicht identisch — übergebe es einem Kurator zur Entscheidung
- gleiches Produkt — verschmelze sie
Wir verwenden eine Score-Frage, weil wir jedem Ergebnis, einschließlich des mittleren Ergebnisses, direkt ein semantisches Label, die Score-Kriterien, zuordnen möchten. Eine Noul-Frage könnte dies indirekt durch Schwellenwertbildung ihrer Ausgabe erreichen, und eine Choice-Frage würde die geordnete Beziehung der drei Ergebnisse verlieren.
Als Nächstes können für jedes Feld der Entität, die wir betrachten möchten, Noul Fragen dazu, ob diese Felder übereinstimmen, im selben Request mitgeführt werden. Diese Noul liefern detailliertere Informationen für den Kurator, wenn die Punktzahl weder auf dem Niveau „selbes Produkt“ noch auf dem Niveau „unterschiedliche Produkte“ liegt.
Sie erhalten ein route(), das ein einzelnes Kandidatenpaar entgegennimmt und eines der drei
Ergebnisse zurückgibt, ohne dass Sie einen Schwellenwert an Ihre eigenen Daten anpassen mussten.
Richtung des Flusses: LR
| Knoten | Beschreibung | Gruppe |
|---|---|---|
CALL |
eine Anfrage, vier Fragen | eine Anfrage, vier Fragen |
S |
Score: wie verhalten sich die beiden zueinander? / · anderes Produkt / · verwandt, aber möglicherweise nicht dasselbe / · dasselbe Produkt | eine Anfrage, vier Fragen |
N |
Noul: einer pro verglichenem Feld / · gleicher Name? / · gleiche Brauerei? / · gleicher Stil? | eine Anfrage, vier Fragen |
| Von | Bedingung | Zu |
|---|---|---|
S |
— | N |
S |
— | R |
R |
unterschiedlich | DROP |
R |
gleich | M |
R |
verwandt | Q |
Einrichtung
pip install matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/dann TYPESAFE_API_KEY festlegen. Jeder Aufruf wird in json_cache.json zwischengespeichert, das mit dem
Cookbook ausgeliefert wird, sodass das erneute Rendern die veröffentlichten Zahlen
wiedergibt, ohne die API aufzurufen. Löschen Sie diese Datei, um alles erneut live auszuführen.
Die untenstehenden Zahlen stammen aus jev-1.12 vom 11.08.2026.
import json
import os
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Noul, Score, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
MAX_WORKERS = 6  # small pool; the public endpoint rate-limits above roughly eight

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Laden Sie die Kandidatenpaare
Die Paare stammen aus einem veröffentlichten Benchmark-Datensatz, den Beer-Daten aus der Magellan-Sammlung:
zwei Bierkataloge, die von verschiedenen Websites gescraped wurden und bereits durch diesen
ersten groben Durchlauf auf 450 Paare reduziert wurden. Jedes Entität enthält vier Felder: Name, Brauerei, Stil und Alkoholgehalt. Jedes Paar enthält außerdem known_same_as, die Antwort des Benchmarks.
Der Text wird unverändert so veröffentlicht, wie er veröffentlicht wurde, ohne Vorverarbeitung: HTML-Entities, die nie wieder in Zeichen umgewandelt wurden, Apostrophe, die als separate Wörter abgetrennt wurden, einige Zeichen, die falsch dekodiert wurden.
Pro Paar wird eine Anfrage gesendet, daher richten sich Ihre Kosten nach der Anzahl der Paare, die Sie erhalten haben, und nicht nach der Größe der jeweiligen Quelle.
PAIRS = json.loads(Path("candidate_pairs.json").read_text(encoding="utf-8"))
BY_ID = {pair["id"]: pair for pair in PAIRS}

print(f"{len(PAIRS)} candidate pairs. The first one, as the model will see it:")
print(json.dumps({k: PAIRS[0][k] for k in ("entity_a", "entity_b")}, indent=2)[:420])
450 candidate pairs. The first one, as the model will see it:
{
"entity_a": {
"name": "C N Red Imperial Red Ale",
"brewery": "Redwood Lodge",
"style": "American Amber / Red Ale",
"abv": "8.10 %"
},
"entity_b": {
"name": "Kinetic Infrared Imperial Red Ale",
"brewery": "Kinetic Brewing Company",
"style": "American Strong Ale",
"abv": "9.30 %"
}
}Stelle eine Score-Frage und drei Noul-Fragen pro Kandidatenpaar
Beide Entitäten gehen in einen einzigen Zustand ein, als entity_a und entity_b, sodass die Fragen das Paar betreffen und nicht eine der beiden Seiten für sich. Alle vier fahren in einer einzigen Anfrage.
Die drei Beschreibungen auf den einzelnen Ebenen bilden die gesamte Entscheidung: Jede Ebene entspricht einem Ergebnis. Es gibt keine Schwellenwert-Konstante irgendwo in dieser Datei. Sie können diese Beschreibungen auch verfassen, bevor Sie einen einzigen Score gesehen haben, was auf eine Zahl, die Sie anpassen müssen, nicht zutrifft.
Die mittlere Ebene ist diejenige, die es sich lohnt, sorgfältig zu verfassen. Sie umfasst hier Varianten, Sonderausgaben und Namen, die plausibel auf beide Produkte verweisen könnten, sodass diese an einen Kurator weitergeleitet werden, anstatt zusammengeführt oder verworfen zu werden.
OUTCOME benennt die drei Ergebnisse. Das Merge-Ergebnis wird assert sameAs genannt, weil
sameAs die Standardmethode ist, um zu dokumentieren, dass zwei Entitäten dasselbe Objekt sind, und das Schreiben
eines solchen Eintrags ist der Vorgang, durch den das Merge tatsächlich stattfindet.
Drei der vier Felder erhalten eine Noul-Frage: Name, Brauerei und Stil. Der Alkoholgehalt
erhält keine, da der Vergleich zweier Zahlen arithmetisch ist; berechnen Sie ihn im Code, wenn Sie ihn möchten.
Um dies auf eine andere Art von Daten anzuwenden, schreiben Sie QUESTIONS und LEVELS um. Der einzige andere
Code, der über Bier Bescheid weiß, sind die beiden Funktionen, die Ergebnisse drucken, die die Felder benennen.
LEVELS = [
    "They describe two different products.",
    "They describe closely related products that may or may not be the same one: "
    "a variant, a special edition, or a name that could plausibly refer to either.",
    "They describe one and the same product.",
]
OUTCOME = {0: "leave unlinked", 1: "curator queue", 2: "assert sameAs"}

QUESTIONS = {
    "link_state": Score(
        instructions="How do the two entity descriptions relate as products?",
        criteria=LEVELS,
    ),
    "same_name": Noul(
        instructions="Do the two entities state the same beer name?",
    ),
    "same_brewery": Noul(
        instructions="Are the two entities from the same brewery?",
    ),
    "same_style": Noul(
        instructions="Do the two entities describe the same beer style?",
    ),
}


@json_cache
def score(pair_id: str) -> dict:
    """One request about one candidate pair -> the score plus the three noul answers."""
    pair = BY_ID[pair_id]
    response = client.system_one(
        state={"entity_a": pair["entity_a"], "entity_b": pair["entity_b"]},
        questions=QUESTIONS,
        model=TYPESAFE_MODEL,
    )
    link = response.answers["link_state"]
    return {
        "score": link.score,
        "probabilities": link.probabilities,
        "confidence": link.confidence,
        "properties": {
            k: response.answers[k].noul for k in QUESTIONS if k != "link_state"
        },
        # tokens and requests are the durable units; don't cache a derived cost
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


def route(score_value: float) -> str:
    """The whole decision rule: the nearest level names the outcome."""
    return OUTCOME[min(int(score_value + 0.5), len(LEVELS) - 1)]


def show(pair_id: str) -> None:
    pair, result = BY_ID[pair_id], score(pair_id)
    print(
        f"{pair_id}  score {result['score']:.2f}  confidence {result['confidence']:.2f}"
        f"  ->  {route(result['score'])}"
    )
    for side in ("entity_a", "entity_b"):
        e = pair[side]
        print(f"    {e['name'][:44]:<46}{e['brewery'][:30]:<32}{e['style'][:22]}")
    nouls = result["properties"]
    print(
        f"    name {nouls['same_name']:.2f}   brewery {nouls['same_brewery']:.2f}   "
        f"style {nouls['same_style']:.2f}"
    )
Vier Paare. c446 ist ein Produkt und c427 sind zwei. Die anderen beiden landen aus unterschiedlichen Gründen in der mittleren Ebene: c100 hat denselben Namen und dieselbe Brauerei, aber die Quellen beschreiben seinen Stil unterschiedlich, während c428 ein Bier mit einer Frucht-und-Hopfen-Variante davon paart.
for pair_id in ("c446", "c427", "c100", "c428"):
    show(pair_id)
    print()
c446 score 1.94 confidence 0.92 -> assert sameAs
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company American Barleywine
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company Barley Wine
name 0.97 brewery 0.99 style 0.81
c427 score 0.03 confidence 0.95 -> leave unlinked
Frost Quake Bourbon Barrel Aged Barley Wine Wellington County Brewery American Barleywine
Lompoc Bourbon Barrel Aged Proletariat Red A Lompoc Brewing Amber Ale
name 0.02 brewery 0.09 style 0.08
c100 score 1.30 confidence 0.27 -> curator queue
Belle Gueule Rousse Brasseurs R.J. American Amber / Red A
Belle Gueule Rousse Brasseurs RJ Amber Lager/Vienna
name 0.95 brewery 0.94 style 0.35
c428 score 1.10 confidence 0.77 -> curator queue
Ambleside Amber Ale Bridge Brewing Company American Amber / Red A
Bridge Ambleside Amber Ale - Pomegranate & G Bridge Brewing Company Amber Ale
name 0.63 brewery 0.98 style 0.74Leite jedes Kandidatenpaar weiter
# 450 candidate pairs, one request each; a small pool keeps a live run to a few minutes.
with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
    scored = list(pool.map(lambda pair: score(pair["id"]), PAIRS))

scores = [result["score"] for result in scored]
by_outcome: dict[str, list[str]] = {name: [] for name in OUTCOME.values()}
for pair, s in zip(PAIRS, scores):
    by_outcome[route(s)].append(pair["id"])

SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

BINS, TOP = 20, len(LEVELS) - 1
counts = [0] * BINS
for s in scores:
    counts[min(int(s / TOP * BINS), BINS - 1)] += 1
centers = [(i + 0.5) / BINS * TOP for i in range(BINS)]
queued = [c if route(x) == "curator queue" else 0 for c, x in zip(counts, centers)]
settled = [c if route(x) != "curator queue" else 0 for c, x in zip(counts, centers)]

fig, ax = plt.subplots(figsize=(7.2, 3.6), facecolor=SURFACE)
ax.set_facecolor(SURFACE)
for side in ("top", "right"):
    ax.spines[side].set_visible(False)
for side in ("left", "bottom"):
    ax.spines[side].set_color(AXIS)
ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
ax.set_axisbelow(True)
ax.grid(axis="y", color=GRID, linewidth=0.8)
ax.bar(
    centers, settled, width=TOP / BINS * 0.9, color=BLUE, label="settled automatically"
)
ax.bar(
    centers, queued, width=TOP / BINS * 0.9, color=ORANGE, label="sent to the curator"
)
for edge in (0.5, 1.5):
    ax.axvline(edge, color=INK2, linewidth=1, linestyle="--")
ax.set_xticks([0, 0.5, 1, 1.5, 2])
ax.set_xticklabels(["0\ndifferent", "0.5", "1\nrelated", "1.5", "2\nsame"])
ax.set_xlabel("score for the pair", color=INK2, fontsize=9)
ax.set_ylabel("candidate pairs", color=INK2, fontsize=9)
ax.set_title(
    f"{len(PAIRS)} candidate pairs, scored once each",
    loc="left",
    color=INK,
    fontsize=11,
)
ax.legend(frameon=False, labelcolor=INK2, fontsize=9)
display(fig)
plt.close(fig)

for name in ("assert sameAs", "curator queue", "leave unlinked"):
    n = len(by_outcome[name])
    print(f"{name:<16}{n:>5}  ({n / len(PAIRS):>5.1%})")
assert sameAs 40 ( 8.9%)
curator queue 50 (11.1%)
leave unlinked 360 (80.0%)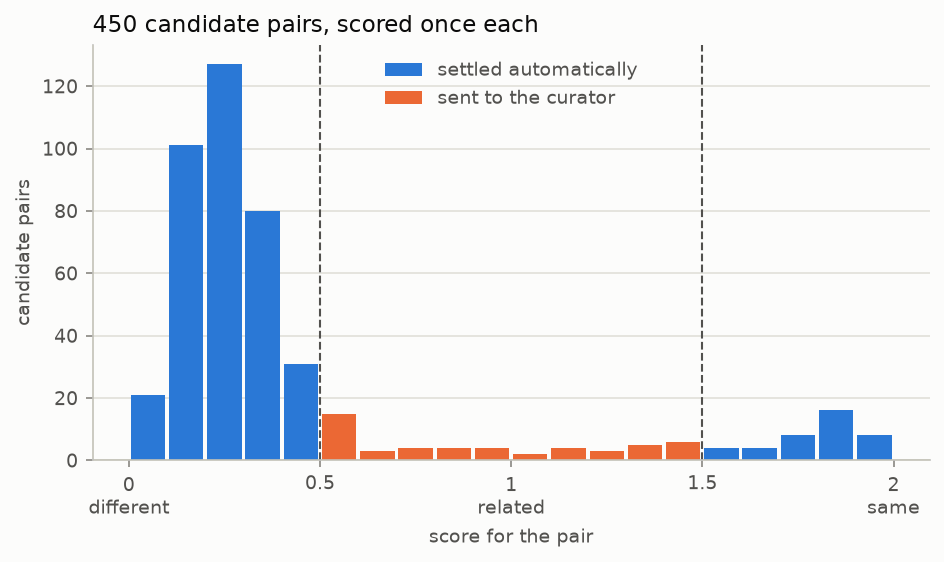
Die beiden Score-Werte, bei denen route() seine Antwort ändert, sind die Schnittstellen. Die meisten Paare einigen sich: 360 Score unterhalb des unteren Schnittwerts und 40 oberhalb des oberen, was dem Kurator 50 übrig lässt.
Auf diesem Datensatz liegen die Scores nicht sauber auf den ganzen Zahlen. Die meisten liegen nahe bei 0,25. Zwei Biere ohne gemeinsame Merkmale können dennoch einen gemeinsamen Stilnamen tragen, und ihre Brauereinamen könnten ähnlich aussehen, sodass das Modell der mittleren Stufe einen Teil seiner Wahrscheinlichkeit zuweist, anstatt null. Was entscheidet, auf welcher Seite eines Schwellenwerts ein Paar liegt, ist die Frage, ob es darüber oder darunter fällt. Wie nah es an einer Stufe liegt, fließt nicht in die Entscheidung ein.
Die beiden Schnittstellen sind nicht gleich stark frequentiert. Neun Paare liegen innerhalb von 0,1 bei der oberen, bei 1,5, die entscheidet, was in den Graphen übernommen wird. Vierundvierzig Paare liegen entsprechend nah an der unteren, bei 0,5, die lediglich bestimmt, ob ein Kurator das Paar zu sehen bekommt. Keine der beiden Zahlen ist ein Parameter, den du einstellst. Beide ergeben sich daraus, wie du die Stufen formuliert hast, und die Formulierung der mittleren Stufe bestimmt, welche Paare zwischen dem Kurator und den unverknüpften Paaren hin- und herwandern.
Öffnen Sie es im Playground
Der Playground-Link unten öffnet c428, das 1.10 Punkte erreichte und an den Kurator ging.
Es kombiniert Ambleside Amber Ale mit Bridge Ambleside Amber Ale - Pomegranate & Galena
Hops: gleiche Brauerei, gleicher Alkoholgehalt. Alle vier Fragen werden damit beantwortet.
playground_link = make_playground_link(
    {"entity_a": BY_ID["c428"]["entity_a"], "entity_b": BY_ID["c428"]["entity_b"]},
    QUESTIONS,
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this pair + questions in the TypeSafe playground]({playground_link})"
    )
)