 JevCode
Neuordnung
Erstellt 30-Passage-BM25-Kurzlisten für 40 CLERC-Rechtsfragen und verwendet dann eine TypeSafe-Frage pro Frage-Kandidaten-Paar, um die Top-1-Genauigkeit von 5 % auf 18 % und die Top-10-Genauigkeit von 38 % auf 62 % zu steigern.
Maschinell aus en übersetzt, nicht lektoriert. Nur als Kurzreferenz geeignet.

Sie haben Tausende von Dokumenten und müssen dasjenige finden, das eine bestimmte Frage beantwortet. Wie finden Sie es also?
Verwende zunächst eine schnelle Methode wie das Keyword-Matching, um diese Tausenden von Kandidaten auf eine kurze Liste plausibler Optionen zu reduzieren. Wir nennen dies die schnelle Suche.
Schnelle Suche ist dabei gut, kann aber nicht sagen, welcher Kandidat auf der Shortlist korrekt ist. Hier kommt das Re-Ranking ins Spiel. Es bewertet jeden Kandidaten auf der Shortlist direkt anhand der Query und stellt den besten an erste Stelle.
Beide Schritte werden auf 3.565 Passagen aus Gerichtsurteilen des CLERC-Datensatzes ausgeführt: BM25 erstellt eine schnelle Suchauswahl mit 30 Kandidaten für jede der 40 Abfragen, dann re-rankt TypeSafe jede Auswahl. Mit dem Re-Ranking landet die richtige Passage bei 18 % der Abfragen an erster Stelle, gegenüber 5 % bei der reinen schnellen Suche.
Dabei lernst du:
- Was Fast Search leistet und warum es nicht die gesamte Antwort ist
- Was Re-Ranking ist und wie es nach einem Schritt mit Fast Search einsetzt
- Wie TypeSafe einen Kandidaten gegenüber einer Anfrage bewertet und wie viel das das Ergebnis verbessert
Probieren Sie es selbst aus
Öffnen Sie eine Abfrage-, Kandidaten- und Re-Ranking-Frage im TypeSafe Playground
Wie finden wir ein Dokument in Tausenden?
Sie haben einen Stapel Dokumente und eine Abfrage, einen Text, der beschreibt, wonach Sie suchen. Irgendwo in diesem Stapel befindet sich das eine Dokument, das die Antwort darauf liefert.
Das Überprüfen jedes Dokuments gegen die Abfrage nacheinander funktioniert, mit einem Vergleich pro Dokument: Millionen von Dokumenten bedeuten Millionen von Vergleichen pro Abfrage. Sie können die Leistung mit einem zweistufigen Ansatz verbessern:
- Reduziere die Liste auf eine kurze Auswahl wahrscheinlicher Kandidaten, indem du eine Methode verwendest, die schnell genug ist, um über die gesamte Liste zu laufen.
- Wende auf diese kurze Liste einen genaueren Schritt an, um die exakt richtige Antwort zu finden.
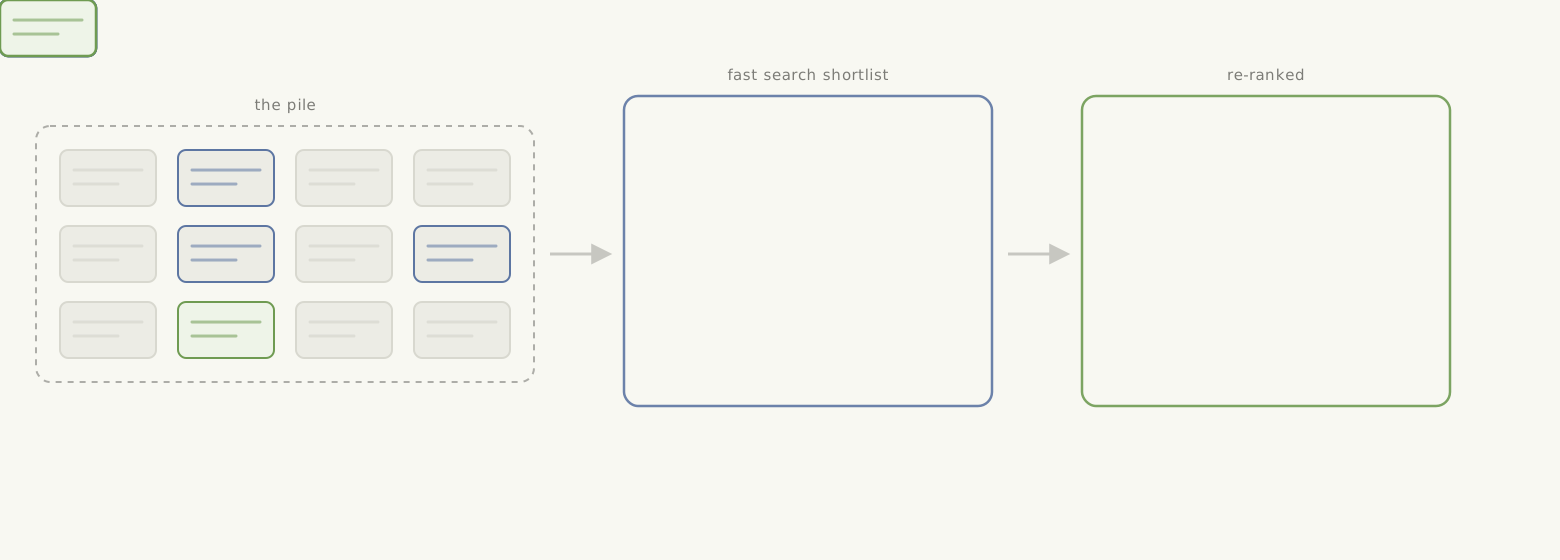
Dieses Kochbuch testet diese Konfiguration an einem Datensatz von Gerichtsentscheidungen, in Neu-Ranking an einem echten Beispiel unten.
Was ist Fast Search?
Schnellsuche ist jede Methode, die eine Abfrage gegen jedes Dokument in einem großen Korpus vergleichen und schnell eine kurze, rangierte Liste zurückgeben kann. Zu den gängigen Methoden gehören die Schlüsselwortsuche, wie BM25, und dichte Embeddings, die Passagen nach ihrer Bedeutung vergleichen. Systeme kombinieren oft beide Methoden.
Der erste Schritt hier ist BM25 und nichts anderes. BM25 rangiert Passagen nach gemeinsamen Wörtern. Die Einfachheit dieses Schritts lenkt die Aufmerksamkeit auf das Re-Ranking, was der Kern des Cookbooks ist. Die Wahl der schnellen Suchmethode ist ein Nebenaspekt: Re-Ranking sieht nur die Passagen, die die Shortlist bilden.
Was ist Re-Ranking?
Das Re-Ranking nimmt die bereits erzeugte Kurzliste des schnellen Suchlaufs und ordnet sie in einer besseren Reihenfolge an. Anstatt die Abfrage gegen den gesamten Korpus auf einmal zu vergleichen, wird die Abfrage gegen jeden Kandidaten in der Kurzliste einzeln verglichen und die Kurzliste nach diesem Ergebnis sortiert.
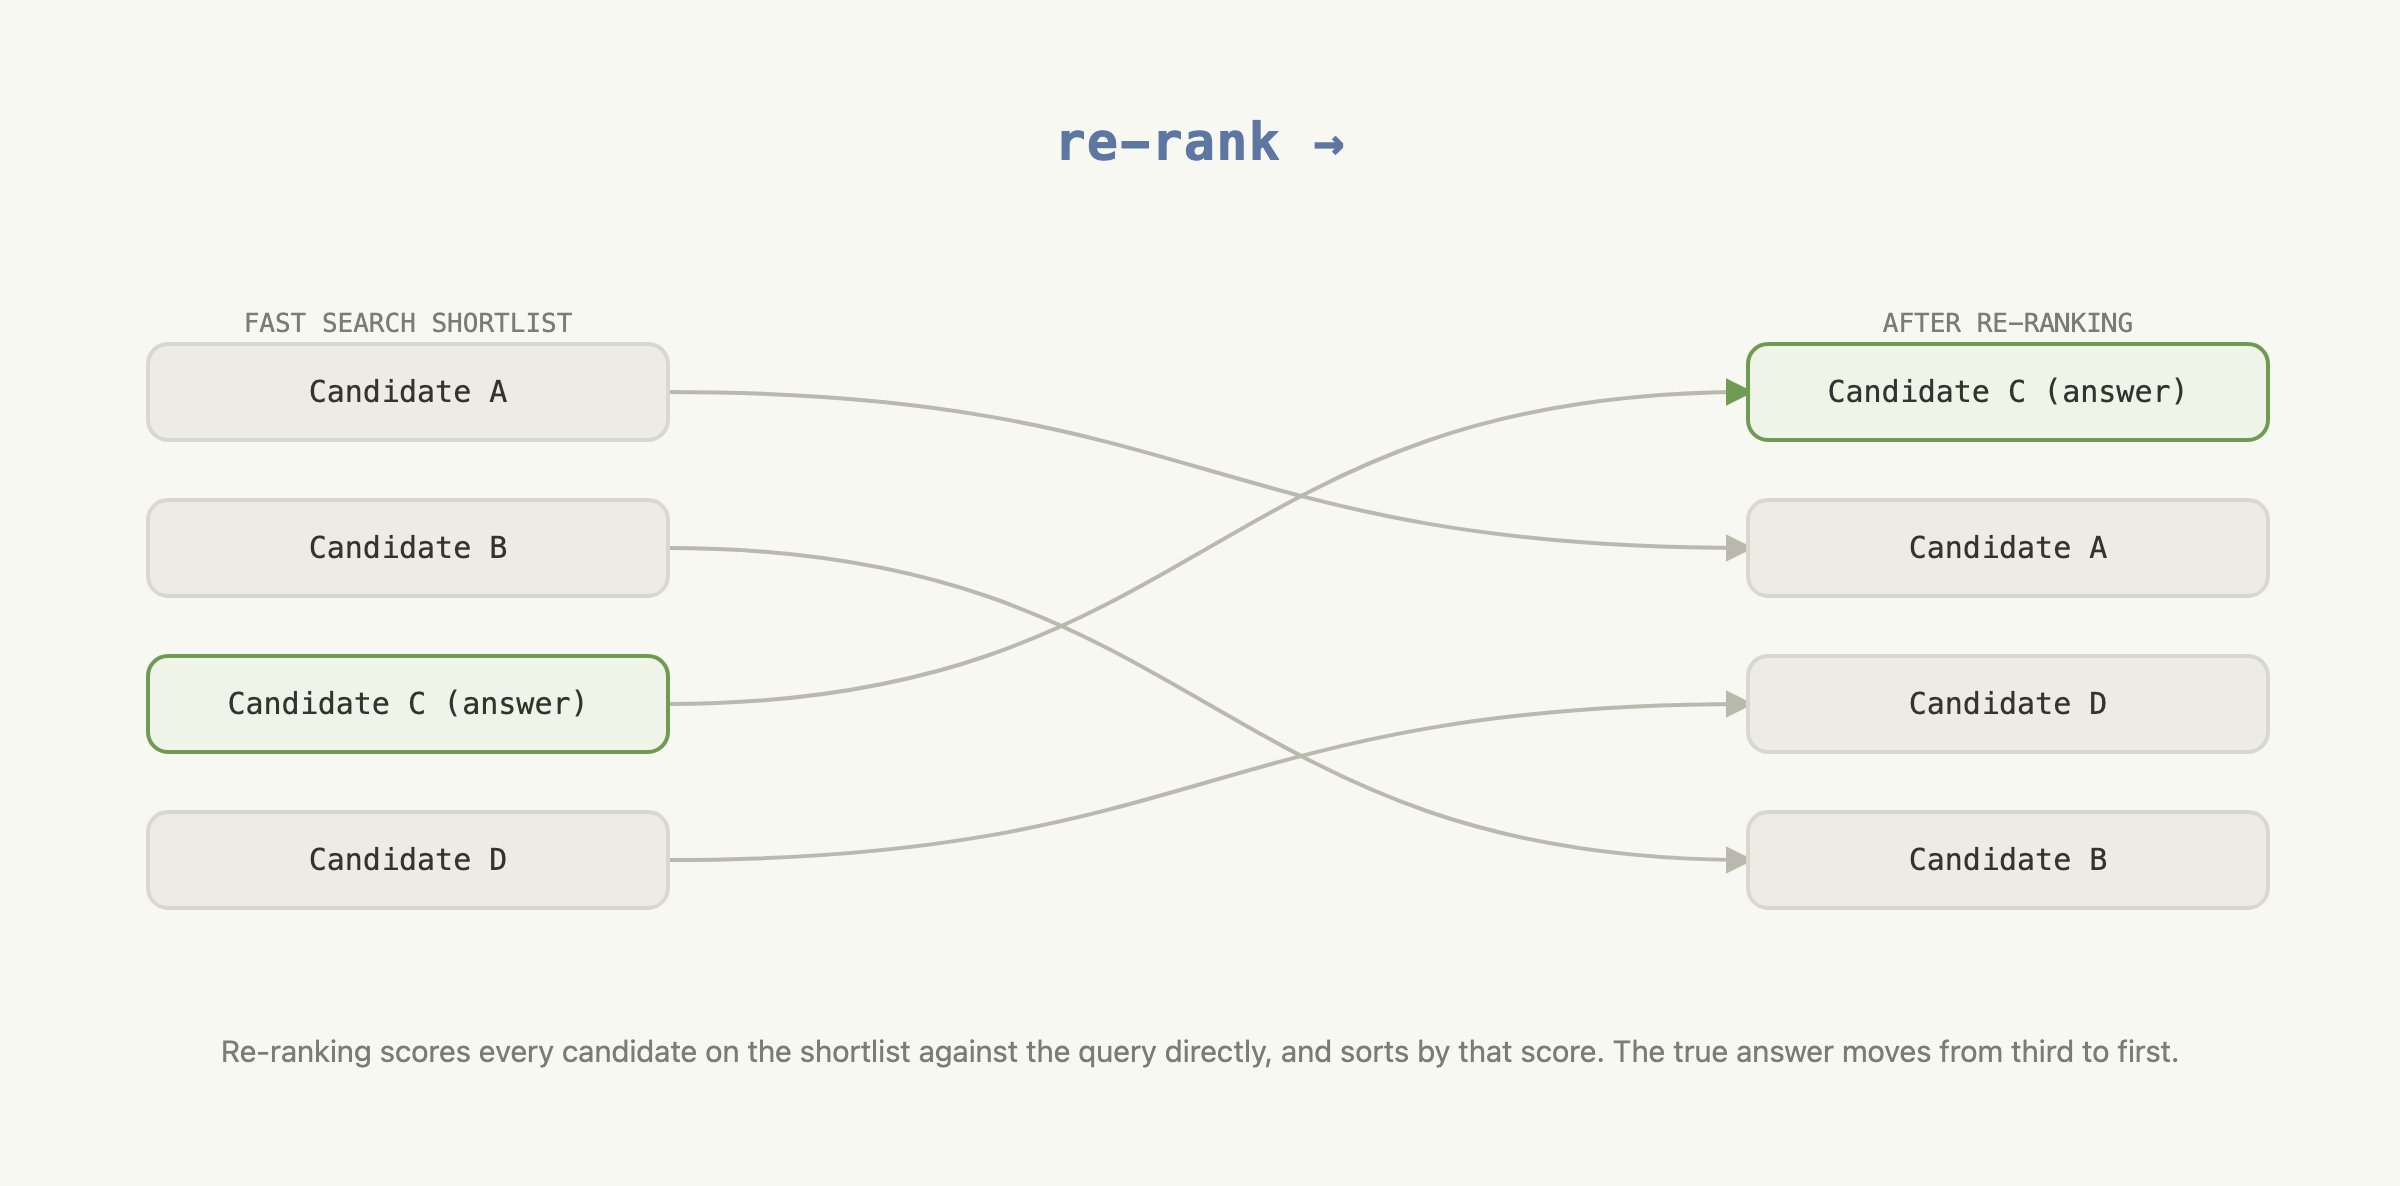
Die Bewertung kann von einem Sprachmodell stammen. Übergebe ihm die Anfrage und einen Kandidaten zusammen und frage, wie gut der Kandidat die Anfrage beantwortet. Das Re-Ranking findet dann die beste Übereinstimmung auf der Shortlist, auch wenn sich die Formulierung von der der Anfrage unterscheidet.
Neusortierung mit TypeSafe
Ein Re-Ranker benötigt für jedes Query-Kandidaten-Paar einen vergleichbaren Score. Ein Allzweck-Sprachmodell kann diese Scores erzeugen oder die gesamte Shortlist direkt rangieren. Für die unabhängige Paar-Bewertung müssen Sie jedoch eine Bewertungsskala definieren und das Modell anweisen, den gleichen Standard auf jeden Kandidaten anzuwenden. Wiederholte Aufrufe können dennoch unterschiedliche Scores für dasselbe Paar ergeben, während die allgemeine Generierung Zeit und Kosten für eine Aufgabe hinzufügt, die nur eine einzige Zahl benötigt.
Was TypeSafe zurückgibt
Mit TypeSafe kann die Scoring-Anfrage eine Ja/Nein-Frage bleiben:
Could this candidate passage be from the cited precedent?Ein einfaches Ja oder Nein reicht nicht aus, um 30 Kandidaten zu bewerten. Ein Noul gibt stattdessen eine Zahl zwischen 0 und 1 zurück, die als
noul bezeichnet wird. Der Noul ist die TypeSafe-Schätzung dafür, wie wahrscheinlich die Antwort „Ja“ ist.
Die Kriterien der Frage definieren, was als wahr und falsch gilt. TypeSafe wendet sie auf jedes Anfrage-Kandidaten-Paar an und gibt das Noul direkt zurück. Dieses Noul ist die Punktzahl, nach der die Anwendung sortiert. Es muss keine Bewertungsskala für ein Allzweckmodell erfunden werden, und TypeSafe ist darauf ausgelegt, diese wiederholte Bewertung schneller, günstiger und konsistenter durchzuführen.
In vereinfachtem Pseudocode sieht ein TypeSafe-Score-Aufruf so aus:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe liest die Abfrage und einen Kandidaten gemeinsam gegen diese Frage aus und gibt ein Noul zurück.
Sie können dies verwenden, um eine Vorauswahl neu zu sortieren, indem Sie dieselbe Frage gegen jeden Kandidaten darin ausführen und die Vorauswahl dann nach dem noul sortieren, das jeder Aufruf zurückgibt, beginnend mit dem höchsten.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
Das folgende Diagramm zeigt, wie eine Anfrage pro Kandidat die zur Neuanordnung der Vorauswahl verwendeten Scores erzeugt.
Richtung des Flusses: LR
| Knoten | Beschreibung | Gruppe |
|---|---|---|
q |
Abfrageauszug / ein Meinungsabschnitt, / Zitat entfernt | — |
sl |
Vorauswahl aus der schnellen Suche / 30 Kandidatenabschnitte | — |
quest |
ein Noul / könnte dieser Kandidat / aus dem zitierten Präzedenzfall stammen? / Kriterienkorrektur wahr und falsch | — |
fan |
eine Anfrage pro Kandidat · keine Anfrage sieht eine andere | eine Anfrage pro Kandidat · keine Anfrage sieht eine andere |
sort |
sortiert nach Noul, / höchste zuerst | — |
out |
neu bewertete Vorauswahl / dieselben 30, bessere Reihenfolge | — |
| Von | Bedingung | Zu |
|---|---|---|
q |
— | fan |
sl |
— | fan |
quest |
— | fan |
fan |
— | sort |
Ein Beispiel für das Re-Ranking
Schnelle Suche und Neurangierung laufen jetzt auf CLERC, einem juristischen Retrieval-Datensatz. Dieses Beispiel verwendet 3.565 Passagen von Gerichtsentscheidungen und 40 Abfragen.
Setup
Der erste Schritt installiert die Pakete, von denen diese Anleitung abhängt.
bm25sunddatasetserstellen die schnelle Suchkürzellauswahl.typesafe-sdkundcooksafeübernehmen das Re-Ranking und das API-Caching.matplotliberstellt die Ergebnisdiagramme.
pip install bm25s datasets matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Der nächste Block richtet den TypeSafe-Client ein und definiert die Konstanten, die der Rest der Anleitung verwendet, etwa welches TypeSafe-Modell aufgerufen werden soll und wie groß die von der schnellen Suche an den Re-Ranker übergebene Shortlist ist. Für den Aufruf von TypeSafe wird ein TYPESAFE_API_KEY benötigt.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import msgspec
from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Rangfolge der Passagen mit schneller Suche
Der hier verwendete Datensatz ist ein Korpus aus US-amerikanischen Gerichtsentscheidungen, bestehend aus 170 zusammengeführten Zeilen. Jede Zeile setzt sich wie folgt zusammen:
- Abfrage: ein Meinungs-Auszug mit entfernter Zitation.
- Gold: der Passus, auf den die entfernte Zitation verwies, die eine korrekte Antwort auf die Abfrage.
- Kandidaten: jeder andere Passus im Korpus, jeweils etwas, gegen das die Abfrage versehentlich abgeglichen werden könnte.
Von den 170 Zeilen werden 40 zur Auswertung als Abfragen ausgewählt. Die anderen 130 treten ausschließlich als Kandidaten auf.
Die nächste Zelle erstellt die Shortlist, indem sie die oben beschriebene Technik verwendet:
- Laden Sie das Korpus.
- Rängen Sie es gegen jede Abfrage mit BM25.
Hier gibt es noch kein TypeSafe, dies ist nur der schnelle Suchschritt.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)


def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]


@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}


def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}


def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None


SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"


def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)


ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)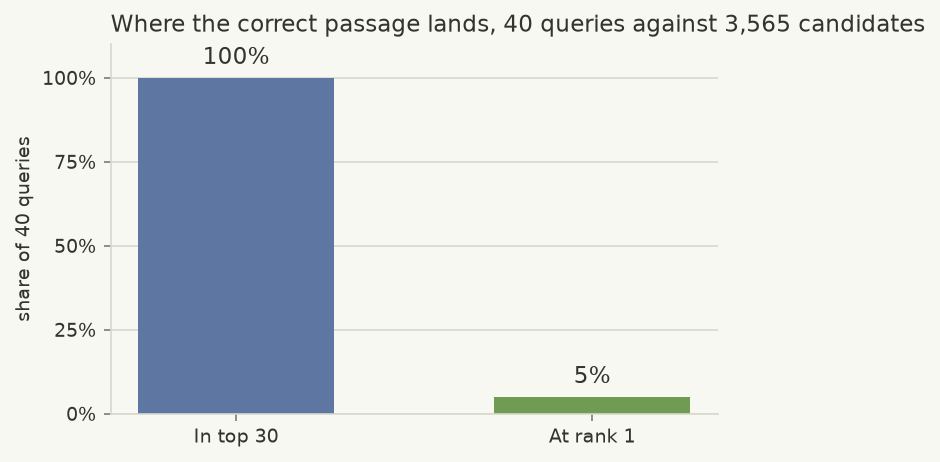
Eine schnelle Suche wird den richtigen Abschnitt wahrscheinlich nicht an erster Stelle einordnen
Das Diagramm zeigt, an welcher Stelle die schnelle Suche den korrekten Abschnitt von 3.565 Kandidaten platziert.
Schnelle Suche reduziert den Korpus zuverlässig auf eine kurze Liste, die die richtige Antwort enthält. Sie enthält die richtige Antwort bei 100 % der 40 Abfragen. Dieser Abschnitt ist jedoch nur in 5 % der Fälle der am höchsten bewertete Eintrag in der kurzen Liste.
Das Re-Ranking unten ordnet nur die bereits auf der Shortlist befindlichen Top-30-Kandidaten neu. Es kann keinen Passus hinzufügen, den die schnelle Suche nicht ausgewählt hat. Hier enthält die Shortlist für alle 40 Anfragen den korrekten Passus, sodass sich das Re-Ranking darauf konzentrieren kann, jeden Passus in eine bessere Position zu bringen.
Re-Ranking mit TypeSafe
Die Neubewertung vergleicht jeden Kandidaten auf der Shortlist mit seiner Abfrage und sortiert dann nach dieser Bewertung. Die Frage, die TypeSafe zu jedem Paar stellt, ist, ob der Kandidat der Passage entsprechen könnte, auf die die entfernte Zitation der Abfrage verweist.
Die nächste Zelle führt Folgendes aus:
- Definiere diese Frage.
- Stelle sie einmal pro Kandidat auf jeder Shortlist, 40 Abfragen mal 30 Kandidaten, insgesamt 1.200 Aufrufe, führe sie parallel statt nacheinander aus.
- Sortiere jede Shortlist nach dem von TypeSafe zurückgegebenen Score, wodurch das neu rangierte Ergebnis entsteht.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)


@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = msgspec.json.encode(is_cited_source).decode()
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}


def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)


chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.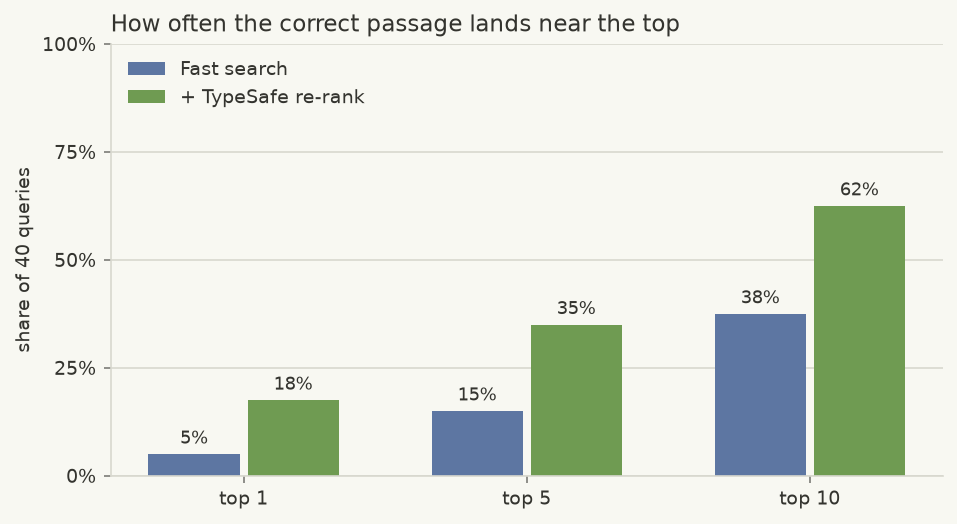
Re-Ranking verschiebt die richtige Antwort an die Spitze
Der Chart vergleicht schnelles Suchen mit schnellem Suchen plus Neurangieren, an drei Schwellenwerten. Das Neurangieren bringt den korrekten Passus an jeder dieser Schwellen näher an die Spitze:
- Top 1 — 5 % → 18 %
- Top 5 — 15 % → 35 %
- Top 10 — 38 % → 62 %
Die gemeldete Token-Anzahl und die Kosten decken alle 1,200 TypeSafe-Aufrufe ab, die zur Neubewertung der 40 Shortlists verwendet wurden.
Jede CLERC-Zeile enthält einen korrekten Textabschnitt und 20 negative Abschnitte. Dieser Leitfaden poolt die Abschnitte aus 170 Zeilen zu einem gemeinsamen Korpus. Für jede der 40 Evaluierungsabfragen wählt BM25 30 Kandidaten aus diesem gesamten Korpus aus, nicht nur die 20 negativen Abschnitte, die mit dieser Zeile bereitgestellt wurden. TypeSafe liest dann die Abfrage gegen jeden ausgewählten Kandidaten und rereankt diese 30 Abschnitte.
Dieser Durchlauf stellte eine Frage pro Paar zur Klarheit. Eine reale Anwendung würde mehrere Fragen zum selben Paar in einem Aufruf stellen. Siehe das Kochbuch für parallele Fragen und das Spekulatives Fan-Out-Muster für die Umsetzung.
Was kommt als Nächstes
Die gleichen Bausteine tauchen auch in den Docs von TypeSafe auf:
- Noul, dafür, wie TypeSafe eine Ja/Nein-Frage in eine Bewertung umwandelt.
- Spekulatives Fan-Out, um mehrere Fragen zu einem Dokument in einem einzigen Aufruf zu stellen.
- Zeilenweise Suche, für eine weitere Möglichkeit, ein Korpus nach Bedeutung statt nach Schlüsselwörtern zu durchsuchen.