 JevCode
Reclasificación
Genera listas cortas de BM25 de 30 pasajes para 40 consultas jurídicas de CLERC, y luego utiliza una pregunta TypeSafe por par consulta-candidato para elevar la precisión en el top-1 del 5% al 18% y la precisión en el top-10 del 38% al 62%.
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

Tienes miles de documentos y necesitas encontrar el que responde a una pregunta específica. Entonces, ¿cómo lo encuentras?
En primer lugar, utiliza un método rápido como la coincidencia de palabras clave para reducir esos miles de candidatos a una lista corta de candidatos plausibles. Llamamos a esto búsqueda rápida.
La búsqueda rápida es buena en eso, pero no puede decirte cuál de los candidatos de la lista corta es correcto. Ahí es donde entra el reordenamiento. Puntuación cada candidato de la lista corta contra la consulta directamente, y pone el mejor primero.
Ambos pasos se ejecutan a continuación sobre 3,565 pasajes de opiniones judiciales del conjunto de datos CLERC: BM25 construye una lista corta de búsqueda rápida de 30 candidatos para cada una de las 40 consultas, luego TypeSafe reordena cada lista corta. Con el reordenamiento, el pasaje correcto ocupa el primer lugar en el 18% de las consultas, frente al 5% con la búsqueda rápida por sí sola.
A lo largo del camino, aprenderás:
- Qué hace la búsqueda rápida y por qué no es la respuesta completa
- Qué es el reordenamiento y cómo se integra después de un paso de búsqueda rápida
- Cómo TypeSafe puntúa un candidato frente a una consulta, y cuánto mejora eso el resultado
Pruébalo tú mismo
Abre una consulta, candidato y pregunta de reordenación en el Playground de TypeSafe
¿Cómo encontramos un documento entre miles?
Tienes un montón de documentos y una consulta, un fragmento de texto que describe lo que estás buscando. En algún lugar del montón se encuentra el único documento que la responde.
Revisar cada documento contra la consulta uno por uno funciona, con una comparación por documento: millones de documentos significan millones de comparaciones por consulta. Puedes mejorar el rendimiento con un enfoque de dos pasos:
- Reduce the pile to una lista corta de candidatos probables, utilizando un método lo suficientemente rápido para ejecutarse sobre toda la pila.
- Aplicar un paso más preciso a esa lista corta, para encontrar la respuesta exacta correcta.
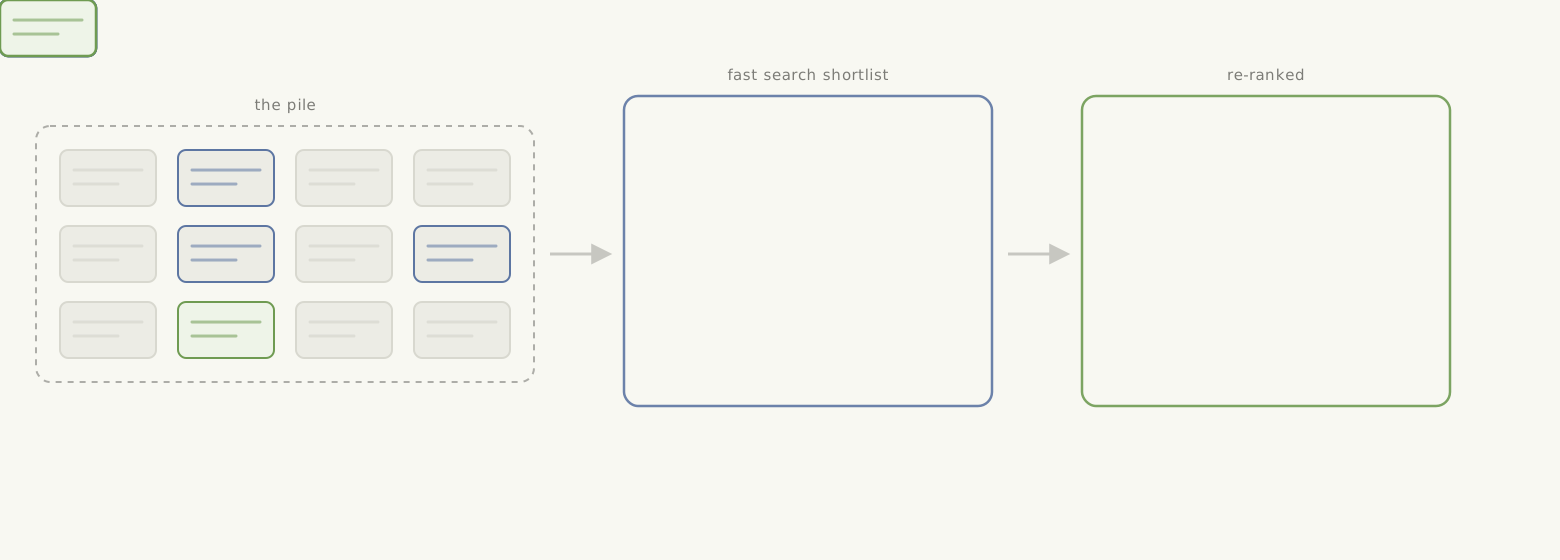
Este cookbook prueba que la configuración en un conjunto de datos de opiniones judiciales, en Re-ranking en un ejemplo real a continuación.
¿Qué es la búsqueda rápida?
La búsqueda rápida es cualquier método que pueda comparar una consulta contra cada documento en un gran corpus y devolver rápidamente una lista corta clasificada. Los métodos comunes incluyen la búsqueda por palabras clave, como BM25, y las incrustaciones densas, que comparan pasajes por significado. Los sistemas suelen combinar ambos métodos.
El primer paso aquí es BM25 y nada más. BM25 clasifica los fragmentos por palabras compartidas. Mantener este paso simple deja la atención en el reordenamiento, que es el objetivo del cookbook. La elección del método de búsqueda rápida es un tema secundario: el reordenamiento solo ve los fragmentos que forman la lista corta.
¿Qué es el reordenamiento?
El reordenamiento toma la lista rápida de búsqueda ya producida y la coloca en un mejor orden. En lugar de comparar la consulta contra todo el corpus a la vez, compara la consulta contra cada candidato de la lista individualmente, y ordena la lista por esa puntuación.
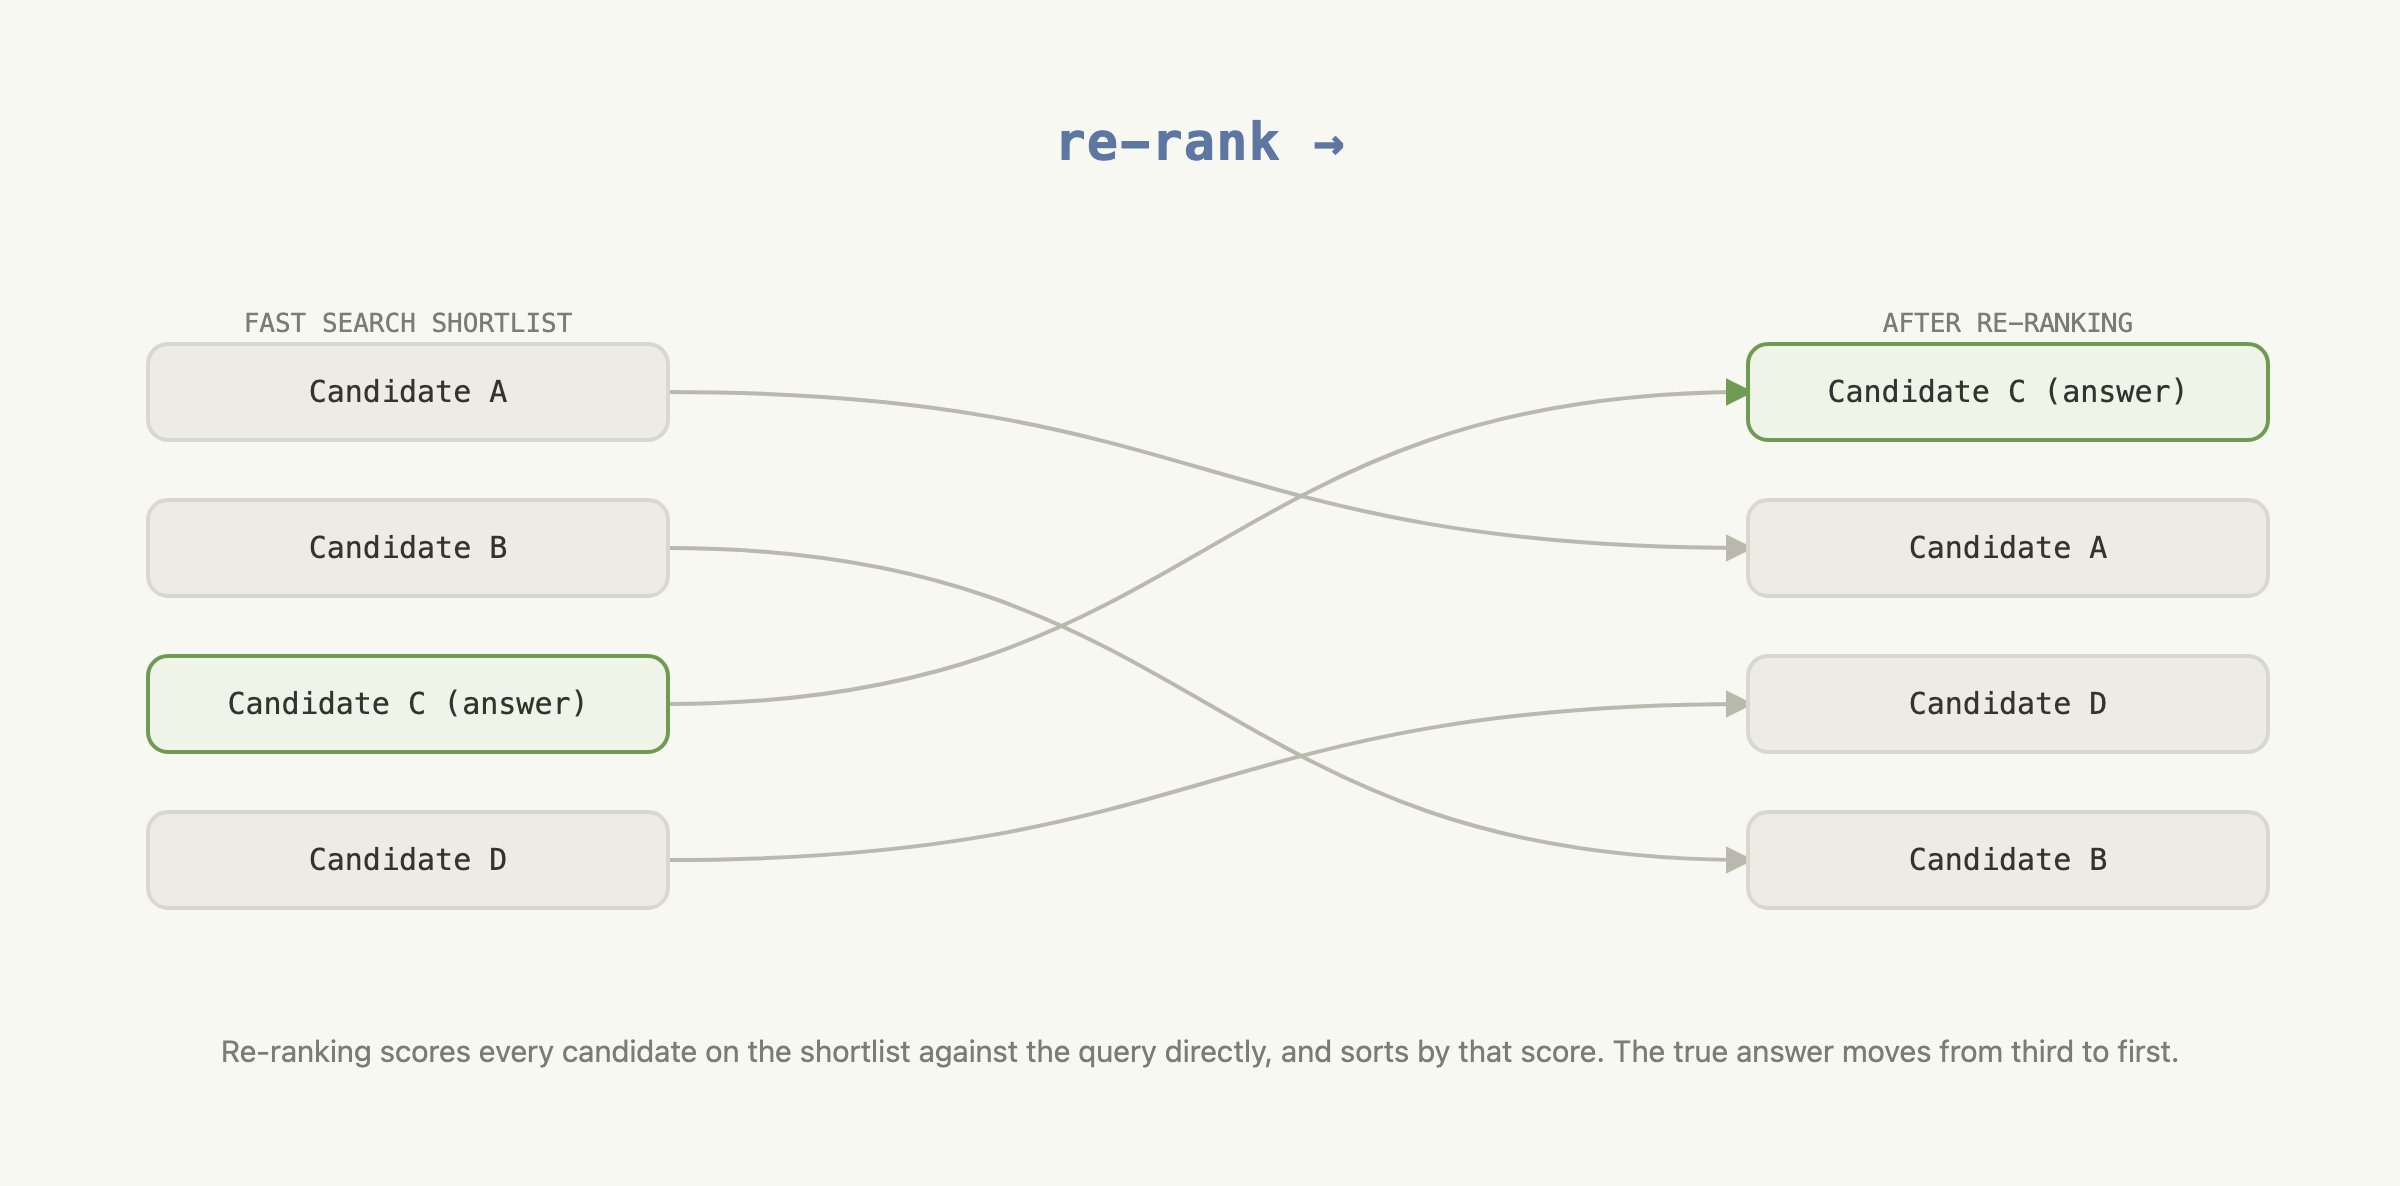
La puntuación puede provenir de un modelo de lenguaje. Proporciónale la consulta y un candidato juntos y pregunta qué tan bien el candidato responde a la consulta. El reordenamiento luego encuentra la mejor coincidencia en la lista corta incluso cuando su redacción difiere de la de la consulta.
Reordenamiento con TypeSafe
Un reordenador necesita una puntuación comparable para cada par consulta-candidato. Un modelo de lenguaje de propósito general puede producir estas puntuaciones, o ordenar toda la lista corta directamente. Sin embargo, para la puntuación independiente de pares, necesitas definir una escala de puntuación y solicitar al modelo que aplique el mismo estándar a cada candidato. Las llamadas repetidas aún pueden producir puntuaciones diferentes para el mismo par, mientras que la generación de propósito general añade tiempo y coste a una tarea que solo necesita un número.
Lo que devuelve TypeSafe
Con TypeSafe, la solicitud de puntuación puede seguir siendo una pregunta de sí/no:
Could this candidate passage be from the cited precedent?Un simple sí o no no sería suficiente para clasificar a 30 candidatos. Un Noul en su lugar
devuelve un número entre 0 y 1, llamado
noul. El noul es la estimación de TypeSafe
sobre qué tan probable es que la respuesta sea sí.
Los criterios de la pregunta definen qué cuenta como verdadero y falso. TypeSafe los aplica a cada par consulta-candidato y devuelve el noul directamente. Ese noul es la puntuación en la que la aplicación ordena. No hace falta inventar una escala de puntuación para un modelo de propósito general, y TypeSafe está diseñado para hacer esta puntuación repetida más rápido, más barato y de forma más consistente.
En pseudocódigo simplificado, una llamada de puntuación TypeSafe se ve así:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe lee la consulta y un candidato juntos en relación con esa pregunta, y devuelve un noul.
Puedes usar esto para reordenar una lista corta ejecutando la misma pregunta contra cada candidato en ella, luego ordenando la lista corta por el noul que devuelve cada llamada, de mayor a menor.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
El diagrama siguiente muestra cómo una solicitud por candidato produce las puntuaciones utilizadas para reordenar la lista corta.
Dirección del flujo: LR
| Nodo | Descripción | Grupo |
|---|---|---|
q |
fragmento de consulta / un pasaje de opinión, / cita eliminada | — |
sl |
lista corta de la búsqueda rápida / 30 pasajes candidatos | — |
quest |
un Noul / podría este candidato ser / del precedente citado? / corrección de criterios verdadero y falso | — |
fan |
una solicitud por candidato · ninguna solicitud ve a otra | una solicitud por candidato · ninguna solicitud ve a otra |
sort |
ordenar por Noul, / primero los más altos | — |
out |
lista corta reordenada / mismos 30, mejor orden | — |
| De | Condición | A |
|---|---|---|
q |
— | fan |
sl |
— | fan |
quest |
— | fan |
fan |
— | sort |
Un ejemplo de reordenación
La búsqueda rápida y el reordenamiento ahora se ejecutan en CLERC, un conjunto de datos de recuperación legal. Este ejemplo utiliza 3.565 pasajes de opiniones judiciales y 40 consultas.
Configuración
El primer paso instala los paquetes de los que depende este recorrido.
bm25sydatasetsconstruyen la lista corta de búsqueda rápida.typesafe-sdkycooksafegestionan el reordenamiento y el caché de la API.matplotlibdibuja los gráficos de resultados.
pip install bm25s datasets matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/El siguiente bloque configura el cliente TypeSafe y las constantes que el resto del recorrido utiliza, como qué modelo TypeSafe llamar y qué tamaño tiene una lista corta de búsqueda rápida que se entrega al reordenador. Llamar a TypeSafe requiere un TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import msgspec
from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Clasificación de los pasajes con búsqueda rápida
El conjunto de datos utilizado aquí es un corpus de opiniones de tribunales de EE. UU., con 170 filas agrupadas. Cada fila se desglosa de la siguiente manera:
- Consulta: un fragmento de opinión con una cita eliminada.
- Oro: el pasaje al que apuntaba la cita eliminada, la única respuesta correcta a la consulta.
- Candidatos: cada otro pasaje en el corpus, cada uno algo con lo que la consulta podría emparejarse por error.
De las 170 filas, se seleccionan 40 para evaluar como consultas. Las otras 130 solo aparecen como candidatas.
La siguiente celda construye la lista corta, utilizando la técnica descrita anteriormente:
- Cargar el corpus.
- Clasificarlo contra cada consulta con BM25.
Aquí aún no hay TypeSafe, esto es solo el paso de búsqueda rápida.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)


def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]


@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}


def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}


def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None


SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"


def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)


ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)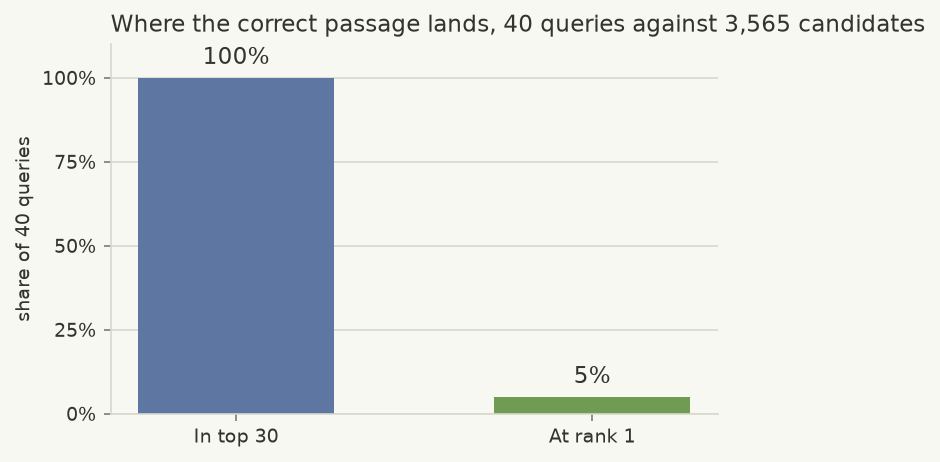
Es poco probable que la búsqueda rápida clasifique el pasaje correcto en primer lugar
El gráfico muestra dónde coloca la búsqueda rápida el pasaje correcto, de entre 3.565 candidatos.
La búsqueda rápida reduce de forma fiable el corpus a una lista corta que contiene la respuesta correcta. Contiene la respuesta correcta para el 100% de las 40 consultas. Pero ese pasaje rara vez es el de mayor rango en la lista corta, solo el 5% de las veces.
El reordenamiento posterior solo reordena los 30 primeros candidatos que ya estaban en la lista corta. No puede añadir un pasaje que la búsqueda rápida no haya seleccionado. Aquí, la lista corta contiene el pasaje correcto para las 40 consultas, por lo que el reordenamiento puede centrarse en colocar cada uno en una posición mejor.
Reordenamiento con TypeSafe
Re-ordenación de puntuaciones para cada candidato de la lista corta frente a su consulta, y luego ordena por esa puntuación. La pregunta que TypeSafe hace sobre cada par es si el candidato podría ser el pasaje al que apunta la cita eliminada de la consulta.
El siguiente celda hace lo siguiente:
- Define esa pregunta.
- Hazla una vez por candidato en cada lista corta, 40 consultas por 30 candidatos, 1,200 llamadas en total, ejecútalas en paralelo en lugar de una tras otra.
- Ordena cada lista corta según la puntuación que devuelve TypeSafe, produciendo el resultado reordenado.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)


@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = msgspec.json.encode(is_cited_source).decode()
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}


def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)


chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)
1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.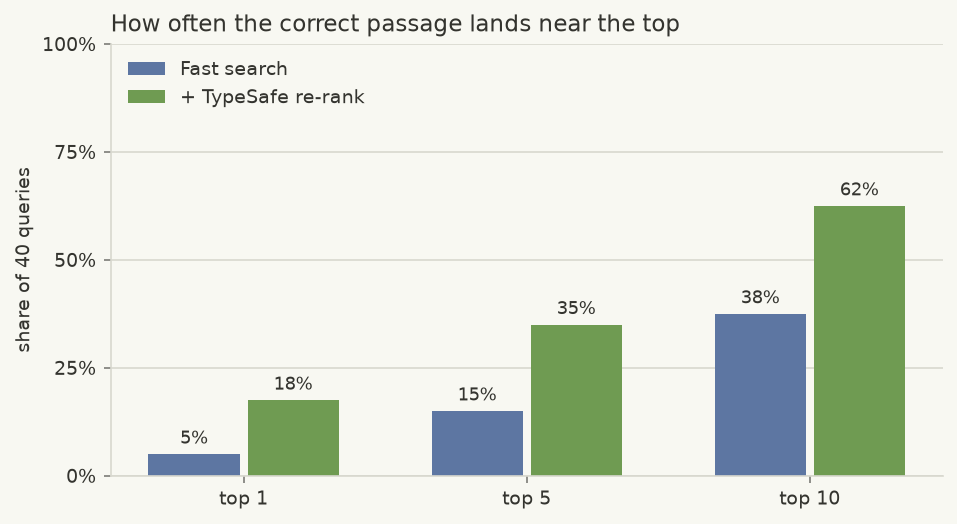
Re-ranking mueve la respuesta correcta hacia la parte superior
El gráfico compara la búsqueda rápida frente a la búsqueda rápida con reordenamiento, en tres umbrales. El reordenamiento acerca el fragmento correcto a la parte superior en cada uno de ellos:
- Top 1 — 5% → 18%
- Top 5 — 15% → 35%
- Top 10 — 38% → 62%
El conteo de tokens y el coste reportados cubren las 1,200 llamadas TypeSafe utilizadas para reordenar las 40
Cada fila de CLERC contiene un pasaje correcto y 20 pasajes negativos. Este recorrido agrupa los pasajes de 170 filas en un corpus compartido. Para cada una de las 40 consultas de evaluación, BM25 selecciona 30 candidatos de ese corpus completo, no solo los 20 negativos proporcionados con esa fila. TypeSafe luego lee la consulta contra cada candidato seleccionado y reordena esos 30 pasajes.
Este recorrido planteó una pregunta por par para mayor claridad. Una aplicación real haría varias preguntas sobre el mismo par en una sola llamada. Consulta el cookbook de preguntas paralelas y el patrón de Fan-Out especulativo para saber cómo.
Qué sigue
Los mismos bloques de construcción aparecen en otras partes de la documentación de TypeSafe:
- Noul, para entender cómo TypeSafe convierte una pregunta de sí/no en una puntuación.
- Fan-Out especulativo, para hacer varias preguntas sobre un mismo documento en una sola llamada.
- Búsqueda línea por línea, para otra forma de buscar en un corpus por significado en lugar de palabras clave.