 JevCode
Llamada de funciones
Convierte las solicitudes de negociación en lenguaje natural en llamadas a funciones tipadas ordinarias, asignando los nombres de las funciones y los argumentos de un conjunto cerrado a preguntas TypeSafe con conciencia de la confianza.
Traducido automáticamente del en, sin revisión. Solo como referencia rápida.

Cuando pides un “latte iced grande con leche de avena y sin edulcorante”, el barista no escribe tu frase. Marca cuatro opciones en un vaso. Este libro de recetas hace lo mismo con una API de trading: entra una frase y sale un nombre de función y sus argumentos evaluados como enums, cada uno con una confianza.
"plot rolling correlation between nvda and spy for the past month"
    rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo')   confidence 0.91

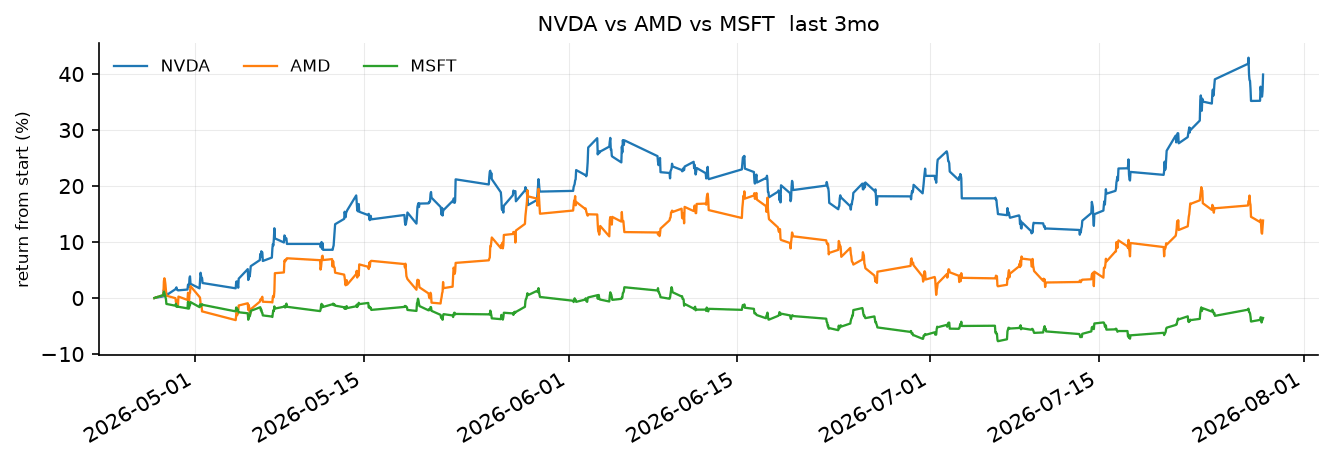
"compare nvda amd and msft over the past three months"
    compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo')      confidence 0.94

"show me apple daily with volume"
    plot_price(symbol='AAPL', resolution='1d', include_volume=True)     confidence 0.75

"what tickers do you have"
    list_symbols()                                                     confidence 1.00
Esas llamadas van a diez funciones ordinarias en un asistente de trading. Sus argumentos toman valores de listas fijas, por lo que ya son Literal:
def plot_price(
    symbol: Literal["SPY", "NVDA", "AMD", "AAPL", "MSFT", "TSLA"],
    style: Literal["line", "candles"] = "line",
    resolution: Literal["1m", "5m", "15m", "1h", "1d"] = "15m",
    window: Literal["1d", "1w", "1mo", "3mo"] = "1w",
    include_volume: bool = False,
    moving_average: Literal["9", "20", "50"] | None = None,
    log_scale: bool = False,
): ...
Un argumento cuyos valores provienen de una lista fija es un conjunto cerrado. Cuando toma un valor
de esa lista, obtiene una pregunta Choice sobre exactamente esos valores, por lo que lo que
llega a la función es un valor que la función acepta. Dejas las funciones tranquilas. Lo
que añades es una especificación que dice en palabras llanas qué significa cada argumento. Al final tienes un
Dispatcher al que puedes señalar tus propias funciones.
Configuración
pip install ipython polars matplotlib numpy "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Conjunto TYPESAFE_API_KEY. Dos módulos se encuentran junto a este archivo. trader.py contiene las diez
funciones, además de un cliente TypeSafe que lee las respuestas desde una caché, por lo que el re-renderizado reproduce
los números de abajo sin llamar a la API. dispatch.py contiene el código que lee una
firma y una especificación y realiza la llamada.
import json
from pathlib import Path

from cooksafe import make_playground_link
from dispatch import ROUTE, Dispatcher, closed_sets
from IPython.display import Markdown, display
from trader import TOOLS, client, load

TYPESAFE_MODEL = "jev-1.12"
print(f"{len(TOOLS)} functions over {load().height:,} one-minute bars")
10 functions over 156,780 one-minute barsEncuentra los conjuntos cerrados en las firmas
Las anotaciones de tipo ya indican cuáles argumentos provienen de una lista fija y qué hay en cada
lista. closed_sets lee una firma y ordena esos argumentos en tres formas: una
elección (un Literal, por lo que un valor de la lista), un conjunto (un list[Literal[...]],
por lo que cualquier número de ellos) o una bandera (un bool, por lo que encendido o apagado). Las diez funciones están
definidas en trader.py.
for name, fn in TOOLS.items():
    shapes = closed_sets(fn)
    print(
        f"  {name:<20}{len(shapes)}  "
        + ", ".join(f"{a}:{s}" for a, (s, _) in shapes.items())
    )
print(
    f"\n{sum(len(closed_sets(fn)) for fn in TOOLS.values())} fillable arguments in total"
)
list_symbols 0
market_summary 1 window:choice
plot_price 7 symbol:choice, style:choice, resolution:choice, window:choice, include_volume:flag, moving_average:choice, log_scale:flag
intraday_pattern 3 symbol:choice, window:choice, metric:choice
compare_returns 3 symbols:set, window:choice, normalize:flag
rolling_correlation 4 symbol:choice, benchmark:choice, window:choice, resolution:choice
summary_stats 2 symbol:choice, window:choice
volatility 3 symbol:choice, window:choice, annualized:flag
top_movers 2 window:choice, direction:choice
drawdown 3 symbol:choice, window:choice, plot:flag
28 fillable arguments in totaltop_movers muestra lo que se omite. De sus tres argumentos, dos son conjuntos cerrados. El
tercero, limit, es un int, por lo que nunca recibe una pregunta y mantiene su valor predeterminado de 3. El
texto libre, los números y las fechas funcionan de la misma manera: sin pregunta, y el valor predeterminado de la función se mantiene.
Escribe la especificación
El Literal te proporciona las cadenas "1mo" y "3mo". No indica que un usuario que escribe
“este trimestre” se refiera al segundo. Eso lo establece la especificación. Contiene una pregunta por argumento,
una línea por opción, una descripción por función y una pregunta adicional que elige entre las
funciones. Vive en spec.json, y un LLM puede redactarlo para ti a partir de las firmas.
SPEC = json.loads(Path("spec.json").read_text())
for argument in ("style", "moving_average"):
    print(
        json.dumps(
            {argument: SPEC["functions"]["plot_price"]["arguments"][argument]}, indent=2
        )
    )
{
"style": {
"question": "Does the user want a plain line or candles?",
"stated": "Does the user say how the chart should be drawn, such as a line, candles, or OHLC bars?",
"options": {
"line": "a simple line through the closing prices",
"candles": "a candlestick or OHLC chart, showing each bar's open, high, low and close"
}
}
}
{
"moving_average": {
"question": "How many bars should the moving average cover - nine, twenty, or fifty?",
"stated": "Does the user ask for a moving average or a smoothed line over the candles?",
"options": {
"9": "a nine-bar moving average, a fast one",
"20": "a twenty-bar moving average",
"50": "a fifty-bar moving average, a slow one"
}
}
}Las claves de las opciones son las cadenas que toma la función, por lo que no hace falta que nada mapee una etiqueta de vuelta a un argumento después. stated hace que un argumento sea opcional. Es una segunda pregunta sí/no que pregunta si el comando dice algo sobre ese argumento en absoluto. Cuando la respuesta es no, la llamada omite ese argumento y se aplica el valor predeterminado propio de la función.
Un argumento de conjunto obtiene su pregunta una vez por miembro, con {} que representa el nombre del miembro. "Does the user want {} in the comparison?" se convierte en una pregunta por ticker.
Escribe cada pregunta sobre la idea en lugar de las palabras que podría elegir un usuario, porque la coincidencia se basa en el significado: “is amd tracking nvidia lately” alcanza rolling_correlation aunque ni tracking ni lately aparecen en ningún lugar de spec.json. Evita nombrar una pregunta según su parámetro - "Which resolution?" no le da al comando nada contra lo que hacer coincidir.
Convierte el especificación en preguntas
Dispatcher construye las preguntas a partir de la especificación una sola vez. Cada comando es entonces una única solicitud que incluye la elección de la función y los argumentos de todas las funciones, y el despachador lee únicamente las respuestas de la función elegida.
assistant = Dispatcher(SPEC, TOOLS, client)
print(f"{len(assistant.questions)} questions per command, among them:")
for qid in (
    "__tool__",
    "plot_price.style",
    "plot_price.style?",
    "compare_returns.symbols.NVDA",
):
    question = assistant.questions[qid]
    print(f"  {qid:<30}{question['type']:<8}{str(question['instructions'])[:64]}")
54 questions per command, among them:
__tool__ choice What is the user asking the trading assistant to do?
plot_price.style choice Does the user want a plain line or candles?
plot_price.style? noul Does the user say how the chart should be drawn, such as a line,
compare_returns.symbols.NVDA noul Does the user want NVDA in the comparison?Ejecuta catorce comandos
Una solicitud ocupa una línea, y su confidence es el juicio menos seguro detrás de esa llamada.
COMMANDS = [
    "show nvda 1h",
    "plot rolling correlation between nvda and spy for the past month",
    "when during the day does nvda trade the most",
    "what moved today",
    "what tickers do you have",
    "how did the market do this week",
    "candles for tesla with a 20 period moving average",
    "compare nvda amd and msft over the past three months",
    "how volatile is tsla",
    "biggest losers today",
    "worst drawdown for nvda this quarter, and chart it please",
    "spy stats for the last month",
    "show me apple daily with volume",
    "is amd tracking nvidia lately",
]

CALLS = {command: assistant(command) for command in COMMANDS}
for command, call in CALLS.items():
    print(f'  "{command}"')
    print(
        f"      {str(call):<66}confidence {call.confidence:.2f}"
        f"   tool {call.tool.probability:.2f}"
    )
"show nvda 1h"
plot_price(symbol='NVDA', resolution='1h') confidence 0.78 tool 1.00
"plot rolling correlation between nvda and spy for the past month"
rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo') confidence 0.91 tool 1.00
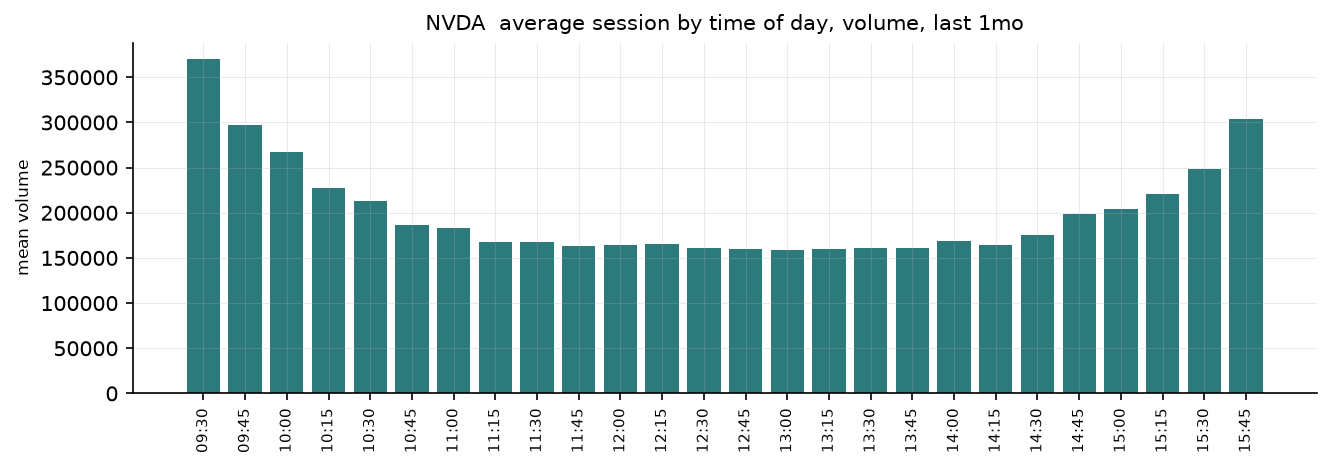
"when during the day does nvda trade the most"
intraday_pattern(symbol='NVDA') confidence 0.53 tool 1.00
"what moved today"
top_movers(window='1d', direction='gainers') confidence 0.90 tool 0.90
"what tickers do you have"
list_symbols() confidence 1.00 tool 1.00
"how did the market do this week"
market_summary(window='1w') confidence 0.96 tool 0.99
"candles for tesla with a 20 period moving average"
plot_price(symbol='TSLA', style='candles', moving_average='20') confidence 0.69 tool 0.97
"compare nvda amd and msft over the past three months"
compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo') confidence 0.94 tool 1.00
"how volatile is tsla"
volatility(symbol='TSLA') confidence 0.96 tool 1.00
"biggest losers today"
top_movers(window='1d', direction='losers') confidence 0.98 tool 0.98
"worst drawdown for nvda this quarter, and chart it please"
drawdown(symbol='NVDA', window='3mo', plot=True) confidence 0.84 tool 0.84
"spy stats for the last month"
summary_stats(symbol='SPY', window='1mo') confidence 0.88 tool 0.88
"show me apple daily with volume"
plot_price(symbol='AAPL', resolution='1d', include_volume=True) confidence 0.75 tool 0.85
"is amd tracking nvidia lately"
rolling_correlation(symbol='AMD', benchmark='NVDA') confidence 0.82 tool 0.82Ambas órdenes largas salieron como se pidió. “plot rolling correlation between nvda and spy for the past month” llenó cuatro argumentos a partir de una sola frase. Dos de ellos, symbol y benchmark, provienen de los mismos seis tickers, y cada ticker cayó en el argumento correcto porque las preguntas especifican los roles: el que se mide, nombrado primero frente al segundo nombrado, la referencia. “compare nvda amd and msft over the past three months” puso tres tickers en el conjunto y dejó fuera los otros tres.
Ejecutando tres de ellos:
for command in (
    "plot rolling correlation between nvda and spy for the past month",
    "compare nvda amd and msft over the past three months",
    "when during the day does nvda trade the most",
):
    print(f'"{command}"  ->  {CALLS[command]}')
    display(CALLS[command].run())
"plot rolling correlation between nvda and spy for the past month" -> rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo')
"compare nvda amd and msft over the past three months" -> compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo')
"when during the day does nvda trade the most" -> intraday_pattern(symbol='NVDA')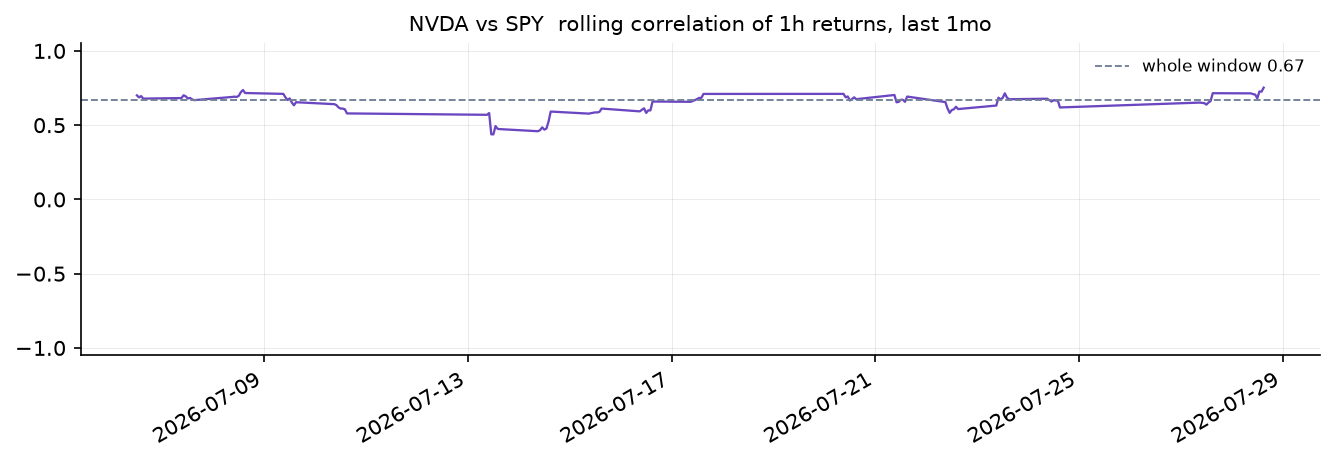
Y aquellos que responden en texto:
for command in ("how did the market do this week", "biggest losers today"):
    print(f'"{command}"  ->  {CALLS[command]}')
    print(CALLS[command].run(), "\n")
"how did the market do this week" -> market_summary(window='1w')
the board over 1w
NVDA 254.12 9.62% 389,465,563
AMD 184.20 1.51% 182,740,497
AAPL 258.71 0.97% 223,818,998
SPY 664.86 0.40% 138,617,365
MSFT 451.35 0.26% 113,427,173
TSLA 320.22 -0.97% 266,317,023
"biggest losers today" -> top_movers(window='1d', direction='losers')
top 3 losers over 1d
AMD -0.57% -> 184.20
MSFT 0.67% -> 451.35
AAPL 1.40% -> 258.71 Lee la confianza
confidence informa del juicio menos seguro en la llamada, en lugar del producto de todos ellos, ya que un solo argumento erróneo es suficiente para arruinar el resultado. Un producto responde a una pregunta diferente (“¿es correcta cada parte”), y disminuye a medida que una función recibe más argumentos, independientemente de si algún juicio individual es inseguro.
De dónde proviene ese número, argumento por argumento:
call = CALLS["is amd tracking nvidia lately"]
print(f'"is amd tracking nvidia lately"  ->  {call}   confidence {call.confidence:.2f}')
for name, argument in call.arguments.items():
    top = sorted(argument.distribution.items(), key=lambda kv: -kv[1])[:3]
    shown = "omitted, default stands" if argument.omitted else repr(argument.value)
    print(
        f"  {name:<12}{shown:<26}p {argument.probability:.2f}   "
        + "  ".join(f"{k} {v:.2f}" for k, v in top)
    )
print(f"  weakest argument: {call.weakest().name}")
"is amd tracking nvidia lately" -> rolling_correlation(symbol='AMD', benchmark='NVDA') confidence 0.82
symbol 'AMD' p 0.87 AMD 0.87 NVDA 0.13 AAPL 0.00
benchmark 'NVDA' p 0.78 NVDA 0.92 AMD 0.08 AAPL 0.00
window omitted, default stands p 0.96
resolution omitted, default stands p 0.99
weakest argument: benchmarkwindow y resolution se omiten aquí, porque «últimamente» no indica cuánto tiempo atrás
ni en qué barras, por lo que rolling_correlation se ejecuta con sus valores predeterminados de un mes y barras
horarias. Eso es para lo que sirve la pregunta stated. Sin ella, la opción tendría que nombrar
alguna ventana, y lo habría hecho con seguridad.
Ábrelo en el playground
El enlace de abajo contiene un comando y las preguntas para la función que eligió: la elección entre las diez descripciones de funciones, y los cuatro argumentos de rolling_correlation. Edita el comando allí y los argumentos cambian con él.
COMMAND = "plot rolling correlation between nvda and spy for the past month"
picked = CALLS[COMMAND]
playground_link = make_playground_link(
    COMMAND,
    {ROUTE: assistant.questions[ROUTE]}
    | {q: v for q, v in assistant.questions.items() if q.startswith(f"{picked.name}.")},
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open the command and its questions in the TypeSafe playground]({playground_link})"
    )
)
Abre el comando y sus preguntas en el playground de TypeSafe →