 JevCode
Alignement d'entités de graphe de connaissances
Décide parmi 450 paires de candidats issues de deux catalogues de bières lesquelles décrivent le même produit. Une seule question TypeSafe Score porte à elle seule la décision, car ses trois niveaux correspondent aux trois actions possibles sur une paire : la fusionner, la laisser sans lien ou la soumettre à un conservateur. Il n'y a pas de seuil à ajuster, un
Traduit automatiquement depuis le en, non relu. À utiliser comme référence rapide uniquement.

Un problème clé dans les graphes de connaissances consiste à déterminer si une entité entrante duplique une entité existante, en particulier lorsque le langage naturel provenant de sources diverses est la seule information disponible. Étant donné des paires potentielles de doublons, un seul TypeSafe Score décide si chaque paire est un doublon ou si elle mérite un examen plus approfondi par un conservateur.
Supposons que deux sources de données décrivent des ensembles qui se chevauchent des mêmes choses, et que vous ayez besoin de savoir quelle entrée d’un côté correspond à quelle entrée de l’autre. Un graphe de connaissances appelle ces entrées entités, et conserve les faits enregistrés pour chacune. Une première passe déjà effectuée, bon marché mais approximative, a comparé les deux sources et sélectionné 450 paires dignes d’un examen plus approfondi. Ce qui reste à faire, c’est porter un jugement sur chaque paire.
Fusionner deux entités de manière inappropriée constitue l’erreur la plus coûteuse, car chaque fait concernant l’une ou l’autre entité décrit désormais celle qui a été fusionnée, et tout ce qui était lié à l’une ou l’autre suit également. Annuler cette opération ultérieurement implique de déterminer de quelle entenance provenait chaque fait. Ne pas repérer une correspondance laisse uniquement un doublon, le jugement doit donc prévoir une troisième option : des paires qui ne sont ni sûres à fusionner ni sûres à supprimer.
Le jugement est une question Score avec un niveau pour chacun des trois résultats :
- produit différent — laisser les deux entités non liées
- lié, mais possiblement différent — le soumettre à un conservateur pour décision
- même produit — les fusionner
Nous utilisons une question Score parce que nous souhaitons attacher une étiquette sémantique, à savoir les critères de score, directement à chaque résultat, y compris au résultat intermédiaire. Une question Noul pourrait accomplir cela indirectement par un seuillage sur sa sortie, tandis qu’une question Choice perdrait la relation ordonnée entre les trois résultats.
Ensuite, pour chaque champ de l’entité que nous souhaitons examiner, Noul questions sur la correspondance de ces champs peuvent être jointes à la même requête. Ces nouls fournissent des informations plus détaillées au conservateur, si le score ne se situe ni au niveau « même produit » ni au niveau « produit différent ».
Vous obtenez un route() qui prend une paire de candidats et renvoie l’un des trois
résultats, sans seuil que vous avez dû ajuster à vos propres données.
Direction du flux : LR
| Nœud | Description | Groupe |
|---|---|---|
CALL |
une demande, quatre questions | une demande, quatre questions |
S |
Score : comment les deux se rapportent-ils ? / · produit différent / · liés, mais possiblement pas identiques / · même produit | une demande, quatre questions |
N |
Nouls : un par champ comparé / · même nom ? / · même brasserie ? / · même style ? | une demande, quatre questions |
| De | Condition | À |
|---|---|---|
S |
— | N |
S |
— | R |
R |
différent | DROP |
R |
identique | M |
R |
lié | Q |
Installation
pip install matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/définissez ensuite TYPESAFE_API_KEY. Chaque appel est mis en cache dans json_cache.json, qui est fourni avec le
livre de recettes, de sorte que le re-rendu rejoue les chiffres publiés sans appeler l’API. Supprimez
ce fichier pour tout relancer en temps réel.
Les chiffres ci-dessous proviennent de jev-1.12 le 2026-08-11.
import json
import os
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Noul, Score, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
MAX_WORKERS = 6  # small pool; the public endpoint rate-limits above roughly eight

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Charger les paires candidates
Les paires proviennent d’un ensemble de référence publié, les données Beer de la collection Magellan :
deux catalogues de bières extraits de différents sites web, déjà réduits à 450 paires lors de
cette première passe approximative. Chaque entité comporte quatre champs : nom, brasserie, style et teneur
en alcool. Chaque paire contient également known_same_as, la réponse propre au benchmark.
Le texte est laissé tel qu’il a été publié, sans pré-traitement : les entités HTML qui n’ont jamais été reconverties en caractères, les apostrophes séparées en mots distincts, quelques caractères décodés incorrectement.
Une requête est envoyée par paire, donc ce que vous dépensez dépend du nombre de paires qui vous ont été confiées plutôt que de la taille de l’une ou l’autre source.
PAIRS = json.loads(Path("candidate_pairs.json").read_text(encoding="utf-8"))
BY_ID = {pair["id"]: pair for pair in PAIRS}

print(f"{len(PAIRS)} candidate pairs. The first one, as the model will see it:")
print(json.dumps({k: PAIRS[0][k] for k in ("entity_a", "entity_b")}, indent=2)[:420])
450 candidate pairs. The first one, as the model will see it:
{
"entity_a": {
"name": "C N Red Imperial Red Ale",
"brewery": "Redwood Lodge",
"style": "American Amber / Red Ale",
"abv": "8.10 %"
},
"entity_b": {
"name": "Kinetic Infrared Imperial Red Ale",
"brewery": "Kinetic Brewing Company",
"style": "American Strong Ale",
"abv": "9.30 %"
}
}Posez une question Score et trois questions Noul par paire de candidats
Les deux entités entrent dans un seul état, sous forme de entity_a et entity_b, de sorte que les questions portent sur la paire et non sur l’un ou l’autre côté pris individuellement. Les quatre voyagent dans une seule requête.
Les trois descriptions de niveau ci-dessous constituent la décision entière : chaque niveau correspond à un résultat. Il n’y a pas de constante de seuil quelque part dans ce fichier. Vous pouvez également rédiger ces descriptions avant d’avoir vu un seul score, ce qui n’est pas le cas d’un nombre que vous devez ajuster.
Le niveau intermédiaire est celui qui mérite d’être rédigé avec soin. Il couvre ici les variantes, les éditions spéciales et les noms qui pourraient raisonnablement désigner l’un ou l’autre produit, de sorte qu’ils soient remis à un conservateur plutôt que fusionnés ou supprimés.
OUTCOME nomme les trois issues. L’issue de fusion s’appelle assert sameAs car
sameAs est la méthode standard pour indiquer que deux entités sont une seule et même chose, et l’écriture
d’un seul est ce qui réalise concrètement la fusion.
Trois des quatre champs reçoivent une question Noul : nom, brasserie et style. La teneur en alcool
n’en reçoit aucune, car comparer deux nombres relève de l’arithmétique ; calculez-le dans le code si vous le souhaitez.
Pour utiliser ceci sur un autre type de données, vous réécrivez QUESTIONS et LEVELS. Le seul autre
code qui connaît la bière est constitué des deux fonctions qui affichent les résultats, lesquelles nomment les champs.
LEVELS = [
    "They describe two different products.",
    "They describe closely related products that may or may not be the same one: "
    "a variant, a special edition, or a name that could plausibly refer to either.",
    "They describe one and the same product.",
]
OUTCOME = {0: "leave unlinked", 1: "curator queue", 2: "assert sameAs"}

QUESTIONS = {
    "link_state": Score(
        instructions="How do the two entity descriptions relate as products?",
        criteria=LEVELS,
    ),
    "same_name": Noul(
        instructions="Do the two entities state the same beer name?",
    ),
    "same_brewery": Noul(
        instructions="Are the two entities from the same brewery?",
    ),
    "same_style": Noul(
        instructions="Do the two entities describe the same beer style?",
    ),
}


@json_cache
def score(pair_id: str) -> dict:
    """One request about one candidate pair -> the score plus the three noul answers."""
    pair = BY_ID[pair_id]
    response = client.system_one(
        state={"entity_a": pair["entity_a"], "entity_b": pair["entity_b"]},
        questions=QUESTIONS,
        model=TYPESAFE_MODEL,
    )
    link = response.answers["link_state"]
    return {
        "score": link.score,
        "probabilities": link.probabilities,
        "confidence": link.confidence,
        "properties": {
            k: response.answers[k].noul for k in QUESTIONS if k != "link_state"
        },
        # tokens and requests are the durable units; don't cache a derived cost
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


def route(score_value: float) -> str:
    """The whole decision rule: the nearest level names the outcome."""
    return OUTCOME[min(int(score_value + 0.5), len(LEVELS) - 1)]


def show(pair_id: str) -> None:
    pair, result = BY_ID[pair_id], score(pair_id)
    print(
        f"{pair_id}  score {result['score']:.2f}  confidence {result['confidence']:.2f}"
        f"  ->  {route(result['score'])}"
    )
    for side in ("entity_a", "entity_b"):
        e = pair[side]
        print(f"    {e['name'][:44]:<46}{e['brewery'][:30]:<32}{e['style'][:22]}")
    nouls = result["properties"]
    print(
        f"    name {nouls['same_name']:.2f}   brewery {nouls['same_brewery']:.2f}   "
        f"style {nouls['same_style']:.2f}"
    )
Quatre paires. c446 est un produit et c427 en est deux. Les deux autres se retrouvent au niveau intermédiaire pour des raisons différentes : c100 porte le même nom et provient de la même brasserie, mais les sources décrivent son style différemment, tandis que c428 associe une bière à sa variante aux fruits et aux houblons.
for pair_id in ("c446", "c427", "c100", "c428"):
    show(pair_id)
    print()
c446 score 1.94 confidence 0.92 -> assert sameAs
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company American Barleywine
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company Barley Wine
name 0.97 brewery 0.99 style 0.81
c427 score 0.03 confidence 0.95 -> leave unlinked
Frost Quake Bourbon Barrel Aged Barley Wine Wellington County Brewery American Barleywine
Lompoc Bourbon Barrel Aged Proletariat Red A Lompoc Brewing Amber Ale
name 0.02 brewery 0.09 style 0.08
c100 score 1.30 confidence 0.27 -> curator queue
Belle Gueule Rousse Brasseurs R.J. American Amber / Red A
Belle Gueule Rousse Brasseurs RJ Amber Lager/Vienna
name 0.95 brewery 0.94 style 0.35
c428 score 1.10 confidence 0.77 -> curator queue
Ambleside Amber Ale Bridge Brewing Company American Amber / Red A
Bridge Ambleside Amber Ale - Pomegranate & G Bridge Brewing Company Amber Ale
name 0.63 brewery 0.98 style 0.74Acheminez chaque paire candidate
# 450 candidate pairs, one request each; a small pool keeps a live run to a few minutes.
with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
    scored = list(pool.map(lambda pair: score(pair["id"]), PAIRS))

scores = [result["score"] for result in scored]
by_outcome: dict[str, list[str]] = {name: [] for name in OUTCOME.values()}
for pair, s in zip(PAIRS, scores):
    by_outcome[route(s)].append(pair["id"])

SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

BINS, TOP = 20, len(LEVELS) - 1
counts = [0] * BINS
for s in scores:
    counts[min(int(s / TOP * BINS), BINS - 1)] += 1
centers = [(i + 0.5) / BINS * TOP for i in range(BINS)]
queued = [c if route(x) == "curator queue" else 0 for c, x in zip(counts, centers)]
settled = [c if route(x) != "curator queue" else 0 for c, x in zip(counts, centers)]

fig, ax = plt.subplots(figsize=(7.2, 3.6), facecolor=SURFACE)
ax.set_facecolor(SURFACE)
for side in ("top", "right"):
    ax.spines[side].set_visible(False)
for side in ("left", "bottom"):
    ax.spines[side].set_color(AXIS)
ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
ax.set_axisbelow(True)
ax.grid(axis="y", color=GRID, linewidth=0.8)
ax.bar(
    centers, settled, width=TOP / BINS * 0.9, color=BLUE, label="settled automatically"
)
ax.bar(
    centers, queued, width=TOP / BINS * 0.9, color=ORANGE, label="sent to the curator"
)
for edge in (0.5, 1.5):
    ax.axvline(edge, color=INK2, linewidth=1, linestyle="--")
ax.set_xticks([0, 0.5, 1, 1.5, 2])
ax.set_xticklabels(["0\ndifferent", "0.5", "1\nrelated", "1.5", "2\nsame"])
ax.set_xlabel("score for the pair", color=INK2, fontsize=9)
ax.set_ylabel("candidate pairs", color=INK2, fontsize=9)
ax.set_title(
    f"{len(PAIRS)} candidate pairs, scored once each",
    loc="left",
    color=INK,
    fontsize=11,
)
ax.legend(frameon=False, labelcolor=INK2, fontsize=9)
display(fig)
plt.close(fig)

for name in ("assert sameAs", "curator queue", "leave unlinked"):
    n = len(by_outcome[name])
    print(f"{name:<16}{n:>5}  ({n / len(PAIRS):>5.1%})")
assert sameAs 40 ( 8.9%)
curator queue 50 (11.1%)
leave unlinked 360 (80.0%)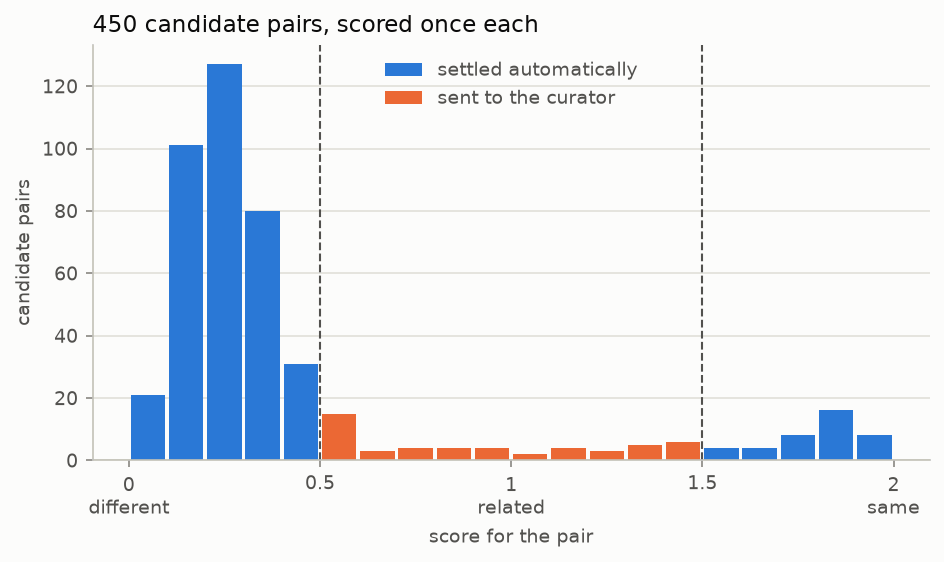
Les deux valeurs de score où route() change de réponse sont les points de coupure. La plupart des paires se stabilisent : 360 pour le score inférieur au point de coupure bas et 40 au-dessus du point de coupure haut, laissant 50 au curateur.
Sur cet ensemble, les scores ne se répartissent pas proprement sur les nombres entiers. La plupart se situent près de 0,25. Deux bières sans rien en commun peuvent malgré tout partager un nom de style, et les noms de leur brasserie peuvent se ressembler, de sorte que le modèle attribue une partie de sa probabilité au niveau intermédiaire plutôt que zéro. Ce qui détermine si une paire tombe d’un côté ou de l’autre d’un point de coupure. La proximité d’un niveau n’entre pas en ligne de compte.
Les deux points de coupure ne sont pas également encombrés. Neuf paires se situent à moins de 0.1 de celui du haut, à 1,5, qui est celui qui décide ce qui est fusionné dans le graphe. Quarante-sept se situent aussi près de celui du bas, à 0,5, qui décide seulement si un conservateur voit la paire. Aucun de ces deux nombres n’est un paramètre que vous ajustez. Les deux découlent de la manière dont vous avez formulé les niveaux, et la formulation du niveau intermédiaire est ce qui déplace les paires entre le conservateur et les paires restées non liées.
Ouvrez-le dans le terrain de jeu
Le lien du terrain de jeu ci-dessous ouvre c428, qui a obtenu un score de 1,10 et a été attribué au conservateur.
Il associe Ambleside Amber Ale à Bridge Ambleside Amber Ale - Pomegranate & Galena
Hops : même brasserie, même degré d’alcool. Les quatre questions l’accompagnent.
playground_link = make_playground_link(
    {"entity_a": BY_ID["c428"]["entity_a"], "entity_b": BY_ID["c428"]["entity_b"]},
    QUESTIONS,
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open this pair + questions in the TypeSafe playground]({playground_link})"
    )
)
Ouvrir cette paire + les questions dans le playground TypeSafe →