 JevCode
Cascade SDE
Utilise une cascade d'extraction de données structurées en deux étapes (mini → vérification → raisonnement) pour obtenir la majeure partie de la qualité d'un modèle de raisonnement volumineux à une fraction du coût.
Traduit automatiquement depuis le en, non relu. À utiliser comme référence rapide uniquement.

- Aperçu
- les grands modèles de raisonnement extraient bien les données structurées, mais ils sont lents et coûteux
- les petits modèles sont bon marché, mais font des erreurs
- une cascade permet d’obtenir la majeure partie de la qualité pour une fraction du coût
- les modèles que nous utilisons, ainsi que leurs tarifs ($ par 1M de tokens, entrée / sortie ; tarifs standards vérifiés le 15 septembre 2026) :
- palier 0 (mini) :
gpt-5.4-minià $0,75 / $4,50 - palier 1 (raisonnement) :
gpt-5.5à $5,00 / $30,00 (environ 7 fois le mini) - vérificateur : TypeSafe
jev-1.12à $0,042 / $0,00 (les tokens de sortie sont gratuits ; tarification Jev publiée) - Algorithme
- Extraire avec un modèle bon marché/petit.
- Vérifier avec les primitives TypeSafe : une question oui/non par champ (« question Noul »)
- (par ex. « cette valeur est-elle absente de la source ? », « a-t-elle été extraite d’un texte non lié ? »), chacune renvoyant P(quelque chose ne va pas).
- Escalader vers un modèle de raisonnement coûteux si un signal du vérificateur se déclenche ; sinon, conserver la réponse bon marché.
- Ce Cookbook
- parcourt un exemple réel de bout en bout, puis montre le compromis sur 100 prompts
- note : les deux paliers d’extraction utilisent le mode texte d’OpenAI
- nous n’utilisons pas les sorties structurées, les appels d’outils ou le mode json, car :
- une erreur de respect du schéma n’est pas l’erreur que nous attendons d’un LLM (il est facile de générer des données synthétiques pour cela)
- si un LLM échoue à respecter le schéma, il est presque toujours très confus, donc le décodage contraint ne résout pas le problème sous-jacent
- nous vous encourageons à les essayer tout de même !
Installation
- installer les dépendances (le client vérificateur TypeSafe est servi depuis l’index de paquets de TypeSafe) :
pip install openai datasets jsonschema ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/- puis définis
OPENAI_API_KEYetTYPESAFE_API_KEYdans ton environnement
import json
import os
from pathlib import Path

import jsonschema
from cooksafe import JsonCache, make_playground_link
from datasets import load_dataset
from IPython.display import Markdown, display
from openai import OpenAI
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

MINI = "gpt-5.4-mini"  # rung 0: cheap + fast
REASONING = "gpt-5.5"  # rung 1: strong, run with reasoning_effort="high"
TS_MODEL = "jev-1.12"  # the TypeSafe verifier model
FIRE_T = 0.7  # escalate if any per-field P(wrong) exceeds this; also the "<== FIRES" display marker

oai = OpenAI()

ts = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"], timeout=30.0)
Étape 1 : les données
Nous choisissons un jeu de données huggingface appelé scrapegraphai
SCRAPEGRAPHAI_REVISION = "4bb9fba1dff9181c5acdb60a5a26fea62fa54fe9"
row = load_dataset(
    "scrapegraphai/scrapegraphai-100k",
    revision=SCRAPEGRAPHAI_REVISION,
    split="train",
)[516]
schema = json.loads(row["schema"])
prompt = row["prompt"]
content = row["content"]

print(
    f"""
PROMPT
===========
{prompt}

SCHEMA
===========
{json.dumps(schema, indent=2)}

CONTENT
===========
{content}
""".strip()
)
PROMPT
===========
Find registration open date fall semester for New York University in New York, NY for the 2024-2025 school year.
SCHEMA
===========
{
"properties": {
"registration_open_date": {
"description": "The date that registration opens for the fall semester. MUST be in the format mm/dd/yyyy. For example, for a college in the 2024-2025 school year, it might be something like 09/05/2024. Return a blank string if you are unsure.",
"title": "Registration Open Date",
"type": "string"
},
"description": {
"description": "A brief description of the registration open date. For example, 'Registration opens for the fall semester'.",
"title": "Description",
"type": "string"
}
},
"required": [
"registration_open_date",
"description"
],
"title": "RegistrationOpen",
"type": "object"
}
CONTENT
===========
Skip to content Skip to current page navigation
[ ](https://www.nyu.edu/)
Search Site
[ ](https://www.nyu.edu/)
* [ Academics](https://www.nyu.edu/academics.html)
* [ Admissions](https://www.nyu.edu/admissions.html)
* [ Research](https://www.nyu.edu/research.html)
* [ University Life](https://www.nyu.edu/life.html)
* [ About](https://www.nyu.edu/about.html)
All NYU
# Mobile Navigation
[ ](https://www.nyu.edu/)
Search Site
* [Academics](https://www.nyu.edu/academics.html)
* [Admissions](https://www.nyu.edu/admissions.html)
* [Research](https://www.nyu.edu/research.html)
* [University Life](https://www.nyu.edu/life.html)
* [About](https://www.nyu.edu/about.html)
All NYU
Info for
* Back to main menu
* Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](http://home.nyu.edu/)
Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](https://home.nyu.edu/)
Search Site Search
# Events Calendar
Search Events
Apply Reset
* [About the Events Calendar ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar.html)
* [Events Calendar Tutorial ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar/tutorials.html)
* [Report issue or provide feedback ](https://nyu.service-now.com/sp?id=sc_cat_item&sys_id=7698dd2a98bcf4004c8c03063d84e274)
Search Filters Calendar
New York University
Equal Opportunity and Non-Discrimination at NYU - New York University is committed to maintaining an environment that encourages and fosters respect for individual values and appropriate conduct among all persons. In all University spaces--physical and digital--programming, activities, and events are carried out in accordance with applicable law as well as University policy, which includes but is not limited to its Non-Discrimination and Anti-Harassment Policy.
Unless otherwise noted, all content copyright New York University. All rights reserved.
* [Search](https://search.nyu.edu/)
* [Campus Map](https://www.nyu.edu/map.html)
* [Events](https://events.nyu.edu/)
* [Contact Us](https://www.nyu.edu/contact-us.html)
* [Give](https://www.nyu.edu/about/giving.html)
* [Copyright & Fair Use](https://www.nyu.edu/copyright-and-fair-use.html)
* [Privacy](https://www.nyu.edu/privacy.html)
* [Accessibility](https://www.nyu.edu/accessibility.html)
* [Feedback](https://www.nyu.edu/#feedback.html)
* [New York Campus](https://www.nyu.edu/)
* [Abu Dhabi Campus](https://nyuad.nyu.edu/)
* [Shanghai Campus](https://shanghai.nyu.edu/)
* [](https://facebook.com/)
* [](https://linkedin.com/)
* [](https://x.com/)
* [](https://instagram.com/)
* [](https://youtube.com/)- Cette ligne est une page du calendrier des événements de l’NYU (« Date du recensement automne 2024 ») :
- le schéma ne demande que deux champs :
registration_open_dateetdescription - le scrape du prompt n’a capturé que la navigation du calendrier et le texte standard : il n’y a pas de date d’inscription, ni de description
- notez que le champ
descriptiondu schéma fournit même une valeur d’exemple (« L’inscription ouvre pour le semestre d’automne ») dans sa propre description de champ - ainsi, un extracteur bien comporté devrait refuser d’inventer les champs que la page ne contient pas
- voyons si le petit modèle fait la bonne chose !
Étape 2 : extraire avec le mini-modèle (mode texte)
- note :
gpt-5.4-miniest très stochastique sur cette entrée – même àtemperature=0il invente undescriptiondifférent à chaque exécution. Pour un parcours reproductible, nous codons en dur la fabrication canonique unique que le reste de ce notebook explique (et que le vérificateur signale à P(erreur) > 0,8). Un pipeline réel se contenterait d’appeler directementextract(MINI, prompt, schema, content, temperature=0).
EXTRACT_SYSTEM = (
    "You extract structured data from documents. Return only values supported by the text. "
    "Follow any value format specified by the schema or its field descriptions."
)


# LLM and TypeSafe calls are cached to ``json_cache.json``, which ships with the cookbook, so
# re-rendering reproduces the published results with no API spend; delete the file to re-run live.
json_cache = JsonCache(Path("json_cache.json"))


@json_cache
def extract(
    model: str,
    prompt: str,
    schema: dict,
    content: str,
    *,
    reasoning_effort: str | None = None,
    temperature: float | None = None,
) -> dict:
    user = (
        f"{prompt}\n\nReturn ONLY a JSON object matching this JSON Schema:\n"
        f"{json.dumps(schema, indent=2)}\n\nDocument:\n{content}"
    )
    kwargs = {
        "model": model,
        "messages": [
            {"role": "system", "content": EXTRACT_SYSTEM},
            {"role": "user", "content": user},
        ],
    }
    if reasoning_effort:
        kwargs["reasoning_effort"] = reasoning_effort
    if temperature is not None:
        kwargs["temperature"] = temperature
    text = oai.chat.completions.create(**kwargs).choices[0].message.content
    # The prompt asks for ONLY a JSON object, so parse the reply as-is -- no regex fishing a
    # substring out of a malformed reply. If ``json.loads`` fails, treat it as an empty extraction
    # (the record-level analog of NaN): every field reads as absent, which the verifier flags and the
    # gate escalates -- the safe direction. Schema-following errors are rare here (see the overview).
    try:
        return json.loads(text)
    except (ValueError, json.JSONDecodeError):
        return {}


# Hard-coded canonical fabrication (see note above); a real pipeline would use extract(MINI, prompt, schema, content, temperature=0).
mini_record = {
    "registration_open_date": "",
    "description": "Registration opens for the fall semester",
}
print("mini extraction:\n", json.dumps(mini_record, indent=2))

# The record is a perfect fit for the JSON Schema -- and still wrong. Schema validation is necessary
# but not sufficient: it catches structural errors, never semantic ones. That gap is the whole point.
print("\nschema-valid:", jsonschema.Draft202012Validator(schema).is_valid(mini_record))
mini extraction:
{
"registration_open_date": "",
"description": "Registration opens for the fall semester"
}
schema-valid: True- L’enregistrement est valide selon le schéma (la ligne ci-dessus affiche
True), mais il est erroné : registration_open_datereste vide, ce qui correspond à la page : celle-ci indique qu’il n’y a pas de date- mais
descriptionest inventé : la page ne décrit jamais de date d’enregistrement, donc mini en fabrique une plausible. Il peut copier l’exemple propre au schéma, « L’inscription s’ouvre pour le semestre d’automne », ou raconter « …n’a pas été trouvé dans le document » - une vérification par JSON-Schema ne peut pas détecter cela. Un modèle peu coûteux produit des fabrications confiantes de ce type, satisfaisant le schéma, et il revient à un vérificateur sémantique de les repérer
Étape 3 : vérifier avec TypeSafe
- le vérificateur est TypeSafe ; pour chaque champ, nous construisons une
Noulquestion : - un oui/non étroit, formulé de telle sorte que
true= quelque chose ne va pas (escalade) - TypeSafe renvoie une
noulcalibrée =P(true)par question, en un seul appel system_one - l’ensemble des questions :
- une tête
__overall__::judgeholistique (« ce enregistrement doit-il être escaladé ? »). Nous la calculons et l’affichons pour opposer un jugement global du record aux têtes par champ, mais la porte à l’étape 4 ne l’utilise pas – l’escalade est pilotée par la batterie par champ. - une batterie par champ
- les champs non vides reçoivent l’ensemble complet des têtes
- les champs vides (null / “” / []) reçoivent uniquement la tête
absence_wrong - (le pipeline complet possède également une tête
spuriouspour les conteneurs entiers et undifficultyscore global ; non affichés ici, pour limiter cet exposé aux deux têtes de filtrage) - La Méthode TypeSafe : Décomposition
- Remarquez comment tout est décomposé programmatiquement, c’est la façon TypeSafe.
- La décomposition maximise l’intelligence de chaque prompt, et rend l’algorithme réglable et interprétable.
-
# metric -> (question, NoulCriteria)
MAIN_QUESTIONS = {
    "name_desc_mismatch": (
        "Does the `extracted_field` fail to match the field at `path` or the `description` in the "
        "`field_spec`? If the `description` is empty, judge against the `path` alone.",
        NoulCriteria(
            true="the `extracted_field` does not match the field name or its `description`",
            false="the `extracted_field` matches the field name and `description`",
        ),
    ),
    "type_mismatch": (
        "Does the `extracted_field` violate the `type` declared in the `field_spec`?",
        NoulCriteria(
            true="the `extracted_field` violates the declared `type`",
            false="the `extracted_field` conforms to the declared `type`",
        ),
    ),
    "unreasonable": (
        "Is the `extracted_field` one that a reasonable person would not have extracted for this "
        "`field_spec`?",
        NoulCriteria(
            true="a reasonable person would not have extracted this value",
            false="the extraction is reasonable",
        ),
    ),
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    "off_target": (
        "Does the source text fail to genuinely report the thing the `field_spec` describes, so the "
        "value was pulled from incidental text?",
        NoulCriteria(
            true="the source does not genuinely provide this field -- the value was pulled "
            "from incidental text",
            false="the source genuinely reports this field",
        ),
    ),
    "incomplete": (
        "Does the `extracted_field` fail to capture a value the source supports (note whether the "
        "`field_spec` is `required`)?",
        NoulCriteria(
            true="the field is wrongly empty, null, or missing a value the source supports",
            false="the field captures the value the source supports",
        ),
    ),
    "format_violation": (
        "Does the `extracted_field` violate the format or constraints implied by the `description`, "
        "the schema `type`, and the extraction instructions (e.g. date format, units, enum membership)?",
        NoulCriteria(
            true="the `extracted_field` violates the implied format or constraints",
            false="the `extracted_field` satisfies the format and constraints",
        ),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text contain the "
    "information the `field_spec` describes, making the empty result wrong?"
)
ABSENCE_CRITERIA = NoulCriteria(
    true="a value was wrongly omitted", false="returning nothing is correct"
)

# The pipeline also asks one holistic, whole-record head: "should this be escalated?"
OVERALL_JUDGE = (
    "Is this extracted record an incorrect extraction -- some value unsupported by the source or "
    "not conforming to the schema, required information missing or wrong, or some field hallucinated -- "
    "so it should be escalated to a smarter model?"
)
OVERALL_JUDGE_CRITERIA = NoulCriteria(
    true="the record is an incorrect extraction",
    false="the record is a correct extraction",
)


def is_empty(v) -> bool:
    return v is None or (isinstance(v, (str, list, dict)) and len(v) == 0)


def field_spec(name: str) -> dict:
    """Minimal spec pulled from the schema (unwrapping anyOf/null for optional fields)."""
    p = schema["properties"][name]
    branches = p.get("anyOf") or []
    typ = p.get("type") or next(
        (b["type"] for b in branches if b.get("type") != "null"), "unknown"
    )
    return {
        "path": name,
        "type": typ,
        "description": p.get("description", ""),
        "required": name in schema.get("required", []),
    }


def build_questions(record: dict) -> dict[str, Noul]:
    """The verify question set: one holistic ``__overall__::judge`` head plus a per-field battery,
    keyed ``field::metric`` (mirrors build_verify_prompts)."""
    questions: dict[str, Noul] = {
        "__overall__::judge": Noul(
            instructions=OVERALL_JUDGE, criteria=OVERALL_JUDGE_CRITERIA
        ),
    }
    for name, value in record.items():
        spec = field_spec(name)
        if is_empty(value):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": ABSENCE_QUESTION,
                },
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            if metric == "type_mismatch" and spec["type"] == "unknown":
                continue
            questions[f"{name}::{metric}"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": question,
                },
                criteria=criteria,
            )
    return questions


@json_cache
def verify(record: dict) -> dict[str, float | str]:
    """Run the whole Noul battery over a record in one TypeSafe call; return ``{field::metric: P(true)}``."""
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": "Extract the structured record from this document",
        "source_text": row["content"],
        "schema": schema,
        "extraction": record,
    }
    questions = build_questions(record)
    answers = ts.system_one(state=state, questions=questions, model=TS_MODEL).answers
    return {qid: ans.noul for qid, ans in answers.items()} | {
        "playground_link": make_playground_link(state, questions)
    }
Exécuter la batterie complète sur l’extraction mini
checks = verify(mini_record)
playground_link = checks.pop("playground_link")
display(
    Markdown(
        f"🔗 [Open this verification in the TypeSafe playground]({playground_link})"
    )
)

print(f"{'qid':<40}{'P(wrong)':>9}")
print("-" * 50)
for fld, p in sorted(checks.items(), key=lambda c: -c[-1]):
    flag = "  <== FIRES" if p > FIRE_T else ""
    print(f"{fld:<40}{p:>9.2f}{flag}")
qid P(wrong)
--------------------------------------------------
description::hallucinated 0.95 <== FIRES
description::off_target 0.85 <== FIRES
description::unreasonable 0.58
__overall__::judge 0.56
description::incomplete 0.16
registration_open_date::absence_wrong 0.14
description::format_violation 0.10
description::name_desc_mismatch 0.08
description::type_mismatch 0.02Ouvrir cette vérification dans le playground TypeSafe →
- TypeSafe concentre le signal sur les champs qui sont réellement incorrects.
- Nos résultats sont calibrés : élevés pour les champs incorrects, faibles pour les champs corrects, moyens pour les champs qui semblent erronés sans être clairement faux
- C’est ce qu’un vérificateur typesafe vous apporte par rapport à un juge brut qui demande « est-ce que l’ensemble est bon ? »
Étape 4 : le seuil d’escalade
- maintenant, nous activons le
any_flag: escalader si n’importe quel indicateur de champ dépasseFIRE_T(0,7, défini ci-dessus et partagé avec le marqueur<== FIRESà l’étape 3) - il s’agit d’une barrière de type
max(escalader si n’importe quel champ se déclenche), et non d’une moyenne, donc un seul indicateur rouge fiable suffit au lieu d’être dilué dans le silence
# any_flag is a per-field gate: the holistic __overall__ head is shown above but not part of it
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > FIRE_T
}
escalate = bool(fired)

print(
    f"any_flag gate (threshold {FIRE_T}): {'ESCALATE' if escalate else 'ACCEPT cheap result'}"
)
for qid, p in sorted(fired.items(), key=lambda c: -c[1]):
    print(f"  fired: {qid}  (P={p:.2f})")
any_flag gate (threshold 0.7): ESCALATE
fired: description::hallucinated (P=0.95)
fired: description::off_target (P=0.85)Étape 5 : escalader vers le modèle de raisonnement
Puisqu’un signal a été déclenché, nous payons pour le modèle puissant (gpt-5.5, reasoning_effort="high")
final_record = (
    extract(REASONING, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)

print("mini      :", json.dumps(mini_record))
print("reasoning :", json.dumps(final_record))
print("\nfield-level diff (mini -> final):")
for name in mini_record:
    if mini_record[name] != final_record.get(name):
        print(f"  {name}: {mini_record[name]!r}  ->  {final_record.get(name)!r}")
mini : {"registration_open_date": "", "description": "Registration opens for the fall semester"}
reasoning : {"description": "", "registration_open_date": ""}
field-level diff (mini -> final):
description: 'Registration opens for the fall semester' -> ''- L’amélioration
- Le modèle de raisonnement supprime la fabrication
description, renvoyant"" - Il a reconnu que la page ne décrit jamais de date d’inscription, et a refusé d’en inventer une
- La cascade a transformé une fabrication confiante, conforme au schéma, en un champ vide honnête
- Et elle n’a dépensé des dollars du modèle de raisonnement que pour cet élément unique parce que le vérificateur lui en a fait la demande
Étape 6 : à quoi cela ressemble sur 100 invites
- Ce sont des résultats internes TypeSafe, produits avec la méthode générale ci-dessus :
- la même boucle
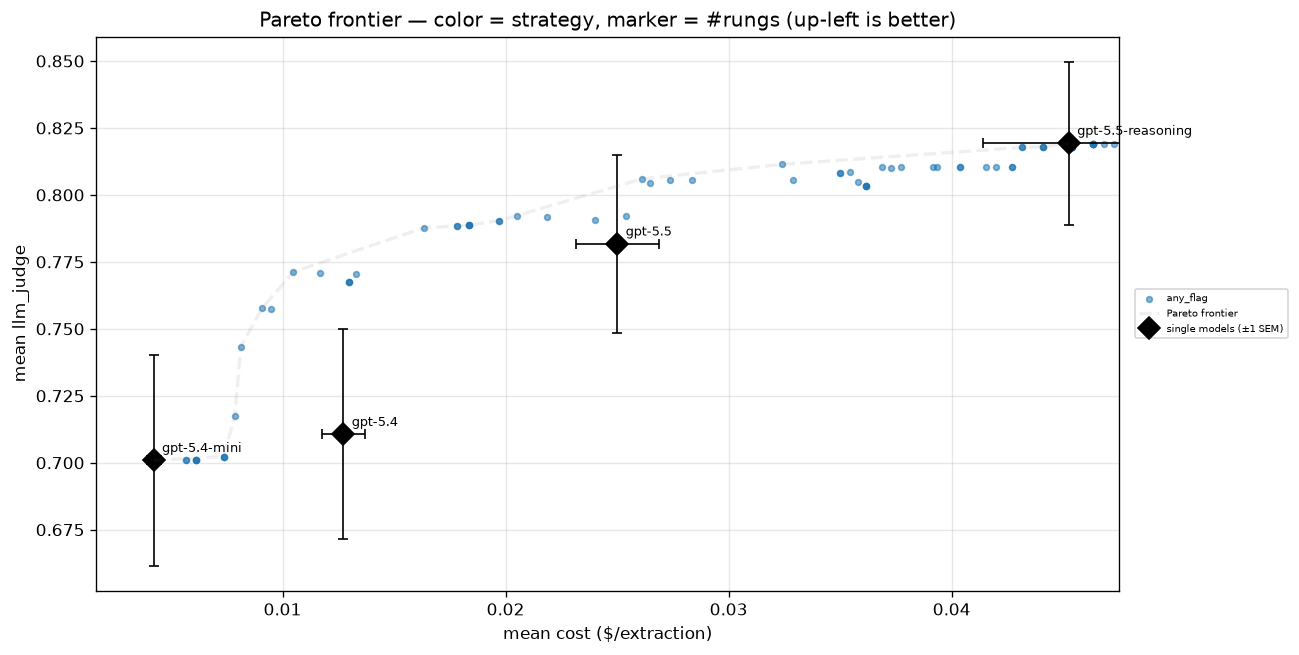
extract → verify → escalate,gpt-5.4-mini → gpt-5.5-reasoning,any_flagsur les têtes par champ, exécutée sur 100 prompts scrapegraphai - l’extraction à faible coût de chaque élément est évaluée par TypeSafe ; le seuil de la porte (« cut ») est balayé de 0 à 1, et chaque configuration résultante est tracée dans l’espace (coût, qualité)
- le graphique est une capture historique ; ses coûts n’ont pas été recalculés au taux Jev actuel indiqué ci-dessus
- comment le lire :
- losanges noirs = les quatre modèles exécutés individuellement (le coût augmente avec la capacité ; le
plus puissant,
gpt-5.5-reasoning, se trouve en haut à droite avec ≈0,81 de qualité pour ≈$0,10/extraction) - points bleus = la cascade à de nombreux seuils de filtrage ; la ligne pointillée représente la frontière de Pareto
- la frontière de la cascade se situe en haut et à gauche de chaque modèle : ajuster le filtre vous procure l’essentiel de la qualité du modèle principal à une fraction de son coût
- l’étape peu coûteuse traite les éléments faciles pour presque rien, et seuls les éléments signalés paient pour le modèle de raisonnement
Annexe A : ce qui fait un bon signal de vérification
- la cascade n’est bonne que si son vérificateur l’est aussi ; ce qui distingue un signal utile d’un signal inutile :
- Étroit et ancré.
- une seule question vérifiable oui/non sur un champ par rapport à la source (ex. « cette valeur est-elle absente de la source ? »), et non une vague « cette extraction est-elle bonne ? »
- des questions vagues donnent des scores flous et non calibrés
- Mauvais = VRAI, avec des critères explicites.
- formulez chaque question de sorte que le cas de montée en grade soit le cas
true, et précisez ce quetrue/falsesignifient - Par champ, puis agrégation avec
max. - un indicateur par champ localise l’erreur et reste clair et fort
max(« un indicateur se déclenche ») garantit qu’un seul signal d’alerte fiable monte en grade, au lieu d’être noyé dans le silence par la moyenne- Indépendants et peu coûteux.
- un vérificateur dédié (ici, TypeSafe) évaluant la sortie capture les angles morts propres à l’extracteur
- il doit être peu coûteux, sinon il ne reste plus d’économies à capturer
- Séparés / calibrés.
- un bon signal est élevé sur les erreurs réelles et faible sur les cas corrects, de sorte qu’un seuil unique sépare clairement l’acceptation de la montée en grade
- cette séparation est ce qui fait monter la courbe de Pareto vers le haut et la gauche