 JevCode
Sugestão de habilidade
Seleciona no máximo uma habilidade para uma rodada do agente entre as 182 do catálogo Hermes da Nous Research: uma solicitação TypeSafe classifica todas as habilidades e pergunta se a rodada precisa de alguma, uma segunda lê as três principais corretamente e pode rejeitar todas elas. O nome do vencedor vai para uma única linha do sy do agente
Traduzido automaticamente do en, sem revisão. Apenas como referência rápida.

Agentes escolhem habilidades truncando-as e carregando-as todas na mensagem do sistema, o que aumenta os custos, degrada o desempenho da seleção de habilidades e induz deterioração do contexto para o restante da sessão. Abordamos isso usando duas solicitações TypeSafe por turno, uma para classificar as habilidades e outra para verificar a escolha, reduzindo as cargas incorretas de habilidades em mais da metade.
Um agente com um grande portfólio de habilidades faz sua escolha com quase nenhuma informação. O portfólio chega a ele como um índice: uma linha por habilidade, com a descrição truncada para que o texto completo não atrapalhe a conversa. Hermes, o harness de agente usado aqui, corta para 60 caracteres por padrão. Por exemplo, nessa largura, a habilidade que edita .pptx arquivos lê-se quase da mesma forma que a que autoras eles. Peça uma apresentação comercial e o agente pode carregar a errada. Em uma rodada em que nenhuma habilidade se encaixe de todo, ele ainda pode carregar uma de qualquer maneira, porque uma lista de nomes convida a um palpite.
Este livro de receitas deixa as descrições inalteradas e usa revelação progressiva, lendo todas as 182 habilidades de forma econômica e depois lendo três delas em detalhe. Duas solicitações TypeSafe são feitas antes da decisão sobre qual habilidade carregar, se houver alguma. A primeira classifica cada habilidade no elenco em relação à vez do usuário e responde se a vez precisa de uma habilidade em absoluto. A segunda relê apenas as três primeiras, agora com a descrição completa de cada habilidade e o início de suas instruções, e é livre para rejeitar todas elas.
O nome do vencedor vai para uma linha extra do prompt do sistema do agente para essa rodada:
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user
actually asked for.
</skill_relevance>
O agente mantém seu índice completo e seu próprio julgamento, e essa única linha apenas indica qual
entrada ele deve examinar primeiro. A lista em si nunca muda, portanto qualquer cache de prefixo sobre ela
ainda se mantém. Em 488 solicitações contra claude-haiku-4-5-20251001, usando habilidades da
lista Hermes:
| carrega a habilidade errada | carrega uma quando nada se encaixa | |
|---|---|---|
| agent alone, with just its roster | 16,8% | 9,8% |
| agent with a TypeSafe suggestion | 7,3% | 4,0% |
| agent handed the right answer | 2,5% | 1,2% |
A terceira linha mostra que o piso para cometer erros não é zero, porque um agente que recebe a habilidade correta ainda não a carrega sempre, e nenhum método de seleção, por melhor que seja, supera isso.
Você acaba com uma função suggest() que retorna no máximo um nome de habilidade, um suggestion_block() que a envolve para o prompt do sistema, e o harness que produziu a tabela acima, pronto para apontar para seu próprio elenco.
Direção do fluxo: LR
| Nó | Descrição | Grupo |
|---|---|---|
C1 |
Chamada 1 - folhear todas as 182 habilidades | Chamada 1 - folhear todas as 182 habilidades |
Q1 |
Escolha: qual habilidade se encaixa? / todas as 182, uma linha cada | Chamada 1 - folhear todas as 182 habilidades |
N1 |
Nouls: precisa de uma habilidade? / · agir sobre o que eles fazem? / · seguir passos escritos? / · ou apenas conversar? | Chamada 1 - folhear todas as 182 habilidades |
C2 |
Chamada 2 - ler essas 3 corretamente | Chamada 2 - ler essas 3 corretamente |
Q2 |
Escolha: qual das 3? / com detalhes reais agora | Chamada 2 - ler essas 3 corretamente |
N2 |
Nouls: cada uma / realmente faz isso? | Chamada 2 - ler essas 3 corretamente |
| De | Condição | Para |
|---|---|---|
Q1 |
— | N1 |
Q2 |
— | N2 |
C1 |
top 3 | C2 |
C1 |
nada / aplica-se | STOP |
C2 |
nenhum se encaixa | STOP |
C2 |
um vencedor | OUT |
Configuração
- Instale o cliente TypeSafe, o cliente Anthropic e os auxiliares compartilhados do cookbook.
- Defina uma chave da API TypeSafe e uma chave Anthropic para o agente que está sendo medido.
pip install anthropic matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/
export TYPESAFE_API_KEY=your-key-here
export ANTHROPIC_API_KEY=your-key-here
Nota: os blocos de código abaixo formam um único script, em ordem. Para acompanhar, coloque-os em um único arquivo na ordem apresentada.
Resultados em cache
JsonCache salva o resultado de cada chamada, indexado pelos seus inputs, de modo que reexecutar replaya os
números abaixo em vez de chamar qualquer API. Apague json_cache.json para executar ao vivo. A
versão publicada usou jev-1.12 e claude-haiku-4-5-20251001, renderizada em 2026-07-31.
import json
import os
from collections import defaultdict
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
from time import perf_counter

import anthropic
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.ticker import PercentFormatter
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, Noul, TypeSafeClient

matplotlib.use("Agg")  # headless render

TYPESAFE_MODEL = "jev-1.12"
AGENT_MODEL = (
    "claude-haiku-4-5-20251001"  # the agent under test, pinned so scores are stable
)

SHORTLIST = 3  # candidates carried from the first request into the second
EXCERPT_CHARS = (
    700  # SKILL.md characters each candidate brings; the roster file stores 1600
)
GATE_THRESHOLD = (
    0.30  # mean of the three request nouls, below which nothing is suggested
)
FITS_THRESHOLD = (
    0.30  # a shortlist whose best "does this fit" noul is under this is dropped
)
WORKERS = 8  # small pool: enough to keep a live run to minutes, gentle on rate limits

assert EXCERPT_CHARS <= 1600, (
    "the shipped roster file stores 1600 body characters per skill"
)

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
agent = anthropic.Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY", "cache-only"))
json_cache = JsonCache(Path("json_cache.json"))
Passo 1: carregar a lista
hermes_roster.json contém as 182 habilidades do
NousResearch/hermes-agent (MIT) em um
commit fixado. Cada registro contém o nome e a categoria de uma habilidade, a descrição conforme o índice
a mostra, a descrição completa e o início do seu SKILL.md.
O índice abaixo, e as instruções acima dele no prompt, foram copiados de Hermes.
ROSTER = json.loads(Path("hermes_roster.json").read_text(encoding="utf-8"))
BY_NAME = {skill["name"]: skill for skill in ROSTER}

# Verbatim from hermes-agent agent/prompt_builder.py:build_skills_system_prompt.
PREAMBLE = (
    "## Skills (mandatory)\n"
    "Before replying, scan the skills below. If a skill matches or is even partially relevant "
    "to your task, you MUST load it with skill_view(name) and follow its instructions. "
    "Err on the side of loading — it is always better to have context you don't need "
    "than to miss critical steps, pitfalls, or established workflows. "
    "Skills contain specialized knowledge — API endpoints, tool-specific commands, "
    "and proven workflows that outperform general-purpose approaches. Load the skill "
    "even if you think you could handle the task with basic tools like web_search or terminal. "
    "Skills also encode the user's preferred approach, conventions, and quality standards "
    "for tasks like code review, planning, and testing — load them even for tasks you "
    "already know how to do, because the skill defines how it should be done here.\n"
    "Whenever the user asks you to configure, set up, install, enable, disable, modify, "
    "or troubleshoot Hermes Agent itself — its CLI, config, models, providers, tools, "
    "skills, voice, gateway, plugins, or any feature — load the `hermes-agent` skill "
    "first. It has the actual commands (e.g. `hermes config set …`, `hermes tools`, "
    "`hermes setup`) so you don't have to guess or invent workarounds.\n"
    "If a skill has issues, fix it with skill_manage(action='patch').\n"
    "After difficult/iterative tasks, offer to save as a skill. "
    "If a skill you loaded was missing steps, had wrong commands, or needed "
    "pitfalls you discovered, update it before finishing.\n"
    "\n"
)
FOOTER = "\n\nOnly proceed without loading a skill if genuinely none are relevant to the task."
IDENTITY = (
    "You are Hermes, a capable AI assistant with access to tools and a library "
    "of skills. You help the user with coding, research, and everyday tasks.\n\n"
)


def render_index() -> str:
    """The body of <available_skills>: skills grouped by category, both sorted by name."""
    by_category = defaultdict(list)
    for skill in ROSTER:
        by_category[skill["category"]].append(skill)
    lines = []
    for category in sorted(by_category):
        lines.append(f"  {category}:")
        for skill in sorted(by_category[category], key=lambda s: s["name"]):
            lines.append(f"    - {skill['name']}: {skill['description']}")
    return "\n".join(lines)


CATALOG_PROMPT = (
    IDENTITY
    + PREAMBLE
    + "<available_skills>\n"
    + render_index()
    + "\n</available_skills>"
    + FOOTER
)

widths = [len(skill["description"]) for skill in ROSTER]
print(f"{len(ROSTER)} skills in {len({s['category'] for s in ROSTER})} categories")
print(f"roster prompt: {len(CATALOG_PROMPT):,} characters")
print(
    f"index description: {sum(widths) / len(widths):.0f} characters on average, "
    f"{max(widths)} at most"
)
print("\none category, as the agent reads it:")
index_lines = render_index().splitlines()
start = index_lines.index("  apple:")
end = next(
    i
    for i in range(start + 1, len(index_lines))
    if not index_lines[i].startswith("    ")
)
print("\n".join(index_lines[start:end]))
182 skills in 33 categories
roster prompt: 16,089 characters
index description: 54 characters on average, 60 at most
one category, as the agent reads it:
apple:
- apple-notes: Manage Apple Notes via memo CLI: create, search, edit.
- apple-reminders: Apple Reminders via remindctl: add, list, complete.
- findmy: Track Apple devices/AirTags via FindMy.app on macOS.
- imessage: Send and receive iMessages/SMS via the imsg CLI on macOS.Passo 2: avalie o agente com base em seus próprios
requests.json contém 488 solicitações de turno único, das quais 315 são cobertas por exatamente uma habilidade e as outras 173 não são cobertas por nenhuma.
Os pedidos cobertos foram escritos pelo Claude Sonnet 5 a partir do próprio SKILL.md de cada habilidade, portanto, os rótulos são confiáveis e os pedidos são mais fáceis do que aqueles enviados pelos usuários.
Os 173 descobertos foram todos escritos para punir adivinhações: 85 solicitações cotidianas, 42 perguntas técnicas que nenhuma habilidade atende (explicar o que é um monad), e 46 que pedem algo específico para o qual o elenco não tem habilidade, como postar isso no Mastodon em um elenco que cobre X e nada mais.
A pontuação lê apenas a primeira resposta do agente. Ambos os números são taxas de erro, então quanto menor, melhor em cada um:
- carga incorreta: dos pedidos cobertos, a proporção em que a primeira chamada
skill_viewnão foi a habilidade de cobertura. Uma rodada que não carregou nada conta como erro. - carga desnecessária: dos pedidos não cobertos, a proporção em que o agente chamou
skill_viewde qualquer forma.
REQUESTS = json.loads(Path("requests.json").read_text(encoding="utf-8"))
POSITIVES = [p for p in REQUESTS if p["gold"]]
NEGATIVES = [p for p in REQUESTS if not p["gold"]]

print(
    f"{len(REQUESTS)} requests: {len(POSITIVES)} covered by a skill "
    f"({len({p['gold'] for p in POSITIVES})} distinct skills), {len(NEGATIVES)} covered by none"
)
print(f"\ncovered   [{POSITIVES[0]['gold']}]  {POSITIVES[0]['text']}")
print(f"uncovered  {NEGATIVES[0]['text']}")
488 requests: 315 covered by a skill (171 distinct skills), 173 covered by none
covered [1password] I've got a config.yaml with `{{ op://app-prod/db/password }}` placeholders in it — can you set up my project to pull the real values in at runtime instead of hardcoding them?
uncovered Add these three cards to our Trello backlog.A sugestão fica em seu próprio bloco do prompt do sistema, após a lista de participantes, e não dentro dela, para que o texto da lista seja idêntico em todos os turnos e mantenha o cache de prefixo.
O agente possui um conjunto mínimo de ferramentas, incluindo skill_view para carregar uma habilidade usando um nome em texto livre. O nome deve corresponder exatamente à habilidade para um carregamento correto.
# Verbatim from hermes-agent tools/skills_tool.py:SKILL_VIEW_SCHEMA.
SKILL_VIEW_DESCRIPTION = (
    "Skills allow for loading information about specific tasks and workflows, as "
    "well as scripts and templates. Load a skill's full content or access its "
    "linked files (references, templates, scripts). First call returns SKILL.md "
    "content plus a 'linked_files' dict showing available references/templates/"
    "scripts. To access those, call again with file_path parameter."
)
TOOLS = [
    {
        "name": "skill_view",
        "description": SKILL_VIEW_DESCRIPTION,
        "input_schema": {
            "type": "object",
            "properties": {
                "name": {"type": "string", "description": "The skill name."}
            },
            "required": ["name"],
        },
    },
    {
        "name": "terminal",
        "description": "Run a shell command on the user's machine and return its output.",
        "input_schema": {
            "type": "object",
            "properties": {"command": {"type": "string"}},
            "required": ["command"],
        },
    },
    {
        "name": "read_file",
        "description": "Read a file from the user's filesystem.",
        "input_schema": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
    {
        "name": "web_search",
        "description": "Search the web and return result snippets.",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    },
]


@json_cache
def run_turn(model: str, arm: str, request: str, suggestion: str) -> dict:
    """One measured turn. ``arm`` is in the key so each arm samples independently."""
    system = [
        {"type": "text", "text": CATALOG_PROMPT, "cache_control": {"type": "ephemeral"}}
    ]
    if suggestion:
        system.append({"type": "text", "text": suggestion})  # after the breakpoint
    response = agent.messages.create(
        model=model,
        max_tokens=1024,
        system=system,
        tools=TOOLS,
        messages=[{"role": "user", "content": request}],
    )
    usage = response.usage
    return {
        "loaded": [
            str(block.input.get("name", ""))
            for block in response.content
            if block.type == "tool_use" and block.name == "skill_view"
        ],
        "input_tokens": usage.input_tokens or 0,
        "output_tokens": usage.output_tokens or 0,
    }


def summarise(turns: dict[str, dict]) -> dict[str, float]:
    """Two failure rates: wrong loads on covered requests, needless ones on uncovered."""
    hits = [turns[p["text"]]["loaded"][:1] == [p["gold"]] for p in POSITIVES]
    over = [bool(turns[p["text"]]["loaded"]) for p in NEGATIVES]
    return {
        # both metrics are errors, so the two columns read the same direction
        "wrong_load": 1 - sum(hits) / len(hits),
        "needless_load": sum(over) / len(over),
    }


def run_arm(arm: str, suggestions: dict[str, str]) -> dict[str, dict]:
    """One measured turn per request, in a small pool. 488 calls."""
    texts = [request["text"] for request in REQUESTS]
    with ThreadPoolExecutor(max_workers=WORKERS) as pool:
        turns = pool.map(
            lambda t: run_turn(AGENT_MODEL, arm, t, suggestions.get(t, "")), texts
        )
        return dict(zip(texts, turns))
O agente é executado primeiro com apenas sua lista, da forma como funciona hoje. Suas duas taxas de erro são a linha de base contra a qual o restante do livro de receitas mede.
baseline = run_arm("baseline", {})
base_scores = summarise(baseline)
print(
    f"wrong loads    {base_scores['wrong_load']:.1%}   ({len(POSITIVES)} covered requests)"
)
print(
    f"needless loads {base_scores['needless_load']:.1%}   ({len(NEGATIVES)} uncovered requests)"
)

# where the wrong loads land: a neighbour of the right skill, or somewhere unrelated?
misses = [
    (p["gold"], baseline[p["text"]]["loaded"][0])
    for p in POSITIVES
    if baseline[p["text"]]["loaded"] and baseline[p["text"]]["loaded"][0] != p["gold"]
]
same_category = sum(
    1
    for gold, got in misses
    if got in BY_NAME and BY_NAME[got]["category"] == BY_NAME[gold]["category"]
)
print(
    f"\nof {len(misses)} wrong first picks, {same_category} came from the right skill's own "
    f"category"
)
wrong loads 16.8% (315 covered requests)
needless loads 9.8% (173 uncovered requests)
of 36 wrong first picks, 10 came from the right skill's own categoryCargas erradas caem na própria categoria da habilidade correta muito mais frequentemente do que o acaso colocaria nela, então a parte difícil é distinguir alguns parecidos. O agente já está procurando no lugar aproximadamente correto.
Passo 3: classifique o elenco inteiro
Um pedido carrega dois tipos de pergunta:
whiché uma perguntaChoicesobre todos os 182 nomes de habilidades, com a descrição do índice como critério de cada opção (o mesmo texto que o próprio agente recebe). Suas probabilidades são a classificação.- três perguntas
Noulsobre a solicitação, impressas abaixo, cada uma perguntando de maneira diferente se deseja que uma ação seja tomada em vez de uma explicação fornecida.prose_sufficesconta da maneira inversa. Sua média decide se algo deve ser sugerido ou não, e abaixo de 0,30 nada é sugerido.
Ambos são enviados em uma única solicitação, portanto, a classificação e a verificação custam uma ida e volta.
Escreva estes três para perguntar se uma ação é desejada. Uma pergunta sobre o assunto não separará explain what a monad is de uma solicitação que precisa de uma habilidade, já que ambos são software.
Uma Choice questão mantém um elenco desse tamanho confortavelmente. Um pouco maior e você
dividiria
em pedaços e classificaria cada um, então executaria esta mesma etapa de lista curta sobre os vencedores.
CHOICE_INSTRUCTIONS = (
    "Which of these skills, if any, is the right one to load to help with the "
    "user's latest request?"
)
GATE_QUESTIONS = {
    "acts_on_user_system": (
        "Is the assistant being asked to act on the user's files, accounts, devices, "
        "or online services, rather than only to explain or advise?"
    ),
    "would_follow_documented_procedure": (
        "Would a careful expert answering this consult a specific documented procedure "
        "or set of commands, rather than answering from general understanding?"
    ),
    "prose_suffices": (
        "Could a knowledgeable generalist fully satisfy this request in prose, with "
        "no tools, no documentation, and no access to the user's files or accounts?"
    ),
}
INVERTED = {"prose_suffices"}  # a yes here points away from needing a skill


def build_state(request: str) -> dict:
    return {"request": request, "recent_context": ""}


@json_cache
def rank_wide(request: str) -> dict:
    """Request 1: rank all 182 skills, and score the request for whether a skill applies."""
    questions = {
        "which": Choice(
            instructions=CHOICE_INSTRUCTIONS,
            criteria={skill["name"]: skill["description"] for skill in ROSTER},
        )
    }
    for key, text in GATE_QUESTIONS.items():
        questions[f"gate::{key}"] = Noul(instructions=text)
    started = perf_counter()
    response = client.system_one(
        state=build_state(request), questions=questions, model=TYPESAFE_MODEL
    )
    ranked = sorted(
        response.answers["which"].probabilities.items(), key=lambda kv: -kv[1]
    )
    values = {
        key.removeprefix("gate::"): answer.noul
        for key, answer in response.answers.items()
        if key.startswith("gate::")
    }
    oriented = [(1.0 - v) if k in INVERTED else v for k, v in values.items()]
    return {
        "ranked": ranked[
            :12
        ],  # more than any shortlist needs, and keeps the cache small
        "gate": sum(oriented) / len(oriented),
        "values": values,
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


DEMO = [
    "Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so it syncs"
    " to my phone? Just write it up in whatever editor pops up.",
    "Can you put together a pitch deck skeleton (cover, situation overview, comps, precedent"
    " transactions, DCF, LBO) as a .pptx, using our firm-template.pptx for branding and"
    " footnoting each valuation number back to the cell it came from in the model?",
    "Post this announcement to my Mastodon account.",
]
for request in DEMO:
    wide = rank_wide(request)
    verdict = "suggest" if wide["gate"] >= GATE_THRESHOLD else "stay quiet"
    print(f'"{request[:78]}"')
    print(f"  needs a skill {wide['gate']:.2f} -> {verdict}   ({wide['seconds']}s)")
    for name, probability in wide["ranked"][:SHORTLIST]:
        print(f"    {probability:.3f}  {name:<38}{BY_NAME[name]['description']}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
needs a skill 0.75 -> suggest (0.31s)
0.990 apple-notes Manage Apple Notes via memo CLI: create, search, edit.
0.010 computer-use Drive the user's desktop in the background — clicking, ty...
0.000 concept-diagrams Generate flat, minimal educational SVG visuals as HTML.
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
needs a skill 0.76 -> suggest (0.16s)
0.700 powerpoint Create, read, edit .pptx decks, slides, notes, templates.
0.300 pptx-author Build PowerPoint decks headless with python-pptx.
0.000 chroma Embedding database for RAG and semantic search.
"Post this announcement to my Mastodon account."
needs a skill 0.78 -> suggest (0.16s)
0.550 xurl X/Twitter via xurl CLI: raw post search, posting, DM, media.
0.140 computer-use Drive the user's desktop in the background — clicking, ty...
0.080 openhands Delegate coding to OpenHands CLI (model-agnostic, LiteLLM).A solicitação do app Notas é inequívoca, e sua primeira opção é a correta. Nada que uma classificação possa fazer salvará a do Mastodon: as três perguntas indicam que uma habilidade é necessária, porque postar em uma conta é uma ação, e com uma habilidade para postar em X e nenhuma para Mastodon, a habilidade mais próxima vence de qualquer forma.
Isso deixa o deck. Ambos os líderes têm habilidades .pptx, e em 60 caracteres a pergunta ampla Choice coloca a habilidade de edição à frente da de autoria, para uma solicitação sobre autoria de um deck.
Passo 4: reclassificar os três principais
Três opções deixam espaço para a descrição completa mais a abertura de cada habilidade
SKILL.md, então o segundo pedido coloca a mesma pergunta para evidência melhor:
whiché uma perguntaChoicesobre a lista final, com esse texto mais longo como critério de cada opção.fits::{name}é uma perguntaNoulpor candidato: essa habilidade faz o específico que a solicitação pede? Cada uma é respondida por conta própria, então todas podem retornar baixas, e uma lista final cuja maior pontuação fique abaixo de 0,30 é descartada inteiramente.
RERANK_INSTRUCTIONS = (
    "Exactly one of these skills is the right one to load for the user's latest "
    "request. Which one? Read what each actually does, not just its name."
)


def rerank_criteria(names: tuple[str, ...], excerpt: int) -> dict[str, str]:
    return {
        name: f"{BY_NAME[name]['description_full']} — {BY_NAME[name]['body'][:excerpt]}"
        for name in names
    }


def rerank_questions(names: tuple[str, ...], excerpt: int) -> dict:
    questions = {
        "which": Choice(
            instructions=RERANK_INSTRUCTIONS, criteria=rerank_criteria(names, excerpt)
        )
    }
    for name in names:
        questions[f"fits::{name}"] = Noul(
            instructions=(
                f"Does the skill '{name}' do the specific thing the user's request asks "
                f"for? It is described as: {BY_NAME[name]['description_full']}"
            )
        )
    return questions


@json_cache
def rerank(request: str, names: tuple[str, ...], excerpt: int) -> dict:
    """Request 2: the same Choice over a shortlist, plus one absolute noul per candidate."""
    started = perf_counter()
    response = client.system_one(
        state=build_state(request),
        questions=rerank_questions(names, excerpt),
        model=TYPESAFE_MODEL,
    )
    return {
        "winner": response.answers["which"].choice,
        "fits": {
            key.removeprefix("fits::"): answer.noul
            for key, answer in response.answers.items()
            if key.startswith("fits::")
        },
        "seconds": round(perf_counter() - started, 2),
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


for request in DEMO:
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        print(f'"{request[:78]}"\n  scored too low, nothing suggested\n')
        continue
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    best = max(result["fits"].values())
    verdict = result["winner"] if best >= FITS_THRESHOLD else "nothing fits"
    print(f'"{request[:78]}"')
    print(f"  was {shortlist[0]} -> {verdict}   ({result['seconds']}s)")
    for name in shortlist:
        print(f"    fits {result['fits'][name]:.2f}  {name}")
    print()
"Can you save this recipe as a new note in my 'Recipes' folder in Notes.app so "
was apple-notes -> apple-notes (0.12s)
fits 0.60 apple-notes
fits 0.54 computer-use
fits 0.01 concept-diagrams
"Can you put together a pitch deck skeleton (cover, situation overview, comps, "
was powerpoint -> pptx-author (0.09s)
fits 0.73 powerpoint
fits 0.38 pptx-author
fits 0.02 chroma
"Post this announcement to my Mastodon account."
was xurl -> xurl (0.09s)
fits 0.56 xurl
fits 0.38 computer-use
fits 0.05 openhandsAs duas .pptx habilidades se separam assim que cada uma traz seu próprio texto: o pedido do baralho inverte para a habilidade de autoria.
Os fits nouls e o Choice discordam disso: os nouls avaliam a habilidade de edição como superior, enquanto o Choice escolhe a de autoria. Eles estão decidindo coisas diferentes. O Choice define qual habilidade, e os nouls definem se dizer algo ou não.
A solicitação do Mastodon sobrevive a ambas as verificações: seu melhor fits noul fica acima de 0,30, portanto a receita sugere a habilidade X para uma solicitação sobre Mastodon. A maioria das solicitações semelhantes é capturada.
A segunda passagem só pode rejeitar o que a classificação ampla lhe fornece, e aqui foram três quase-acertos.
A função abaixo é a receita completa: dois pedidos e dois limiares, com no máximo um nome de habilidade sendo retornado.
Para apontá-lo para o seu próprio roster, substitua hermes_roster.json. Cada pergunta acima lê
name, description, description_full, e body desse arquivo, e nada mais
sabe sobre Hermes.
def suggest(request: str) -> tuple[str, ...]:
    """At most one skill name for a request, or () for "nothing here applies"."""
    wide = rank_wide(request)
    if wide["gate"] < GATE_THRESHOLD:
        return ()
    shortlist = tuple(name for name, _ in wide["ranked"][:SHORTLIST])
    result = rerank(request, shortlist, EXCERPT_CHARS)
    if max(result["fits"].values()) < FITS_THRESHOLD:
        return ()
    return (result["winner"],)


def suggestion_block(names: tuple[str, ...]) -> str:
    """What gets appended after the roster, in the suggestion.

    This string is a measured input rather than prose: it goes to the agent, so it is part
    of every graded turn's cache key. Editing a word here silently invalidates the shipped
    results and costs a live re-run to restore them.
    """
    body = (
        f"Relevant to the current request: {', '.join(names)}. Ignore this if it does not "
        "fit what the user actually asked for."
        if names
        else "No skill in the roster appears relevant to this request."
    )
    return f"\n\n<skill_relevance>\n{body}\n</skill_relevance>"


print(suggestion_block(suggest(DEMO[1])))
print(suggestion_block(suggest(DEMO[2])))
<skill_relevance>
Relevant to the current request: pptx-author. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>


<skill_relevance>
Relevant to the current request: xurl. Ignore this if it does not fit what the user actually asked for.
</skill_relevance>
Passo 5: medir a sugestão
Cada um dos 488 pedidos é enviado ao agente três vezes, uma rodada medida por vez. As execuções diferem apenas no que é dito ao agente:
| o que vai no prompt do sistema | |
|---|---|
| agente sozinho | nada |
| agente com uma sugestão | o que quer que suggest() retorne |
| agente com a resposta | o nome da habilidade de cobertura, ou “nada se aplica” quando não há |
O terceiro não é alcançável; é o teto contra o qual os outros dois são medidos.
A redação dessa sugestão está fazendo dois trabalhos. Ela diz que a sugestão pode ser ignorada, porque pressionar mais vence a conformidade em sugestões erradas também, e uma errada é pior do que nenhuma. E uma rodada sem nada para sugerir ainda envia uma frase dizendo isso; enviar nada deixaria a instrução própria do roster de “errar pelo lado de carregar” sem oposição.
texts = [request["text"] for request in REQUESTS]
with ThreadPoolExecutor(max_workers=WORKERS) as pool:  # up to 488 x 2 TypeSafe requests
    suggested = dict(zip(texts, pool.map(suggest, texts)))
WIDE = {text: rank_wide(text) for text in texts}  # all cache hits now; reused below

arms = {
    "baseline": {},
    "TypeSafe": {
        request["text"]: suggestion_block(suggested[request["text"]])
        for request in REQUESTS
    },
    "oracle": {
        request["text"]: suggestion_block((request["gold"],) if request["gold"] else ())
        for request in REQUESTS
    },
}
scores = {
    arm: summarise(run_arm(arm, suggestions)) for arm, suggestions in arms.items()
}

print(f"{'run':<10}{'wrong loads':>13}{'needless loads':>16}")
for arm, row in scores.items():
    print(f"{arm:<10}{row['wrong_load']:>13.1%}{row['needless_load']:>16.1%}")


def fewer(metric: str) -> str:
    """The plain ratio between the two arms' error rates."""
    return f"{scores['baseline'][metric] / scores['TypeSafe'][metric]:.1f}x fewer"


print(
    f"\nbaseline -> TypeSafe:  {fewer('wrong_load')} wrong loads, "
    f"{fewer('needless_load')} needless ones"
)
run wrong loads needless loads
baseline 16.8% 9.8%
TypeSafe 7.3% 4.0%
oracle 2.5% 1.2%
baseline -> TypeSafe: 2.3x fewer wrong loads, 2.4x fewer needless onesmoved = [
(
baseline[p["text"]]["loaded"][:1] == [p["gold"]],
run_turn(AGENT_MODEL, "TypeSafe", p["text"], arms["TypeSafe"][p["text"]])[
"loaded"
][:1]
== [p["gold"]],
)
for p in POSITIVES
]
print(
f"of {len(POSITIVES)} covered requests: {sum(not b and a for b, a in moved)} the suggestion "
f"fixed, {sum(b and not a for b, a in moved)} it broke"
)of 315 covered requests: 37 the suggestion fixed, 7 it brokeA sugestão corrige muito mais solicitações do que quebra, mas ela de fato quebra algumas que o agente já tinha acertado por conta própria. Uma sugestão errada, mas confiante, é mais persuasiva do que nenhuma sugestão, que é o preço de colocá-la antes da virada.
SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

ARM_COLOR = {"baseline": BLUE, "TypeSafe": ORANGE, "oracle": MUTED}


def style(ax):
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)


panels = [
    ("wrong_load", f"wrong loads\n{len(POSITIVES)} covered requests"),
    ("needless_load", f"needless loads\n{len(NEGATIVES)} uncovered requests"),
]
names = list(scores)
fig, axes = plt.subplots(1, 2, figsize=(8.4, 3.6), facecolor=SURFACE)
for ax, (metric, title) in zip(axes, panels):
    style(ax)
    ax.grid(axis="y", color=GRID, linewidth=0.8)
    values = [scores[arm][metric] for arm in names]
    bars = ax.bar(
        names,
        values,
        0.58,
        color=[ARM_COLOR[arm] for arm in names],
        # the oracle is a ceiling, not a competitor: gray, and hatched so it never depends
        # on colour alone
        hatch=["", "", "///"],
        edgecolor=SURFACE,
        linewidth=1.2,
    )
    ax.bar_label(
        bars,
        labels=[f"{v:.1%}" for v in values],
        padding=3,
        color=INK2,
        fontsize=9,
    )
    ax.set_title(title, loc="left", color=INK2, fontsize=9.5)
    ax.set_ylim(0, max(values) * 1.28)
    ax.yaxis.set_major_formatter(PercentFormatter(xmax=1, decimals=0))
    ax.set_ylabel("% of those requests - lower is better", color=INK2, fontsize=9)
fig.suptitle(
    f"Hermes' {len(ROSTER)}-skill roster, {len(REQUESTS)} requests, {AGENT_MODEL}",
    x=0.02,
    ha="left",
    color=INK,
    fontsize=11,
)
fig.tight_layout()
display(fig)
plt.close(fig)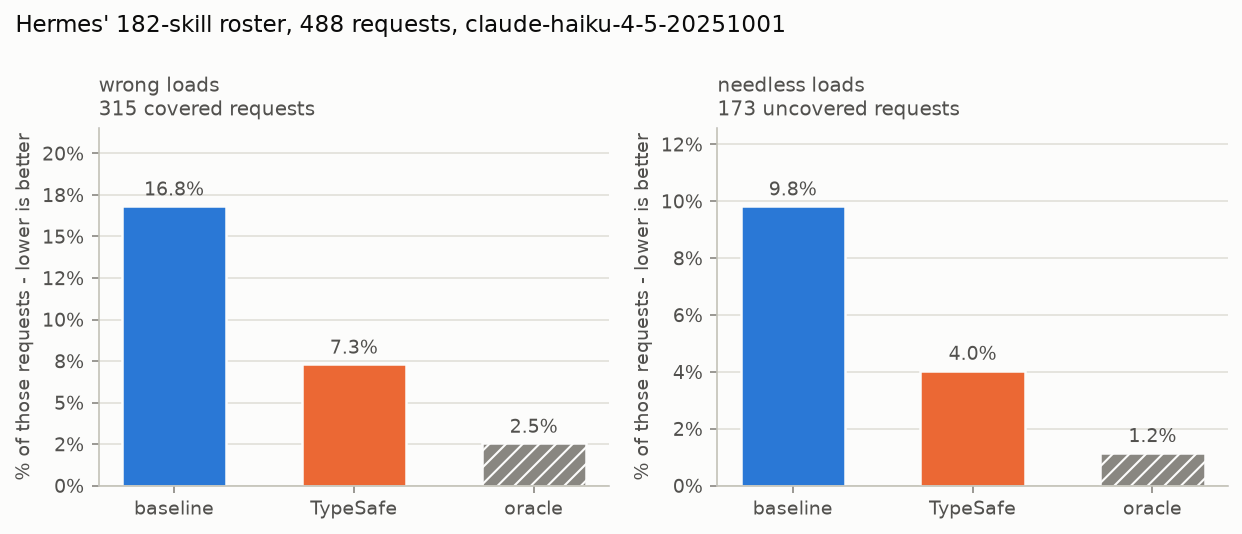
O que os resultados mostram
- Cargas erradas caíram de 16,8% para 7,3% e desnecessárias de 9,8% para 4,0%, o que representa a maior parte da diferença entre adivinhar a partir de um índice truncado e receber a resposta.
- Algumas solicitações que o agente acertava sozinho voltaram a ficar erradas quando uma sugestão foi anexada. As contagens estão acima.
Copie esta forma quando um agente seu tiver um grande número de tarefas: uma classificação rápida de tudo, seguida de uma análise detalhada de duas ou três. Cada etapa pode não retornar resultados.
Abra-o no playground
Crie um link para o playground do deck solicitado na etapa 4, usando a descrição completa e o trecho do corpo de cada candidato como seus critérios.
demo_shortlist = tuple(name for name, _ in rank_wide(DEMO[1])["ranked"][:SHORTLIST])
playground_link = make_playground_link(
    build_state(DEMO[1]),
    rerank_questions(demo_shortlist, EXCERPT_CHARS),
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open the shortlist + questions in the TypeSafe playground]({playground_link})"
    )
)
Abra a lista curta + perguntas no playground TypeSafe →
O que vem a seguir
A mesma forma aparece em outros lugares: Roteamento de Intenção para rotear para um manipulador em vez de uma habilidade, Confiança para escolher os dois limiares, e Expansão Especulativa para colocar cada pergunta em uma única solicitação.